第 8 章 / 共 14 章
持久化:checkpointer、thread 与时间旅行
8.1 「明天再批」这四个字的技术含量
客服主管说:超过 500 的退款我来批,但我可能明天上午才看。
翻译成技术要求:这段流程要在某一步停住,进程可以关掉、可以重启、可以换一台机器,明天还能从停住的那一步继续,而且前面查到的订单信息、模型的推理过程一样都不能丢。
你自己实现的话,要做三件事:把 state 序列化落库、记住停在哪个节点、恢复时把 state 读回来并跳到那个节点。这三件事加起来就是 checkpointer。
8.2 加一行就有
from langgraph.checkpoint.memory import InMemorySaver

graph = builder.compile(checkpointer=InMemorySaver())

config = {"configurable": {"thread_id": "ticket-4821"}}
graph.invoke({"steps": [], "amount": 0.0}, config)
thread_id 是一段独立会话的标识。同一个 thread_id 的多次调用共享同一份状态历史,不同 thread_id 之间完全隔离。对退款助手来说,一条工单一个 thread。
三种 saver 的选择:
| Saver | 装在哪 | 用在哪 |
|---|---|---|
InMemorySaver | 随 langgraph 一起装 | 试验、单元测试 |
SqliteSaver | uv add langgraph-checkpoint-sqlite | 本地开发、单机小工具 |
PostgresSaver | uv add langgraph-checkpoint-postgres | 生产 |
ModuleNotFoundError: No module named 'langgraph.checkpoint.sqlite'很多教程写 from langgraph.checkpoint.sqlite import SqliteSaver 却不提要单独装包。
8.3 状态历史长什么样
跑完一次带中断的流程之后(完整例子在第 9 章),读它的历史:
for snap in graph.get_state_history(config):
    print(len(snap.values["steps"]), snap.next, snap.config["configurable"]["checkpoint_id"][:8])
真实输出(新 → 旧):
3  ()             1f1a9f95
2  ('publish',)   1f1a9f95
1  ('review',)    1f1a9f95
0  ('write',)     1f1a9f95
0  ('__start__',) 1f1a9f95
每一行是一个 checkpoint。next 是下一步该跑哪个节点——最上面那条 next=() 表示已经跑完了。
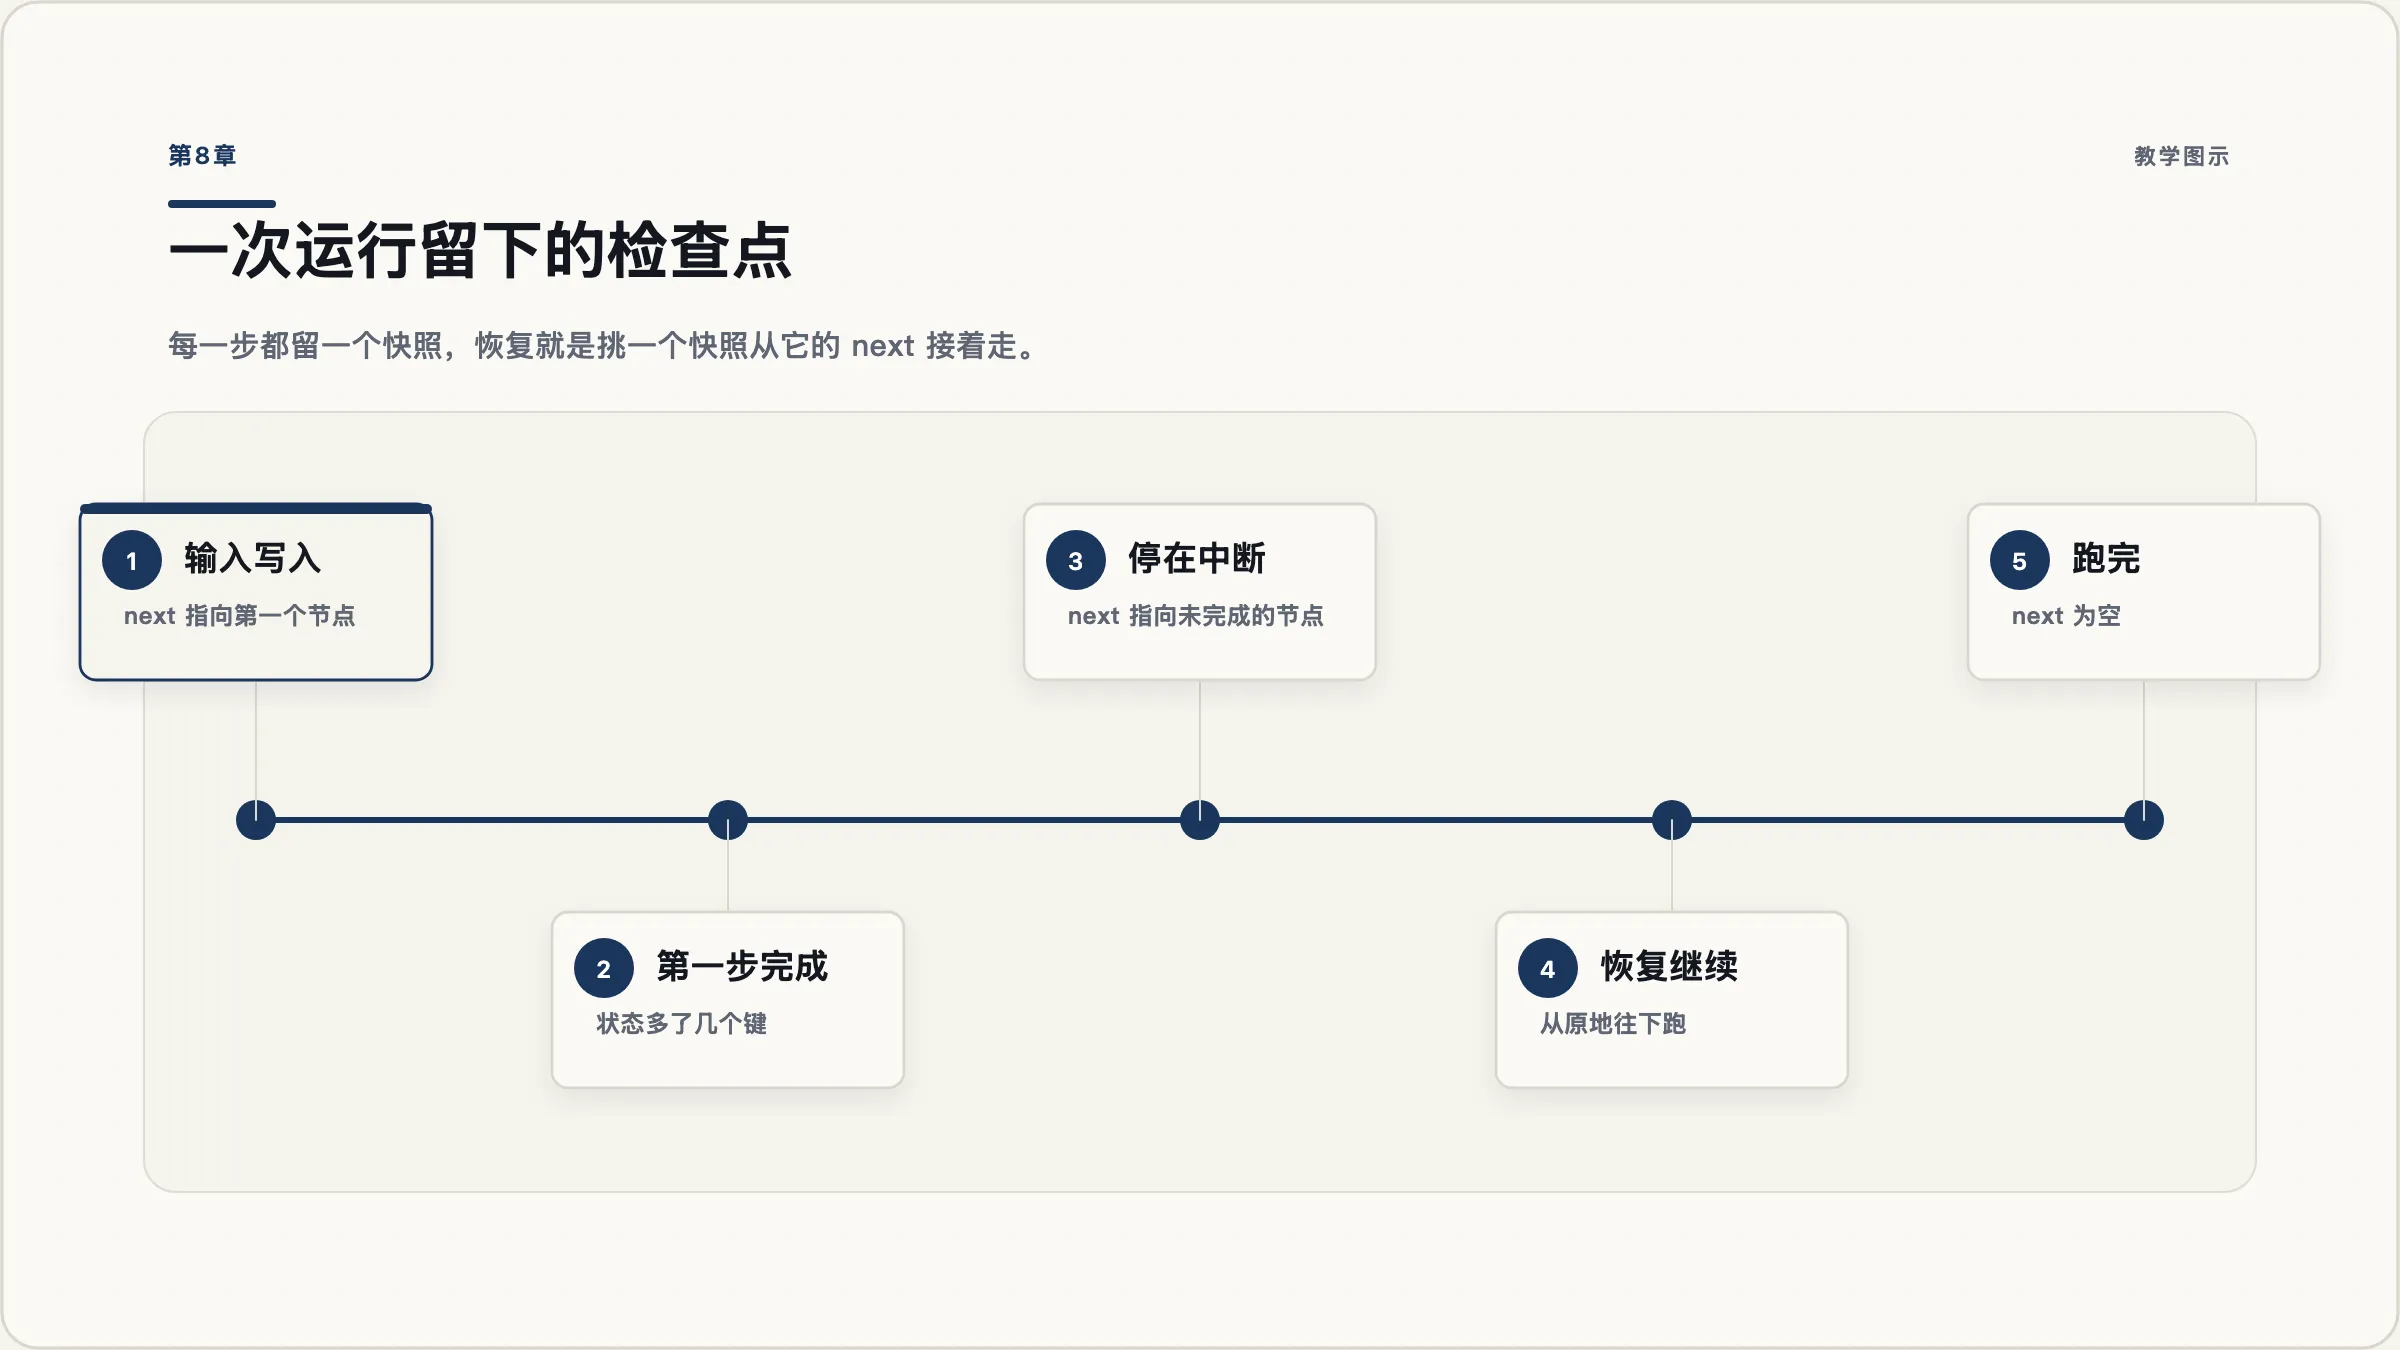
next 为空表示跑完;next 有值表示停在那里等着继续。恢复的本质就是挑一个检查点,从它的 next 接着走。get_state(config) 拿最新的那个,返回一个 StateSnapshot,常用的三个字段是 values(当前状态)、next(下一步)、interrupts(如果停在中断上)。
8.4 时间旅行,以及一个必须知道的陷阱
「回到某一步重跑」的用途很实在:模型在第三步判错了,你想改一下输入从第三步重来,而不是整条工单重跑。
拿到目标检查点的 config 就能重放:
history = list(graph.get_state_history(config))
target = [h for h in history if h.next == ("review",)][-1]
graph.invoke(None, target.config) # 从这一步接着跑但这里有个陷阱,本机实测到的。如果那一步是个人工审批中断,你想换个答案重跑:
graph.invoke(Command(resume="no"), target.config)结果是 approved: True —— 你传的 "no" 没有生效,沿用了原来那次的 "yes"。
对照实验:在一个全新的 thread 上传 resume="no",得到的是 approved: False。所以不是 resume 值本身的问题,而是那个历史检查点上已经挂着上次运行的写入记录,重放时直接用了旧值。
正确做法是先分叉出一个新检查点:
fork = graph.update_state(target.config, None)   # 分叉,不改任何值
graph.invoke(Command(resume="no"), fork) # 这次是 approved: False ✅| 做法 | 传入 | 实测结果 |
|---|---|---|
| 直接用历史 config 重放 | resume="no" | approved: True(旧值) |
先 update_state 分叉再重放 | resume="no" | approved: False(正确) |
记住这条判据:重放(replay)只是「再跑一遍同样的路」,分叉(fork)才是「换一个答案走另一条路」。要换答案,必须先 update_state。
update_state(config, values, as_node=...) 也可以直接改状态值,as_node 用来指定「假装是哪个节点写的」,从而决定接下来走哪条边。
8.5 改了图,老会话还能恢复吗
这是上线之后一定会遇到的问题。官方的规则很具体:
- 已经跑完的线程(没有中断):你可以改整张图的拓扑——增删改节点和边都行。
- 正停在中断上的线程:除了重命名和删除节点之外的改动都支持。(因为那条线程正准备进入某个节点,节点没了就无处可去。)
- state 增删键:完全向前向后兼容。
- state 重命名键:已有线程会丢掉那个键的历史值。
- state 键的类型不兼容地改变:可能让旧线程出问题。
实践含义:上线前把 state 的键名想清楚。加字段随时可以,改名的代价是所有在途会话丢数据。
8.6 持久化不是免费的
第 11 章会展开讲成本,这里先埋一个数字:社区有人提了一个仍然开着的 issue,实测报告 checkpoint 序列化带来约 85% 的存储膨胀和 37.8% 的 token 开销(这是报告者自己的测量,官方未确认)。
结论不是「别用 checkpointer」,而是:state 里放什么,直接决定了持久化的代价。第 6.5 节那三条经验在这里兑现。
另外,invoke / stream 上有个 durability 参数,取值是 'sync' / 'async' / 'exit'(本机实测确认)——分别是每步同步落盘、异步落盘、只在退出时落盘。落盘越勤,崩溃时丢得越少,但也越慢。