第 10 章 / 共 14 章
流式:该给用户看什么,该给工程师看什么
10.1 「它好像卡住了」
退款助手接进客服后台之后,第一条反馈通常是:点了提交之后转圈十几秒,不知道它在干嘛,客服会以为系统挂了。
这不是性能问题,是可见性问题。一次 agent 运行内部可能有五次模型调用和八次工具调用,但外面只看到一个 invoke() 在阻塞。
stream() 的作用就是把这个黑盒打开。难点不在于怎么调用它,而在于打开之后你会拿到七种不同的东西,得知道要哪一种。
10.2 七种模式
(下表来自官方文档,形状为本机实测确认。)
| 模式 | 产出什么 | 谁该订阅 |
|---|---|---|
values | 每一步之后的完整状态 | 需要随时展示全貌的界面 |
updates | 每一步的状态增量,键是节点名 | 进度条、步骤列表 |
messages | 模型的 token 流 + 元数据 | 打字机效果 |
custom | 节点里用 get_stream_writer() 主动推的数据 | 「正在查订单…」这类业务进度 |
checkpoints | 检查点事件(需要 checkpointer) | 审计、状态机可视化 |
tasks | 任务开始/结束事件,含结果与错误 | 调试、性能分析 |
debug | checkpoints + tasks 加额外元数据 | 排障 |
前两种的实测输出对比最能说明问题:
--- stream_mode="updates" ---
{'a': {'steps': ['a'], 'n': 2}}
{'b': {'steps': ['b'], 'n': 4}}

--- stream_mode="values" ---
{'steps': [], 'n': 1}
{'steps': ['a'], 'n': 2}
{'steps': ['a', 'b'], 'n': 4}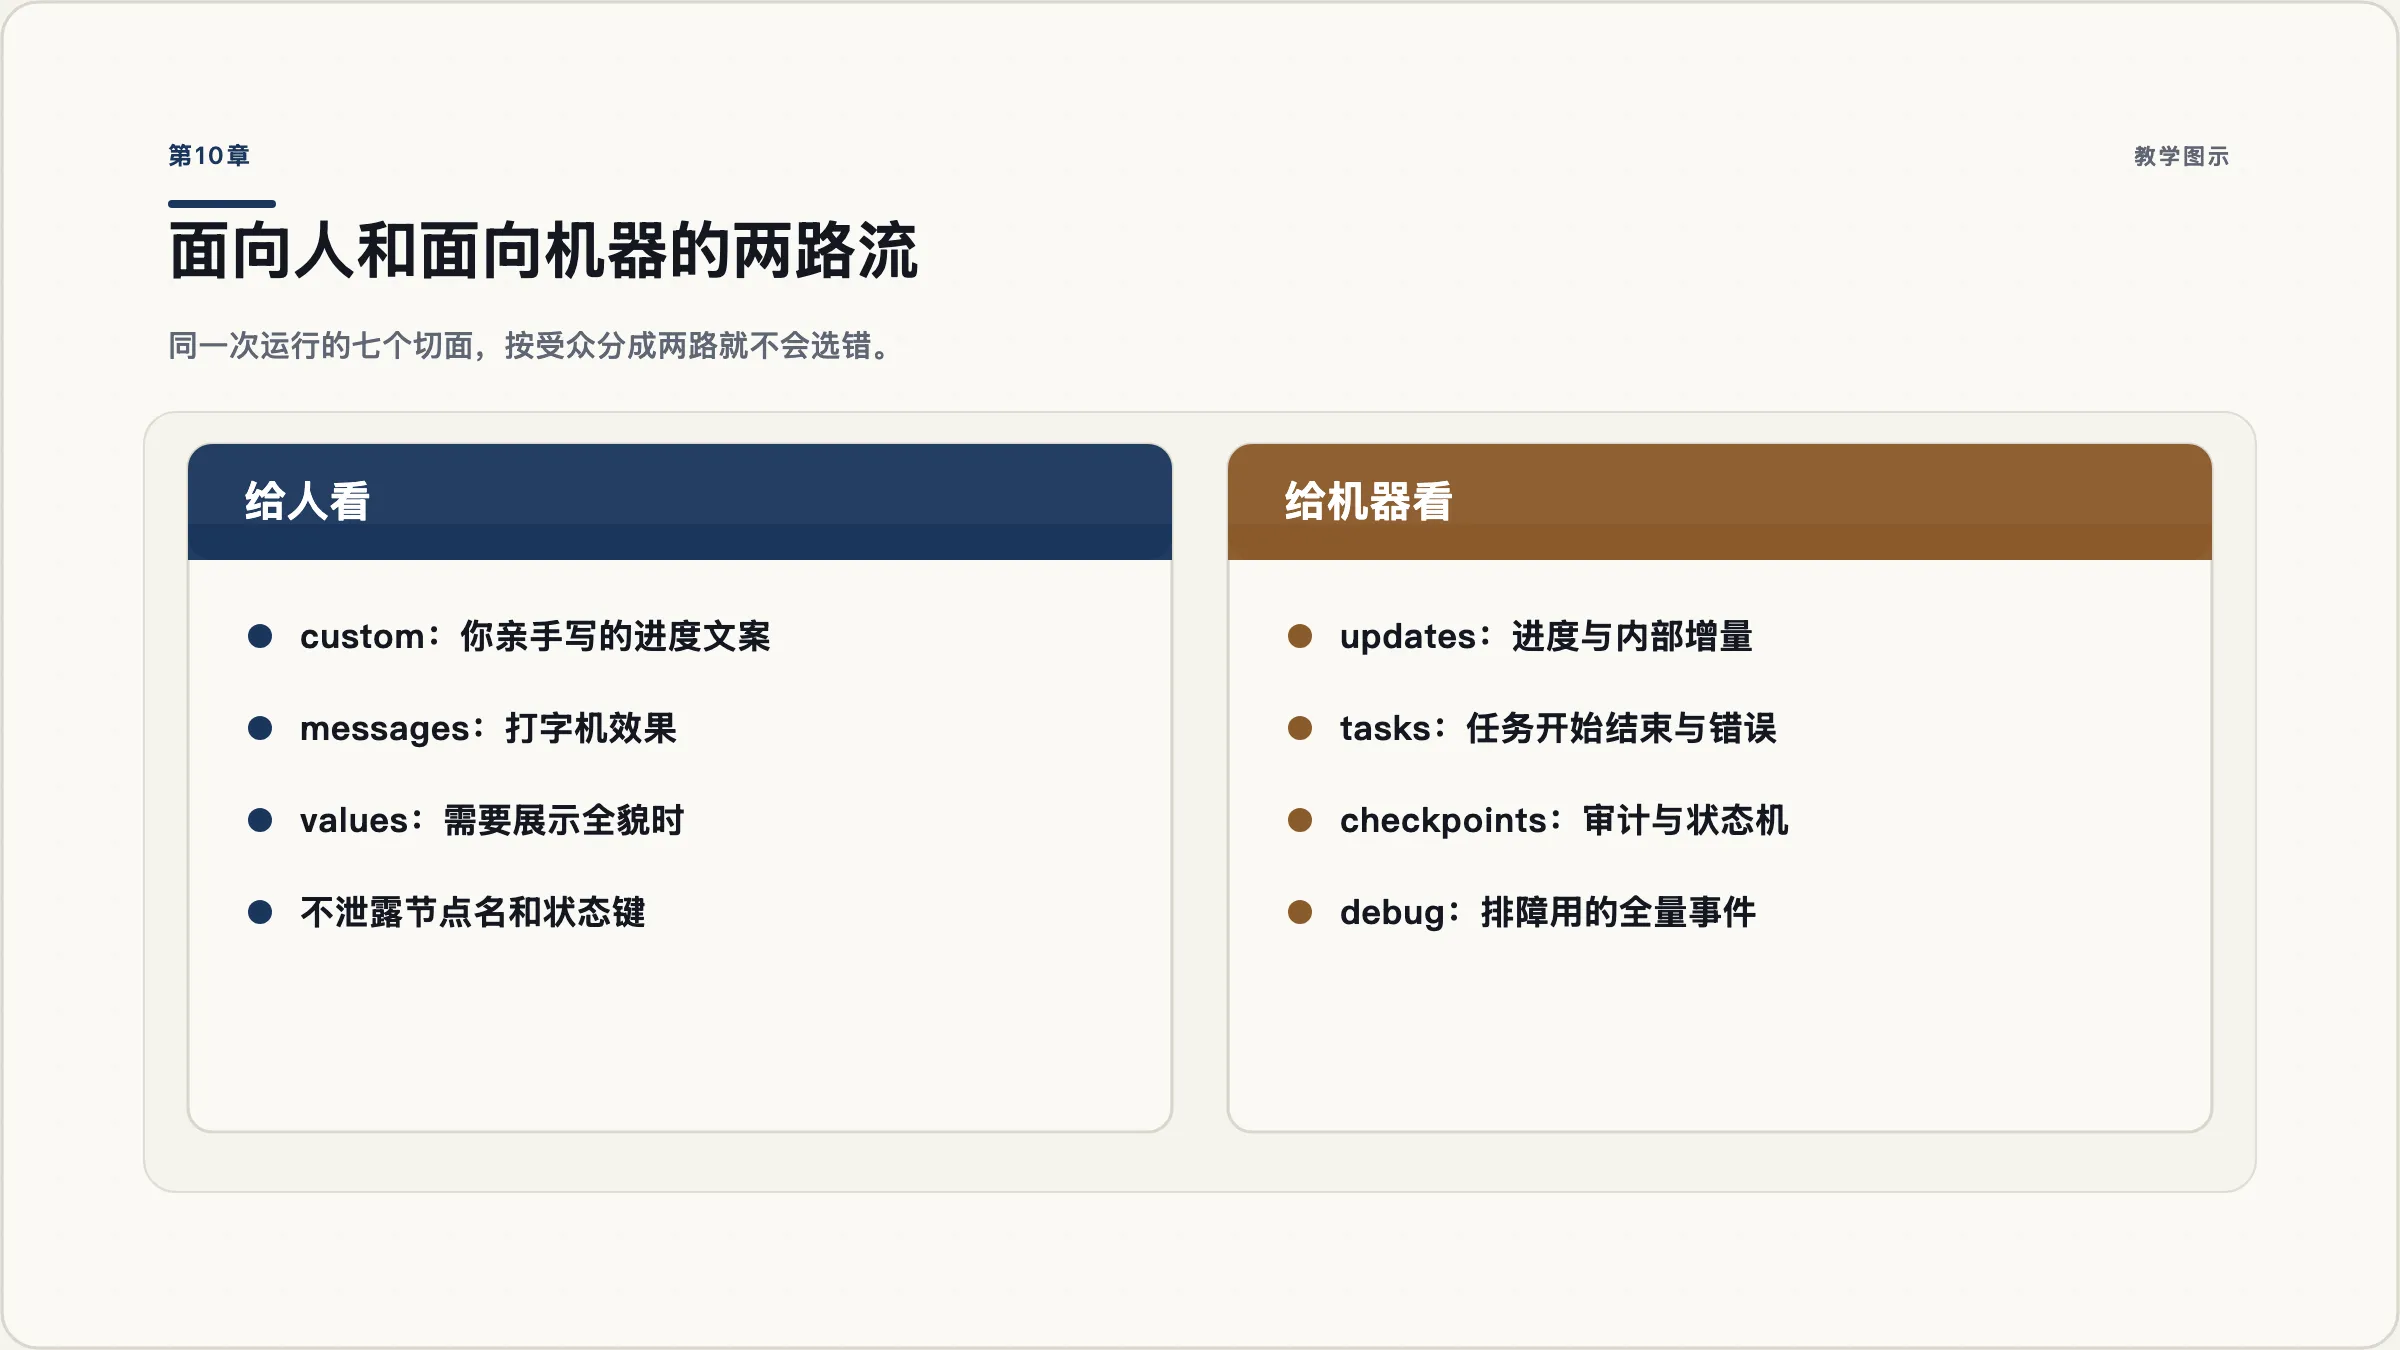
10.3 一次订阅多种,以及输出形状的变化
传一个列表就能同时订阅多种:
for mode, chunk in graph.stream(inputs, stream_mode=["updates", "values"]):
    print(mode, chunk)
实测输出变成了二元组:
values {'steps': [], 'n': 1}
updates {'a': {'steps': ['a'], 'n': 2}}
values {'steps': ['a'], 'n': 2}
...这就是那个让人头疼的地方:单模式返回裸数据,多模式返回 (mode, data) 元组,开了子图又变成 (namespace, data) 元组。同一个 for 循环,形状取决于你传了什么参数。
1.1 起有了统一格式,加一个参数:
for chunk in graph.stream(inputs, stream_mode=["updates", "custom"], version="v2"):
    print(chunk)
实测输出:
{'type': 'custom',  'ns': (), 'data': {'status': 'working'}}
{'type': 'updates', 'ns': (), 'data': {'a': {'steps': ['a']}}}
永远是 {"type", "ns", "data"} 三个键,跟模式数量和子图设置无关。新代码建议直接上 version="v2",但要知道默认值仍然是 v1——所以你读到的绝大多数示例代码是 v1 形状的。
另外从 1.2 起,官方对新应用推荐的是另一套 API:事件流(event streaming),它给每种投影一个独立的迭代器,不用在一个循环里分支判断。它的 version="v3" 目前被官方标为 experimental,所以本教程主线仍用 stream()。
10.4 用 custom 推业务进度
updates 推的是状态变化,但用户想看的是人话。用 get_stream_writer():
from langgraph.config import get_stream_writer

def fetch_order(state):
    writer = get_stream_writer()
    writer({"status": "正在查询订单…"})
    order = api.get(state["order_id"])
    writer({"status": f"订单已找到,金额 {order.amount} 元"})
    return {"amount": order.amount}
实测确认这些消息以 {'type': 'custom', 'ns': (), 'data': {...}} 的形式流出来。
这是给终端用户看的那一路。它和 updates 的关键差别是:updates 泄露内部结构(节点名、状态键名),custom 是你亲手写的文案。前端展示用 custom,内部监控用 updates。
10.5 子图里发生的事
默认情况下子图内部的步骤不会流出来。打开 subgraphs=True:
for ns, chunk in graph.stream(inputs, stream_mode="updates", subgraphs=True):
    print(ns, chunk)
实测输出:
()                        {'p1':    {'log': ['parent']}}
('child:7d482543-...',)   {'s1':    {'log': ['sub-1']}}
() {'child': {'log': ['parent', 'sub-1']}}第一个元素是命名空间:空元组是父图,带前缀的是子图内部。这个参数在排查「子 agent 到底做了什么」时几乎是必需的——第 6.4 节那个重复累加的坑,就是靠它看出来的。
10.6 流式里的坑
社区目前仍开着一批和流式相关的 issue,值得知道它们存在(均为报告者视角,不代表官方结论):
- 并行节点 + 自定义流 +
subgraphs=True组合时,错误处理器已经跑了但原异常仍然抛出。 - 工具函数里调用
interrupt()时,在工具流上被报成tool-error,结构化的中断信息丢失。 - 异步工具里不支持
get_stream_writer()的自定义事件。 invoke(version="v2")在stream_mode不是"values"时,返回类型会变。
实践建议:流式相关的行为,在你自己的组合下实测一遍再上线。这一块的组合空间很大,文档不可能覆盖所有交叉情况。
另外还有一条和成本相关的:流式模式下的 token 计数曾被报告不准确(issue 仍开着)。如果你靠 usage_metadata 算钱,不要只在流式路径上统计。