第 12 章 / 共 14 章
看得见才改得动:追踪与评估
12.1 「昨天有一单判错了」
这句话是整个 agent 工程里最难回答的一句。因为你要回答的不是「哪一行代码写错了」,而是「在那次运行的第几步、模型看到了什么、于是做了什么决定」。
第 10 章的流式能让你当场看见,但它不留存。你需要的是把每一次运行的每一步都记下来——这就是追踪(tracing)。
官方的方案是 LangSmith。它和这两个库是同一家公司的产品,接入成本极低:
export LANGSMITH_TRACING=true
export LANGSMITH_API_KEY=lsv2_...
export LANGSMITH_PROJECT=refund-agent
设完这三个环境变量,用 LangChain / LangGraph 写的代码不用改一行,运行轨迹就会上报。
版本提醒:老教程里那个 LANGCHAIN_TRACING_V2 变量,在当前文档页面上已经完全不出现了。当前的前缀是 LANGSMITH_。
不在框架里的代码用装饰器补:
from langsmith import traceable

@traceable(run_type="tool")
def call_order_api(order_id: str):
...声明:写作环境没有 LangSmith API key,本节的接入过程未经本机实测,环境变量名与 API 形状均照抄当天官方文档。
12.2 追踪要看的三件事
接上之后,一次运行会变成一棵树。看它的时候,按这个顺序问三个问题:
- 模型那一步收到的完整输入是什么? 这是排查「它为什么这么判断」的唯一入口。90% 的「模型犯蠢」最后都是上下文里少了或多了什么。
- 哪一步最慢? 通常不是模型,是某个串行的外部调用。
- token 花在哪一步? 对照第 11.4 节那四个来源。
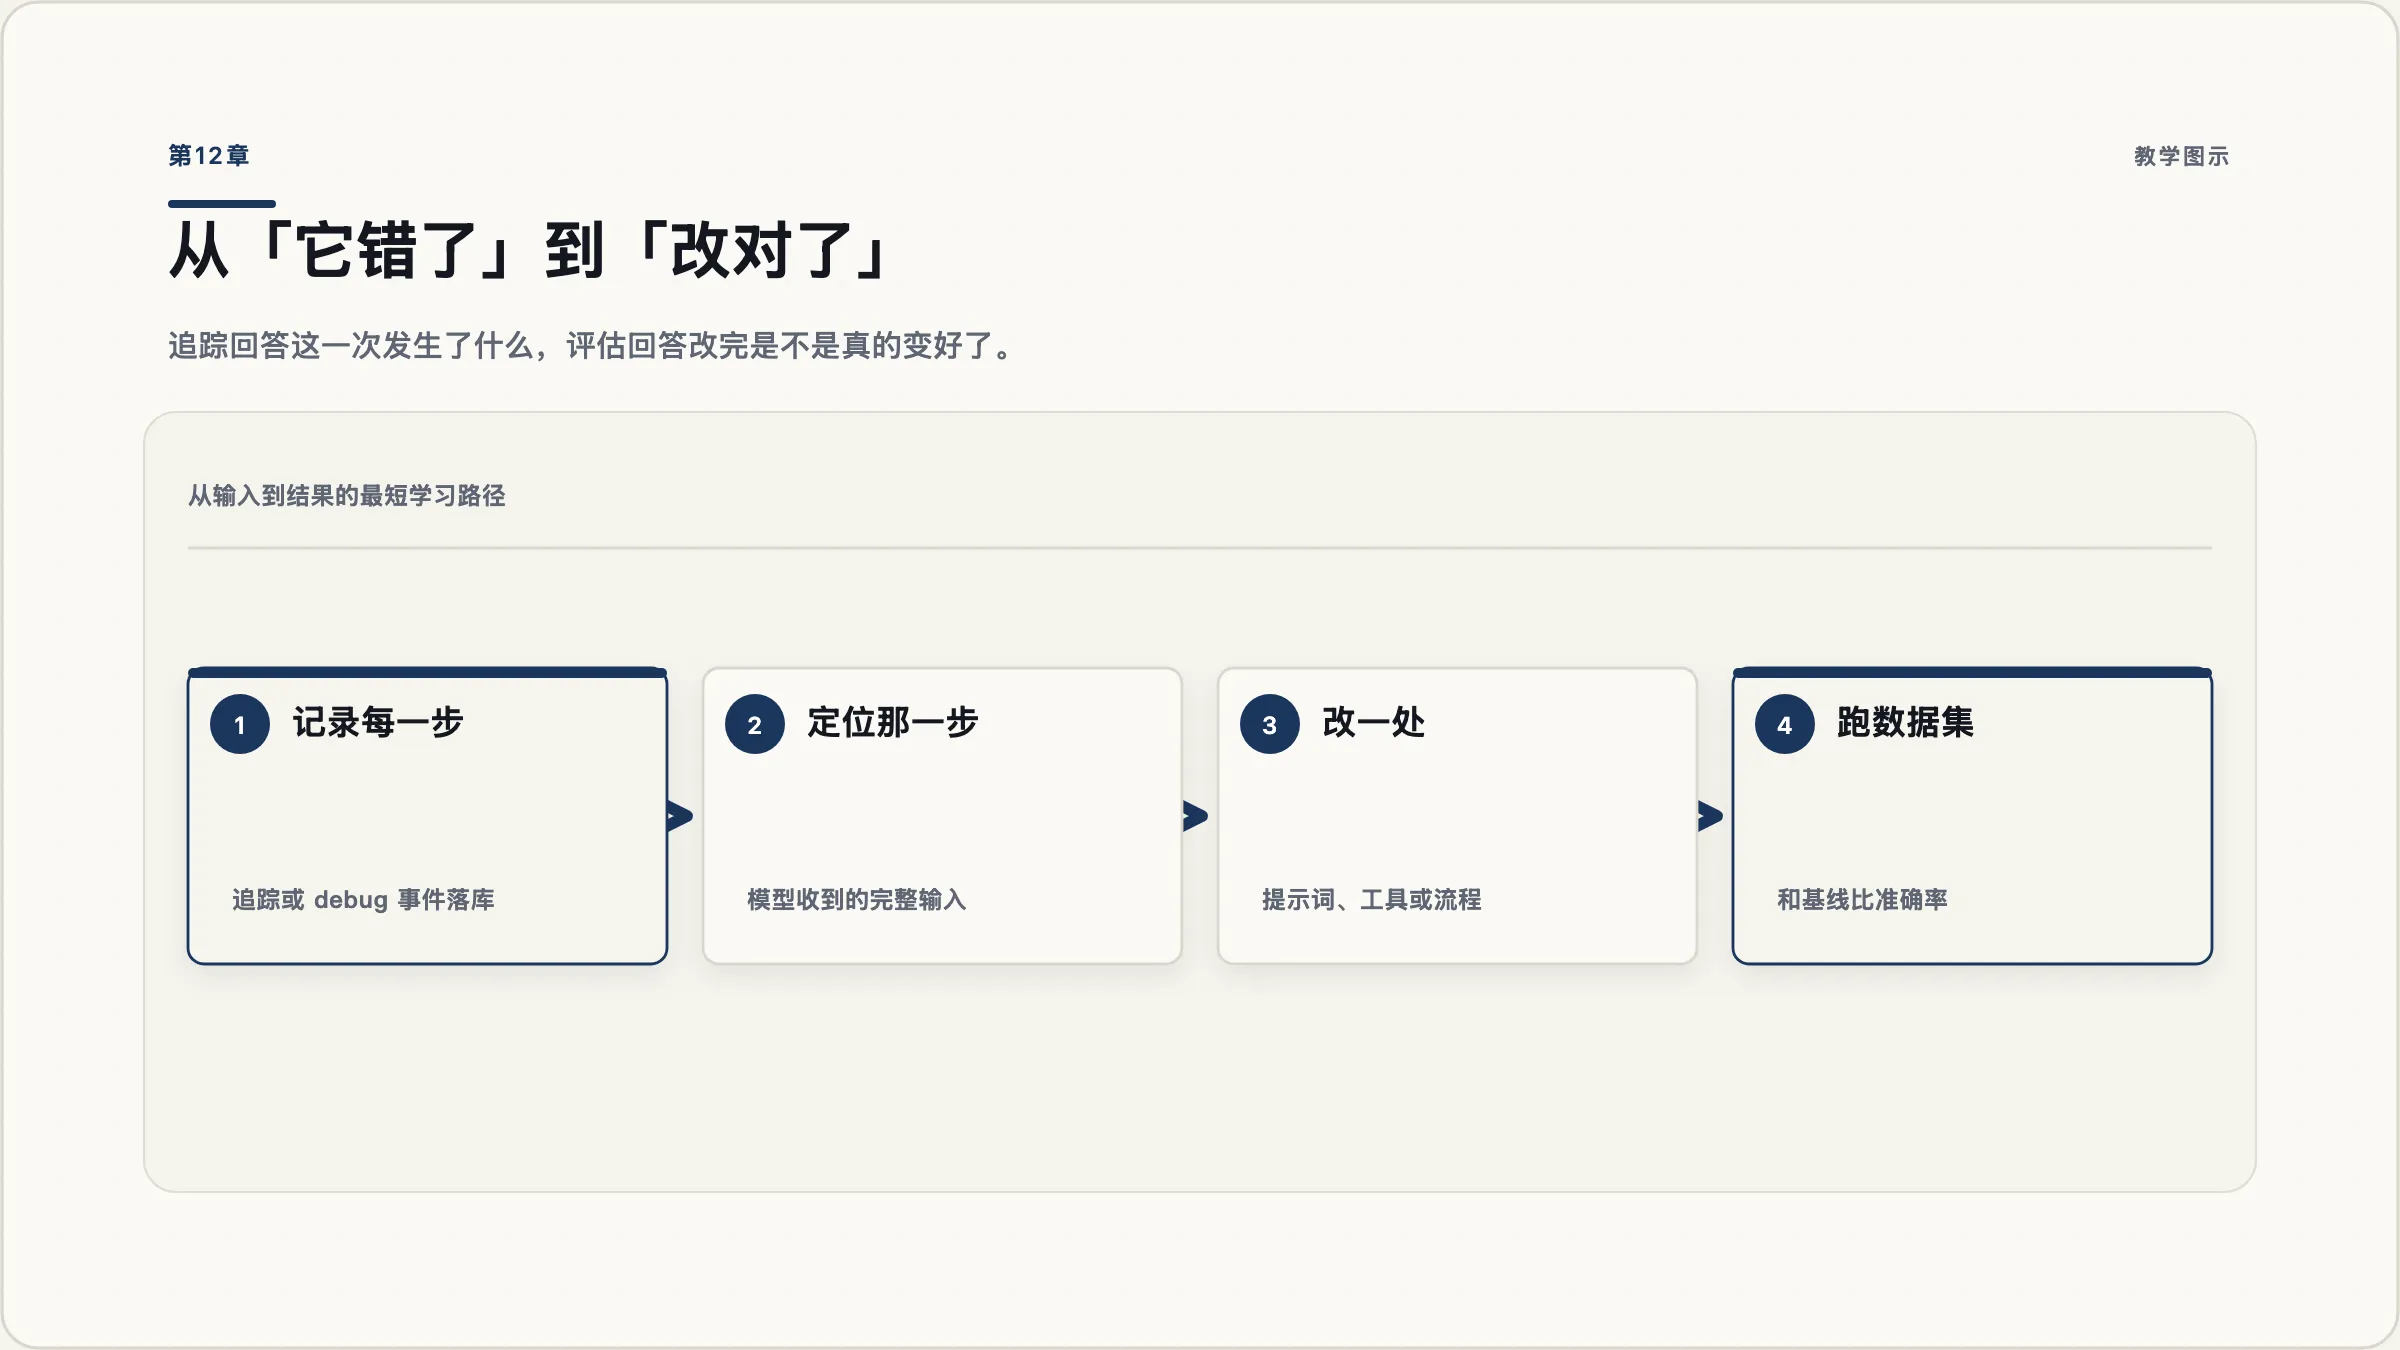
12.3 从追踪到评估
追踪回答「这一次发生了什么」,评估回答「改完之后是不是真的变好了」。
评估的三个零件:数据集(一批输入 + 期望输出)、目标函数(你的 agent)、评估器(怎么判分)。
from langsmith import Client

client = Client()

dataset = client.create_dataset("refund-tickets")
client.create_examples(
    dataset_id=dataset.id,
    examples=[
        {"inputs": {"ticket": "杯子有裂纹,订单 ORD-...123"},
         "outputs": {"should_refund": True, "amount": 89.0}},
        # ...
    ],
)

def correctness(inputs: dict, outputs: dict, reference_outputs: dict) -> bool:
    return outputs["should_refund"] == reference_outputs["should_refund"]

results = client.evaluate(
    lambda inputs: agent.invoke({"messages": [{"role": "user", "content": inputs["ticket"]}]}),
    data="refund-tickets",
    evaluators=[correctness],
    max_concurrency=2,
)评估器的签名是固定的三个参数:(inputs, outputs, reference_outputs)。异步版本是 aevaluate()。用模型当裁判(LLM-as-a-judge)走另一个包 openevals。
从哪来的数据集:最省事的做法是从生产追踪里挑。挑三类——判对的典型例、判错的、以及人工改过结论的。第三类最值钱,因为它自带正确答案。
12.4 费用与自托管
定价页当天写着的数字(照抄页面,动手前请自行核对):
| 档位 | 价格 | 免费追踪额度 | 席位 |
|---|---|---|---|
| Developer | $0 | 5,000 条 base traces / 月 | 最多 1 个 |
| Plus | $39 / 席位 / 月 | 10,000 条 base traces / 月 | 多席位 |
保留期:base 追踪 14 天,扩展保留 400 天。超出免费额度之后的每千条单价,官方定价页当天没有给出,所以本教程不写这个数字——要做预算请直接问销售或看你账号的账单页。
自托管这一点要说清楚:自托管的 LangSmith 是 Enterprise 方案的加购项,需要向销售申请 license key,不是开源产品。开源的只有客户端 SDK。
如果你不想或不能上云,这一节的替代路径是:
- LangGraph 框架本身是 MIT 的,追踪能力不是它的一部分——你可以用
stream_mode="debug"(第 10 章)把每一步的输入输出落到自己的日志系统。 - 评估这件事不依赖任何平台:一个 JSONL 数据集 + 一个跑循环的脚本 + 几个断言函数,就是一套能用的评估。平台省掉的是可视化和协作,不是方法。