第 11 章 / 共 14 章
会崩、会慢、会贵:四道防线
11.1 上线两周之后的三张账单
退款助手跑起来之后,你会陆续收到三种投诉:
- 会崩:订单接口偶尔 500,整条工单直接失败。
- 会慢:同一个订单被查了四次,每次两秒。
- 会贵:一条工单的成本比预估高了一个量级。
这三件事分别有对应的工具,而且都在 add_node 的参数上。先看完整签名(本机实测):
add_node(node, action=None, *, defer=False, metadata=None, input_schema=None,
         retry_policy=None, cache_policy=None, error_handler=None,
         destinations=None, timeout=None, trace_policy=None)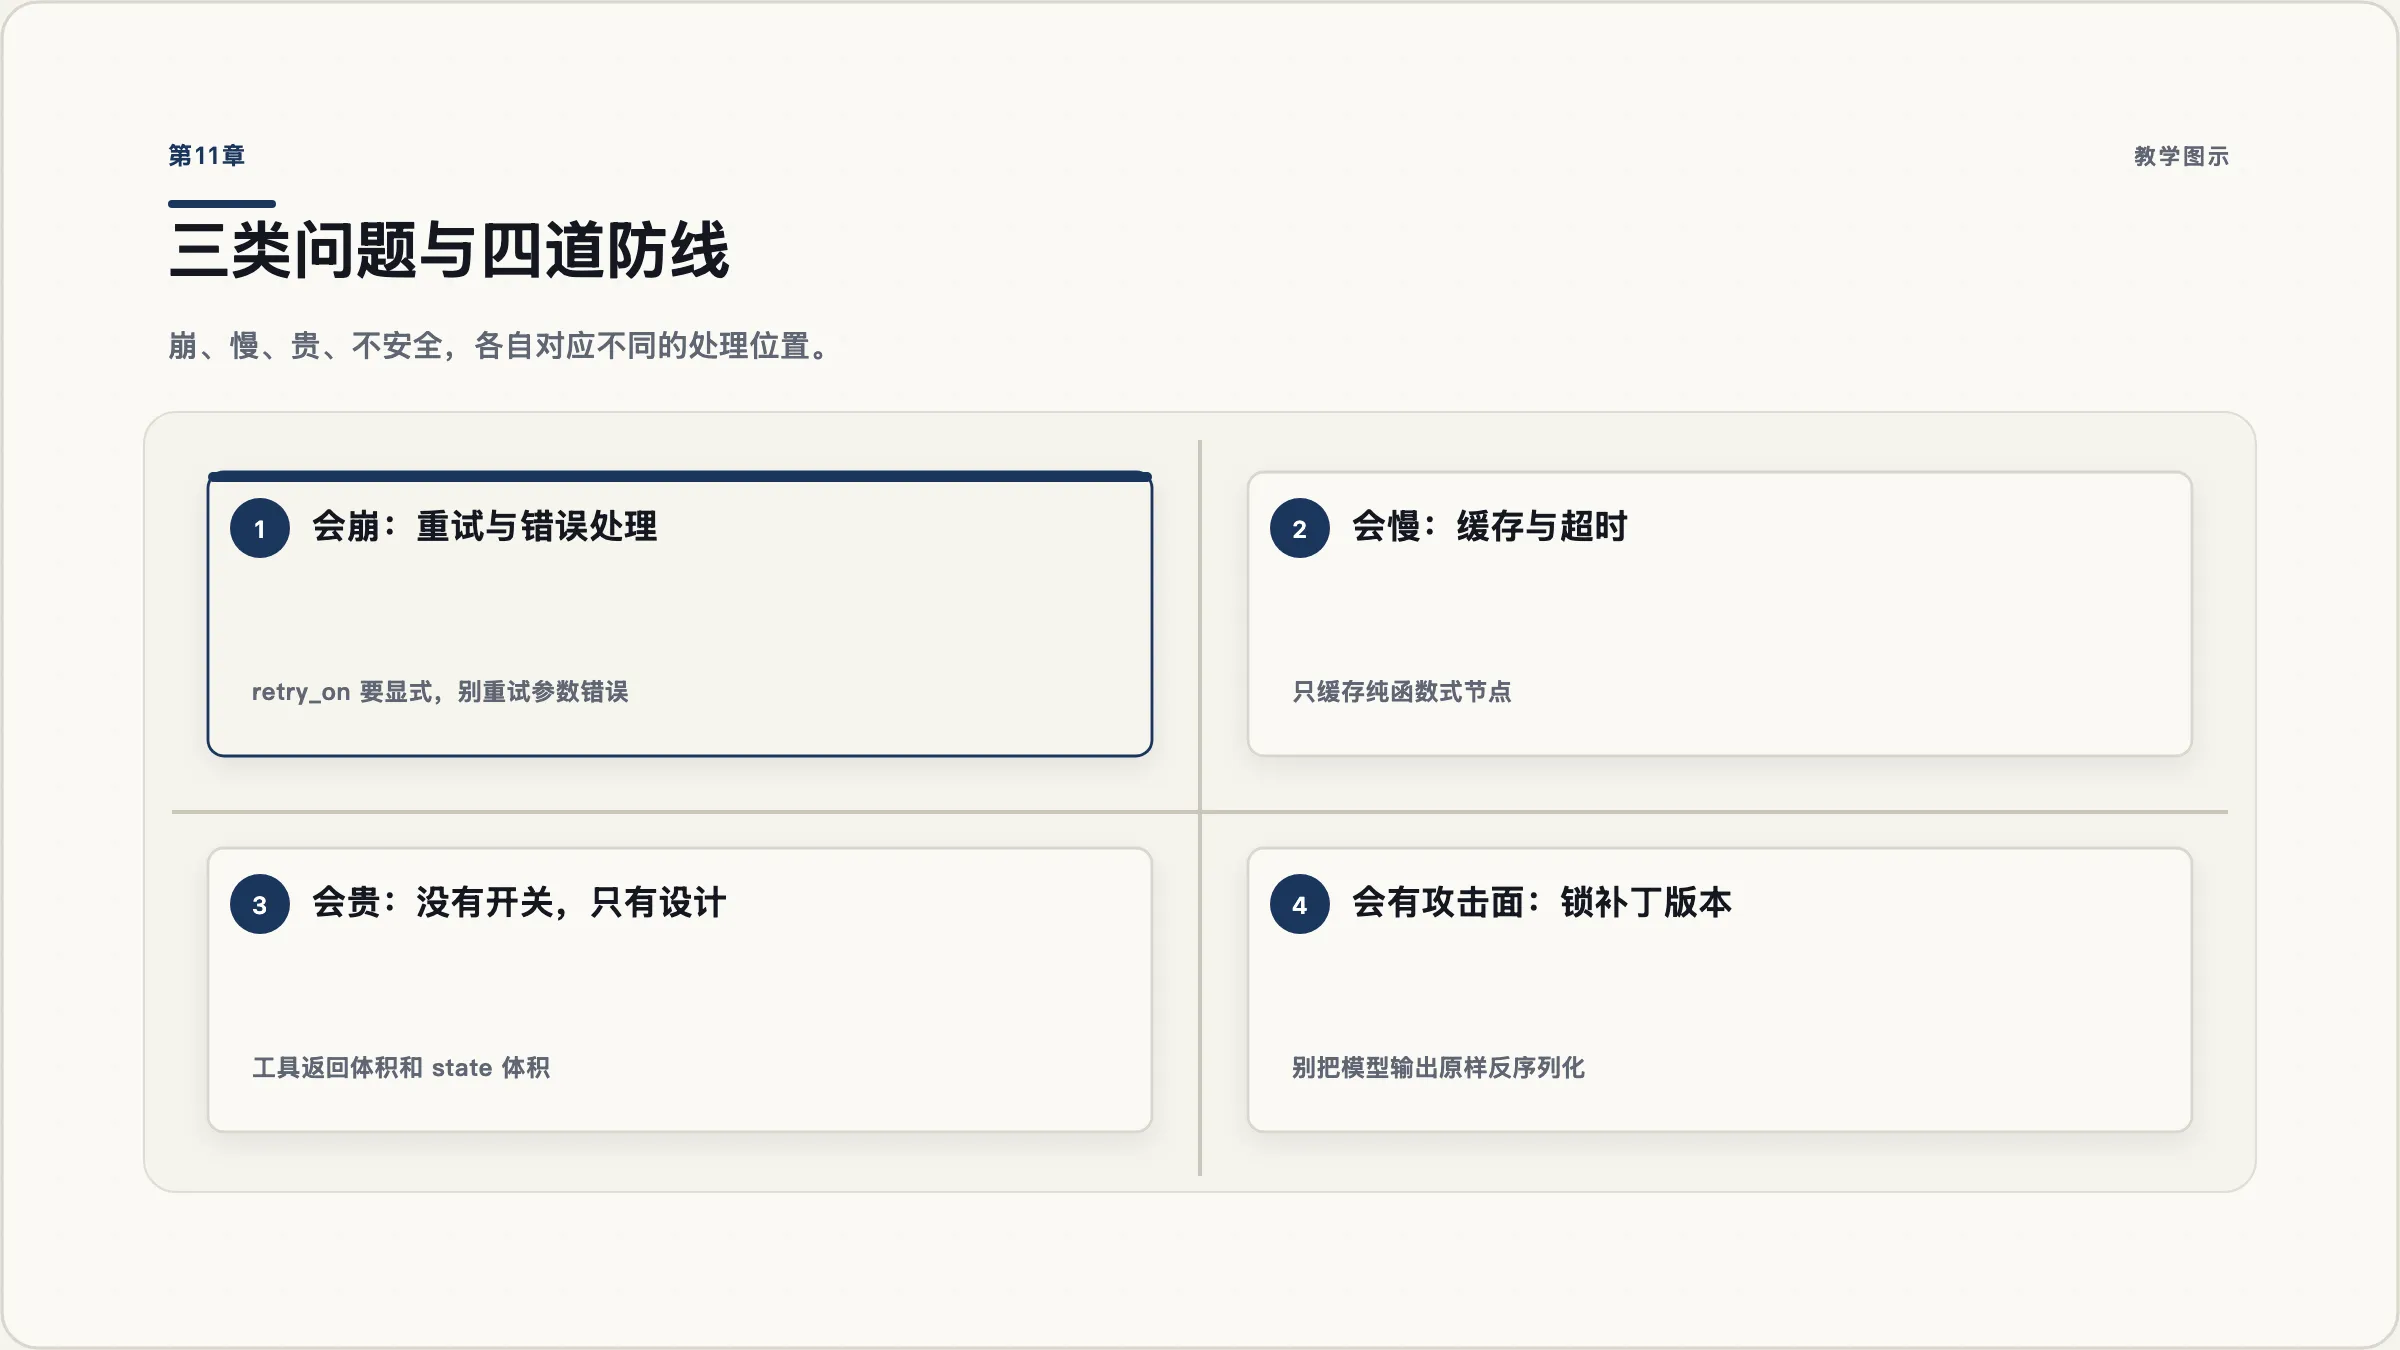
11.2 会崩:重试与错误处理
from langgraph.types import RetryPolicy

builder.add_node("fetch_order", fetch_order,
                 retry_policy=RetryPolicy(max_attempts=5, retry_on=ConnectionError))
RetryPolicy 的实测默认值:
initial_interval=0.5, backoff_factor=2.0, max_interval=128.0,
max_attempts=3, jitter=True, retry_on=<默认判断函数>
实测验证:一个前两次抛 ValueError 的节点,配上 max_attempts=5, retry_on=ValueError 之后,最终返回 {'log': ['成功于第 3 次']}。
重试之外还有 error_handler(节点级)和 wrap_tool_call(工具级,第 4 章)。两者的分工是:error_handler 处理节点崩了怎么办,wrap_tool_call 处理工具崩了怎么告诉模型。
11.3 会慢:节点缓存与超时
from langgraph.types import CachePolicy
from langgraph.cache.memory import InMemoryCache

builder.add_node("fetch_order", fetch_order, cache_policy=CachePolicy(ttl=60))
graph = builder.compile(cache=InMemoryCache())
实测效果:同样的输入连跑两次,
第一次 0.208s,第二次 0.001s,函数体实际只执行了 1 次CachePolicy 有两个字段:ttl 和 key_func(自定义怎么算缓存键)。
超时用 timeout 参数,接受秒数、timedelta 或者一个 TimeoutPolicy。官方文档区分了「整体运行超时」和「空闲超时」两种。
11.4 会贵:钱到底花在哪
这一格没有开关,只有设计。按影响从大到小排:
第一,重复进入上下文的工具结果。 每一轮模型调用都会把完整的消息历史发一遍。一个返回 3000 token JSON 的工具,被调用五轮之后,它的内容就被计费了五次。对策是第 2.4 节那个 artifact:给模型的是一句摘要,完整数据留在 artifact 里给代码用。
第二,state 的体积。 state 会被序列化进每一个检查点。社区一个仍然开着的 issue 报告,checkpoint 序列化带来约 85% 的存储膨胀和 37.8% 的 token 开销(报告者自测,官方未确认,但足以说明这不是可以忽略的量级)。
第三,多 agent 架构。 Anthropic 公开过一组内部数据:agent 的 token 用量约为普通对话的 4 倍,多 agent 系统约为 15 倍;而且「token 用量本身就解释了 80% 的性能方差」。同一篇文章也划了边界:多 agent 不适合需要所有 agent 共享同一份上下文的任务,也不适合大多数编码任务。先把单 agent 做好,再考虑拆。
第四,无效的循环。 模型在两个工具之间来回横跳,每一轮都是钱。这是第 7.5 节那个递归上限真正要防的东西。
一条实践建议:上线前用第 12 章的追踪跑一批真实工单,看每条工单的 token 分布。绝大多数团队的第一次测量结果都会发现,成本集中在少数几个「返回内容过大的工具」上,改掉它们的性价比远高于换模型。
11.5 上下文长了以后
「上下文塞满了」和「上下文变长导致质量下降」是两件事。有一篇 2026 年的综述专门区分了三个常被混为一谈的概念:
- 长程任务(任务属性):完成它需要很多步。
- 长上下文(模型属性):模型能接受多少 token。
- 长期记忆(系统属性):跨步骤、跨会话的持久化。
它总结的典型症状是:忘掉更早的决策、把半成品宣布完成、悄悄偏离目标。这三种症状加长上下文窗口是解决不了的——它们是长程任务的问题,得靠摘要(SummarizationMiddleware)、外部记忆(Store)和把大任务切小来解。
跨会话的长期记忆用 Store(实测):
from langgraph.store.memory import InMemoryStore

store = InMemoryStore()
store.put(("users", "u-1", "prefs"), "n1", {"text": "该客户历史退款 3 次"})
store.search(("users", "u-1", "prefs"))命名空间是一个元组,可以按用户、按业务线分层。checkpointer 管一条会话内的状态,Store 管跨会话的记忆——两者不要混用。
11.6 还有一类成本:攻击面
用框架不是只有抽象成本。2025 年 12 月有一个 langchain-core 的高危漏洞(CVE-2025-68664,CVSS 9.3),机理是:序列化时没有转义带 lc 键的自由字典,而 lc 是框架内部标记序列化对象用的。被提示注入控制的模型响应字段(比如 additional_kwargs、response_metadata),在流式、日志、消息历史、缓存这些常规流程里被序列化再反序列化时,可能被当成合法的框架对象。
影响范围是 langchain-core >=1.0.0,<1.2.5(1.2.5 修复)与 <0.3.81(0.3.81 修复)。
三条可以立刻做的事:
- 锁
langchain-core的补丁版本,不是只锁顶层的langchain。这两个包的发版节奏不同步——实测写作前一周内,langchain发了六个版本,langchain-core单独发了一个。 - 不要把模型输出原样塞进会被反序列化的存储。
- 把「依赖有没有安全公告」纳入上线检查清单。