第 5 章 / 共 14 章
自己画图:StateGraph 的五个零件
5.1 一个中间件解决不了的需求
财务提了一条新规则:不管模型判断结果如何,金额超过 500 的退款一律不得自动执行。
你可能想用中间件拦。但仔细想想会发现别扭:中间件的位置是「模型调用前后」和「工具调用前后」,而这条规则的位置是流程本身的一个分叉——查完订单之后,先看金额,走两条完全不同的路。硬用中间件实现,等于把流程逻辑藏进了拦截器里,读代码的人找不到它。
更根本的问题是:预置 agent 只有一个模型节点。它的世界观是「模型循环调用工具直到收工」。而你现在需要的是「先跑一段确定性的代码,再决定要不要进入模型循环」。这不是循环内部的事,是循环外部的结构。
这时候就该画图了。
5.2 五个零件
LangGraph 官方把它描述为一个底层编排框架与运行时,注意「底层」两个字——它不替你抽象 prompt,也不替你设计架构,只提供五样东西:
| 零件 | 是什么 | 一句话 |
|---|---|---|
| State | 一个 TypedDict | 所有节点共享的那份数据 |
| Node | 一个普通函数 | 读 state,返回一个增量 dict |
| Edge | 连线 | 谁跑完之后轮到谁 |
| compile() | 编译 | 把上面三样变成一个可执行对象 |
| invoke / stream | 执行 | 跑一次,或者边跑边推 |
官方的 hello world 就五行:
from langgraph.graph import StateGraph, MessagesState, START, END

def mock_llm(state: MessagesState):
    return {"messages": [{"role": "ai", "content": "hello world"}]}

graph = StateGraph(MessagesState)
graph.add_node(mock_llm)
graph.add_edge(START, "mock_llm")
graph.add_edge("mock_llm", END)
graph = graph.compile()
5.3 第一张真正的图
把它换成我们的例子(这段代码本机跑过):
from typing import Annotated, TypedDict
import operator
from langgraph.graph import StateGraph, START, END

class TicketState(TypedDict):
    steps: Annotated[list[str], operator.add]
    amount: float

def fetch_order(state: TicketState):
    return {"steps": ["fetch_order"], "amount": 89.0}

def classify(state: TicketState):
    return {"steps": ["classify"]}

builder = StateGraph(TicketState)
builder.add_node("fetch_order", fetch_order)
builder.add_node("classify", classify)
builder.add_edge(START, "fetch_order")
builder.add_edge("fetch_order", "classify")
builder.add_edge("classify", END)
graph = builder.compile()

print(graph.invoke({"steps": [], "amount": 0.0}))
真实输出:
{'steps': ['fetch_order', 'classify'], 'amount': 89.0}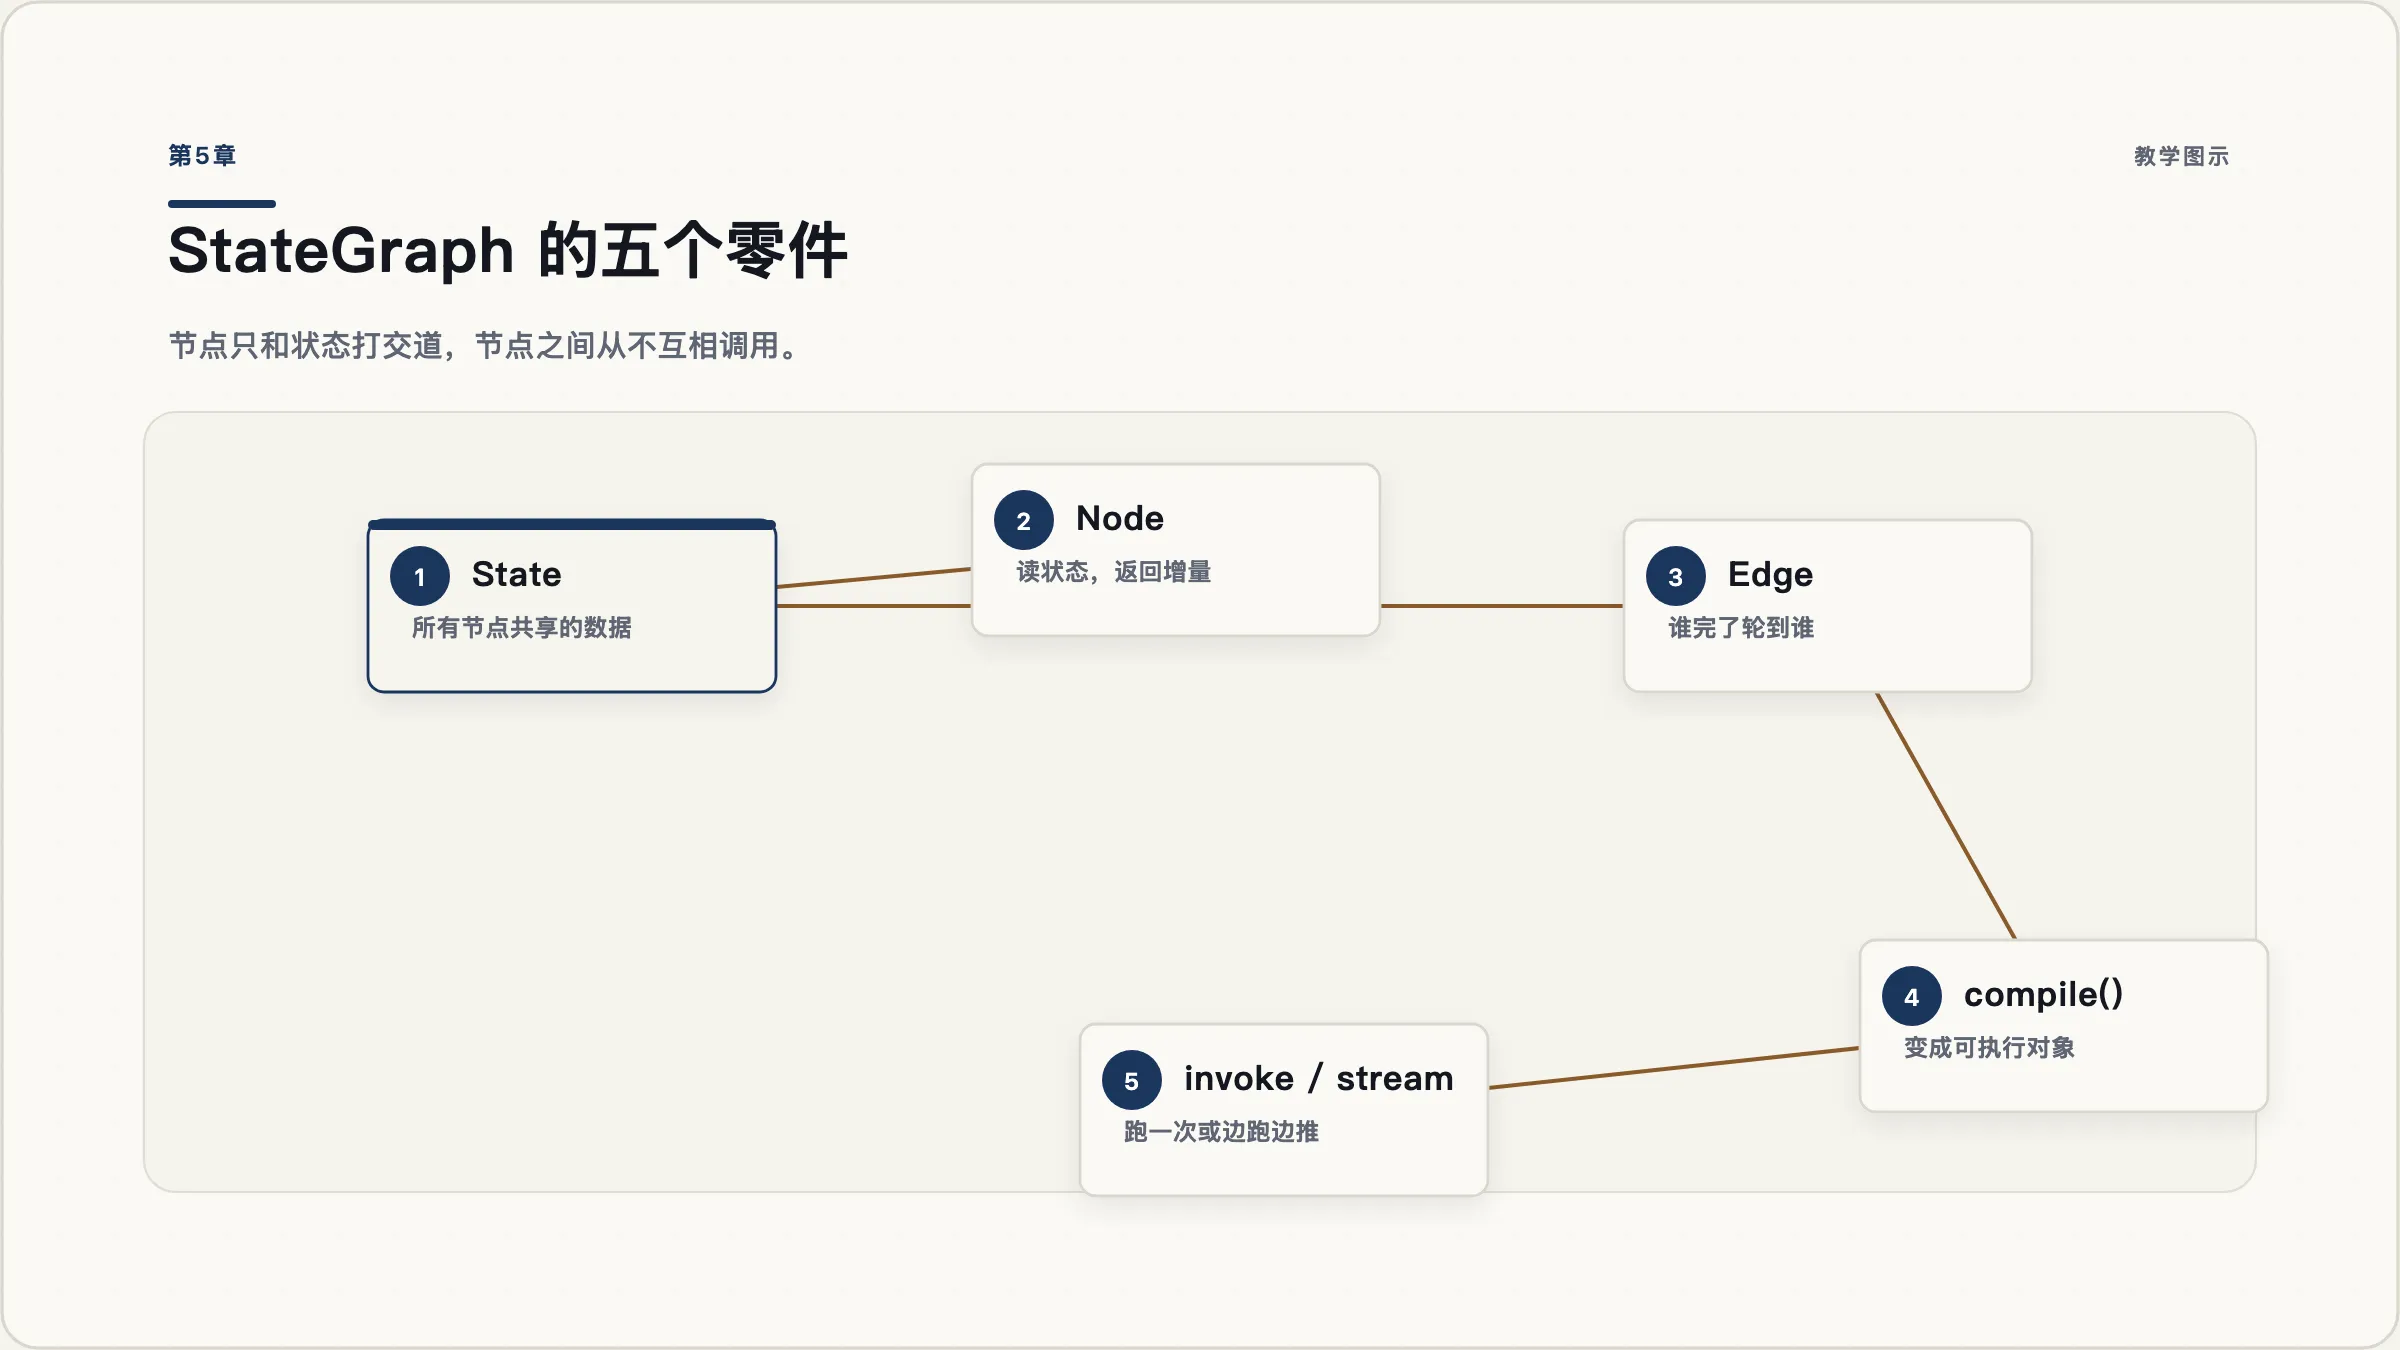
5.4 最容易搞错的一件事:节点返回的是增量
看上面 fetch_order 的返回值:{"steps": ["fetch_order"], "amount": 89.0}。它没有返回完整的 state,只返回了自己改动的那两个键。
这一点会引出两个后果:
第一,你不需要(也不应该)在节点里手动合并旧值。 下面这种写法是错的:
def fetch_order(state):
    return {"steps": state["steps"] + ["fetch_order"]}   # ❌ 会导致重复
合并是 reducer 的工作(第 6 章),节点只负责说「我这一步产生了什么」。
第二,没有出现在返回值里的键保持不变。 所以节点可以只关心自己那一小块,不用背整个 state。
5.5 用 draw_mermaid 自查
画到第五个节点你就会开始怀疑自己连错了线。有个几乎零成本的自查手段:
print(graph.get_graph().draw_mermaid())真实输出(就是上面那张图):
graph TD;
	__start__([__start__]):::first
	fetch_order(fetch_order)
	classify(classify)
	__end__([__end__]):::last
	__start__ --> fetch_order;
	fetch_order --> classify;
classify --> __end__;5.6 关于「LangGraph 需不需要 LangChain」
官方原话是:文档里会大量用 LangChain 的组件来接模型和工具,但你不用 LangChain 也能用 LangGraph。
这句话的实际含义是:LangGraph 的五个零件里没有一个依赖模型。上面那张图里根本没有模型,它照样跑。你完全可以用 LangGraph 编排一段纯粹的数据处理流程——只不过它的持久化、中断、流式这些特性,是为「跑得久、可能失败、需要人介入」的场景设计的,而这类场景目前主要出现在 agent 里。
反过来也有一条限制要记住:create_agent 不支持 Pydantic 的 state schema,只能用 TypedDict。自己画的 StateGraph 没有这个限制。
5.7 从 0.x 迁移的四件事
如果你读到的 LangGraph 代码是 1.0 之前的,官方迁移指南说除了下面这批,其余完全向后兼容:
| 旧的 | 新的 |
|---|---|
from langgraph.prebuilt import create_react_agent | from langchain.agents import create_agent |
langgraph.prebuilt 里的 AgentState 系列(含 Pydantic 版) | langchain.agents.AgentState(不再有 Pydantic 版) |
HumanInterruptConfig / ActionRequest / HumanInterrupt | langchain.agents.middleware.human_in_the_loop 里的对应类型 |
ValidationNode | 删掉,create_agent 自动校验工具输入 |
MessageGraph | StateGraph + 一个 messages 键 |
还有一批参数改了名:config_schema → context_schema、input/output → input_schema/output_schema、add_node(retry=) → retry_policy=。旧名字还能用,但会发弃用警告。
唯一的破坏性变更是不再支持 Python 3.9。