第 1 章 / 共 14 章
先分清:一个管调用,一个管流程
1.1 先看清你现在卡在哪一层
假设你接到的需求是这样的:客服系统每天进来几百条工单,其中一类是退款请求。你要写个东西,读工单内容,查订单状态,按退款政策给出处理建议;金额超过 500 元的必须人工确认;确认可能在几小时甚至第二天才来。
不用任何框架,你会怎么写?大概是这样一个循环:
messages = [{"role": "user", "content": ticket_text}]
while True:
    resp = client.chat.completions.create(model=..., messages=messages, tools=TOOLS)
    msg = resp.choices[0].message
    messages.append(msg)
    if not msg.tool_calls:
        break
    for call in msg.tool_calls:
        result = dispatch(call.function.name, json.loads(call.function.arguments))
messages.append({"role": "tool", "tool_call_id": call.id, "content": result})这段代码没有任何问题——在需求变复杂之前。让我们把上面那几条需求一条条加进去:
| 新需求 | 你要改什么 | 改完之后的代价 |
|---|---|---|
| 换一家模型厂商试试效果 | 消息格式、工具格式、返回结构全要改一遍 | 每加一家就多一套分支 |
| 金额超阈值要人工确认 | 循环中间要能「停住并返回」,之后还要能「从停住的地方继续」 | 一个 while 循环没有中间态可言 |
| 进程重启后会话不能丢 | messages 要序列化落库,还要记住停在哪一步 | 你开始自己写检查点了 |
| 前端要看到中间过程 | 循环里每一步都要往外推事件 | 循环变成了事件发射器 |
| 出错要能查是哪一步 | 每一步的输入输出都要记录 | 你开始自己写追踪了 |
看这张表的方式不是「所以要用框架」,而是:这五行需求分别落在两个不同的层面上。第一行是「一次调用」的问题——怎么把不同厂商抹平。后四行是「一段流程」的问题——状态、中断、恢复、可见性。
LangChain 解决第一类,LangGraph 解决第二类。这就是它们的分工。
1.2 两个问题,四种做法
把上面的观察压成两个可以立刻回答的问题:
- 这件事需要多步、需要循环吗?(模型要连续调用工具、根据结果决定下一步)
- 这段流程需要跨越一次调用活下来吗?(要中断等人、要重启后继续、要事后回溯)
两个问题交叉,得到四种做法:
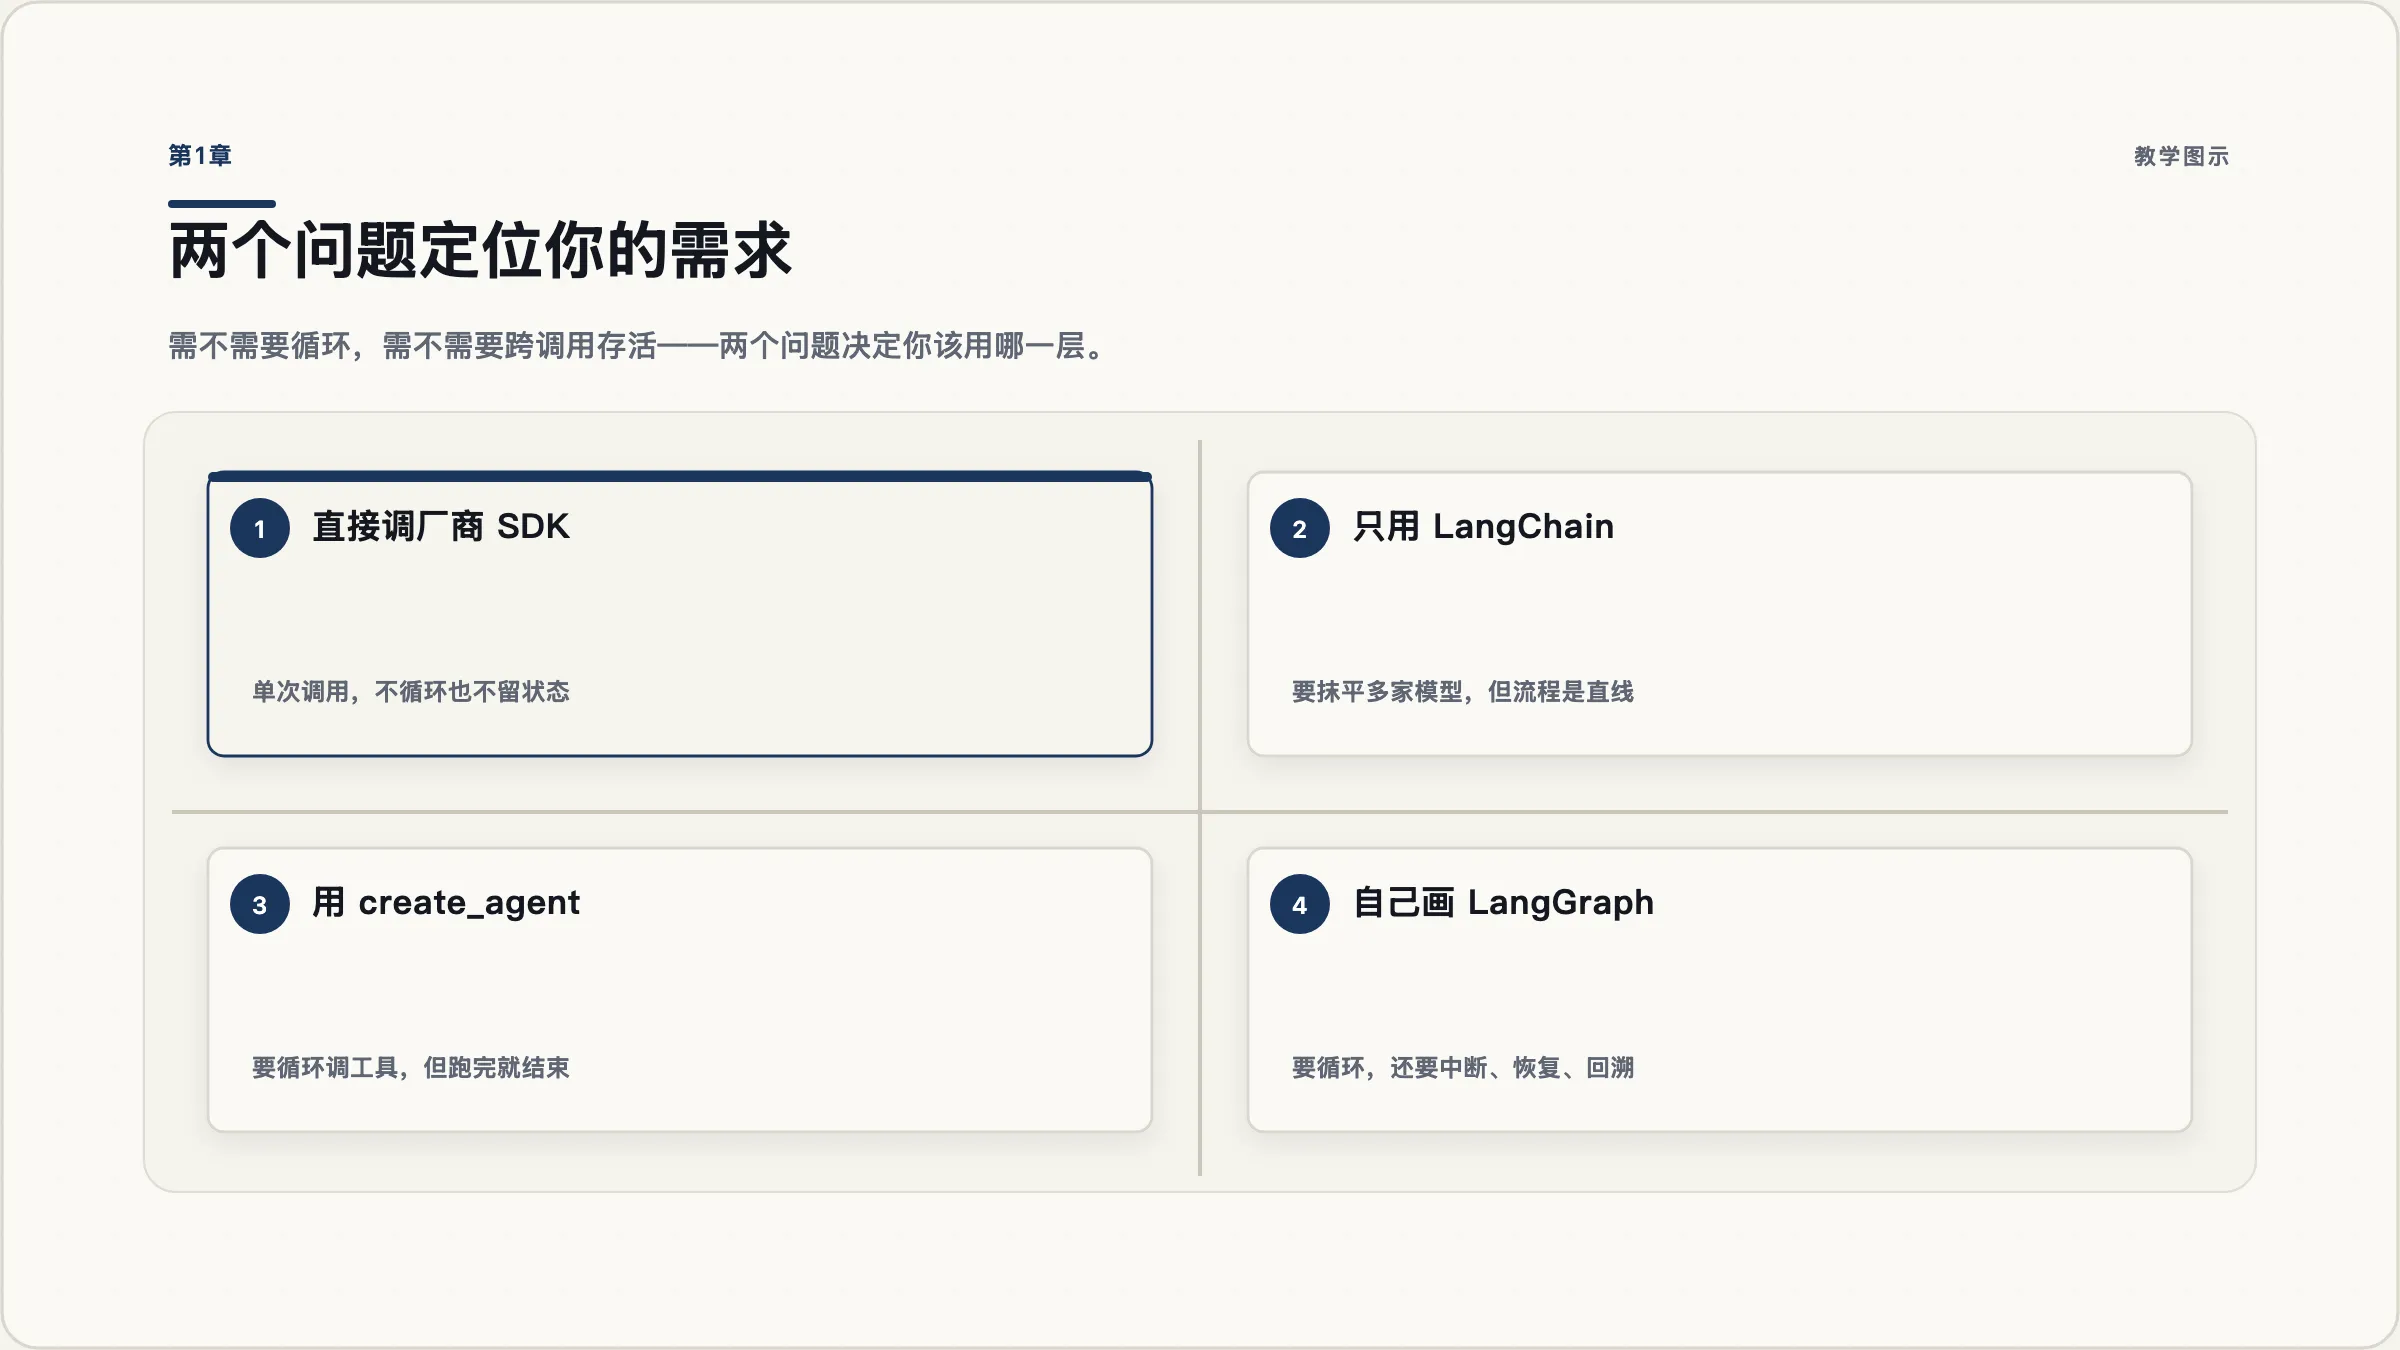
- 都不需要:直接调厂商 SDK。单次分类、单次摘要、单次抽取,加框架只是多一层间接。
- 只需要抹平差异:用 LangChain 的模型与工具封装。你要同时支持几家模型、要结构化输出、要标准化的消息格式,但流程本身是一条直线。
- 需要循环,但不需要跨调用存活:用 LangChain 的
create_agent。它给你一个久经使用的「模型 ⇄ 工具」循环,加上一整套可插拔的控制点,你不用自己写那个while。 - 需要循环,还要跨调用存活:用 LangGraph 自己画图。状态、检查点、中断、恢复、时间旅行都在这一层。
1.3 什么时候这两个都不该用
这一节比上一节重要,因为选错的代价是长期的。
第一种:一次调用就能解决的事。 分类、抽取、改写、翻译。加框架不会让它更准,只会让你多读一层源码才知道 prompt 到底长什么样。Anthropic 在《Building effective agents》里的建议很直接:先直接用 API,很多模式几行代码就能实现;如果要用框架,请确保你理解底下的代码。这句话在 2026 年依然成立。
第二种:流程完全确定的事。 如果步骤是「先 A 再 B 再 C」,没有分支、没有循环、模型只在其中一步出现,那它是个普通的 Python 函数,不是 agent。硬画成图只是把 def 换成了 add_node。
第三种:你还没想清楚要做什么的时候。 agent 框架不会替你想清楚工具边界和成功标准。这两件事没想清楚,用什么框架都会失败。
第四种:团队没有可观测性预算的时候。 这是最容易被忽略的一条。agent 的行为在每次运行之间都不一样——Anthropic 的说法是「即使 prompt 完全相同,agent 的决策也是非确定的,这让调试变难」。如果你没有打算投入追踪和评估(第 12 章),那么上线之后你会陷入一种很难受的状态:知道它错了,但不知道错在哪。
1.4 关于「LangChain 抽象太重」这个说法
你在搜索的时候一定会遇到这类文章,最有名的一篇是 2024 年 6 月的《为什么我们不再用 LangChain 构建 AI agent》,在 Hacker News 上有 480 分、近 300 条评论。批评很集中:抽象层太厚,稍微做点不常规的事就要穿过五层封装;文档差;连拿 token 用量这种基础信息都很费劲;无法在运行中观察和控制 agent 的状态。
这些批评是真的,但它们针对的是 2023 年到 2024 年中的版本,也就是 LLMChain / AgentExecutor / initialize_agent 那个时代。要判断它今天还成不成立,你需要知道之后发生了什么:
| 当年的批评 | 之后发生了什么 | 今天还成立吗 |
|---|---|---|
| 抽象层太厚、调不动 | 那批类整体移入 langchain-classic;主包只剩 agents / messages / tools / chat_models / embeddings 五个命名空间 | 大幅缓解,但仍有需要读源码才能确定行为的地方 |
| 破坏性变更太频繁 | 2024 一年内走了 0.1 → 0.2 → 0.3;1.0 之后官方承诺 2.0 前不做破坏性变更 | 承诺是有的,但发版极密,锁版本仍是必修课 |
| 依赖臃肿 | 已拆成 core + 各厂商包 + classic | 基本解决 |
| 无法观察和控制运行中的状态 | LangGraph 的状态图 + 检查点正是针对这一点设计的 | 这条批评直接催生了 LangGraph |
最后一行是理解这两个库关系的钥匙:LangGraph 在很大程度上就是对那波批评的产品级回应。批评者说「我没法在运行中看到和改变 agent 的状态」,LangGraph 的回答是「那我们把状态变成一等公民,每一步都存快照,你随时可以读、可以改、可以从任意一步重跑」。
所以你现在读到的任何一篇 2025 年之前的评价——无论褒贬——都要先问一句:它说的是哪个版本。
1.5 顺便看一眼周边
选型时你还会看到几个名字。用当天从 GitHub 抓到的客观数据摆一下,不做优劣判断:
| 项目 | stars | 最近提交 | 自述定位 |
|---|---|---|---|
| AutoGen | 60,835 | 2026-04-15(已近五个月无提交) | 多智能体对话框架 |
| CrewAI | 58,145 | 2026-09-04 | 角色化多智能体协作 |
| LangGraph | 41,126 | 2026-09-06 | 底层编排框架与运行时,MIT |
| OpenAI Agents SDK | 29,220 | 2026-09-05 | 极少抽象的轻量 agent 框架 |
| Pydantic AI | 19,748 | 2026-09-05 | 端到端类型化的 agent 框架 |
1.6 练习与检查点
当 ______(触发场景)发生时,它需要 ______(几步/是否循环),过程中 ______(是否需要人介入/是否可能跨小时),失败时 ______(能不能直接重来)。
这句话里的四个空,恰好对应本教程的第 3、5、9、11 章。