第 6 章 / 共 14 章
状态与 reducer:合并规则决定一切
6.1 一个必然会遇到的报错
给退款助手加两个并行节点:一个查订单,一个查用户历史,两个都往 state 里写。
class P(TypedDict):
    v: int

def x(s): return {"v": 1}
def y(s): return {"v": 2}

builder.add_edge(START, "x")
builder.add_edge(START, "y")     # 两条边都从 START 出发 = 并行
真实报错:
InvalidUpdateError: At key 'v': Can receive only one value per step.
Use an Annotated key to handle multiple values.
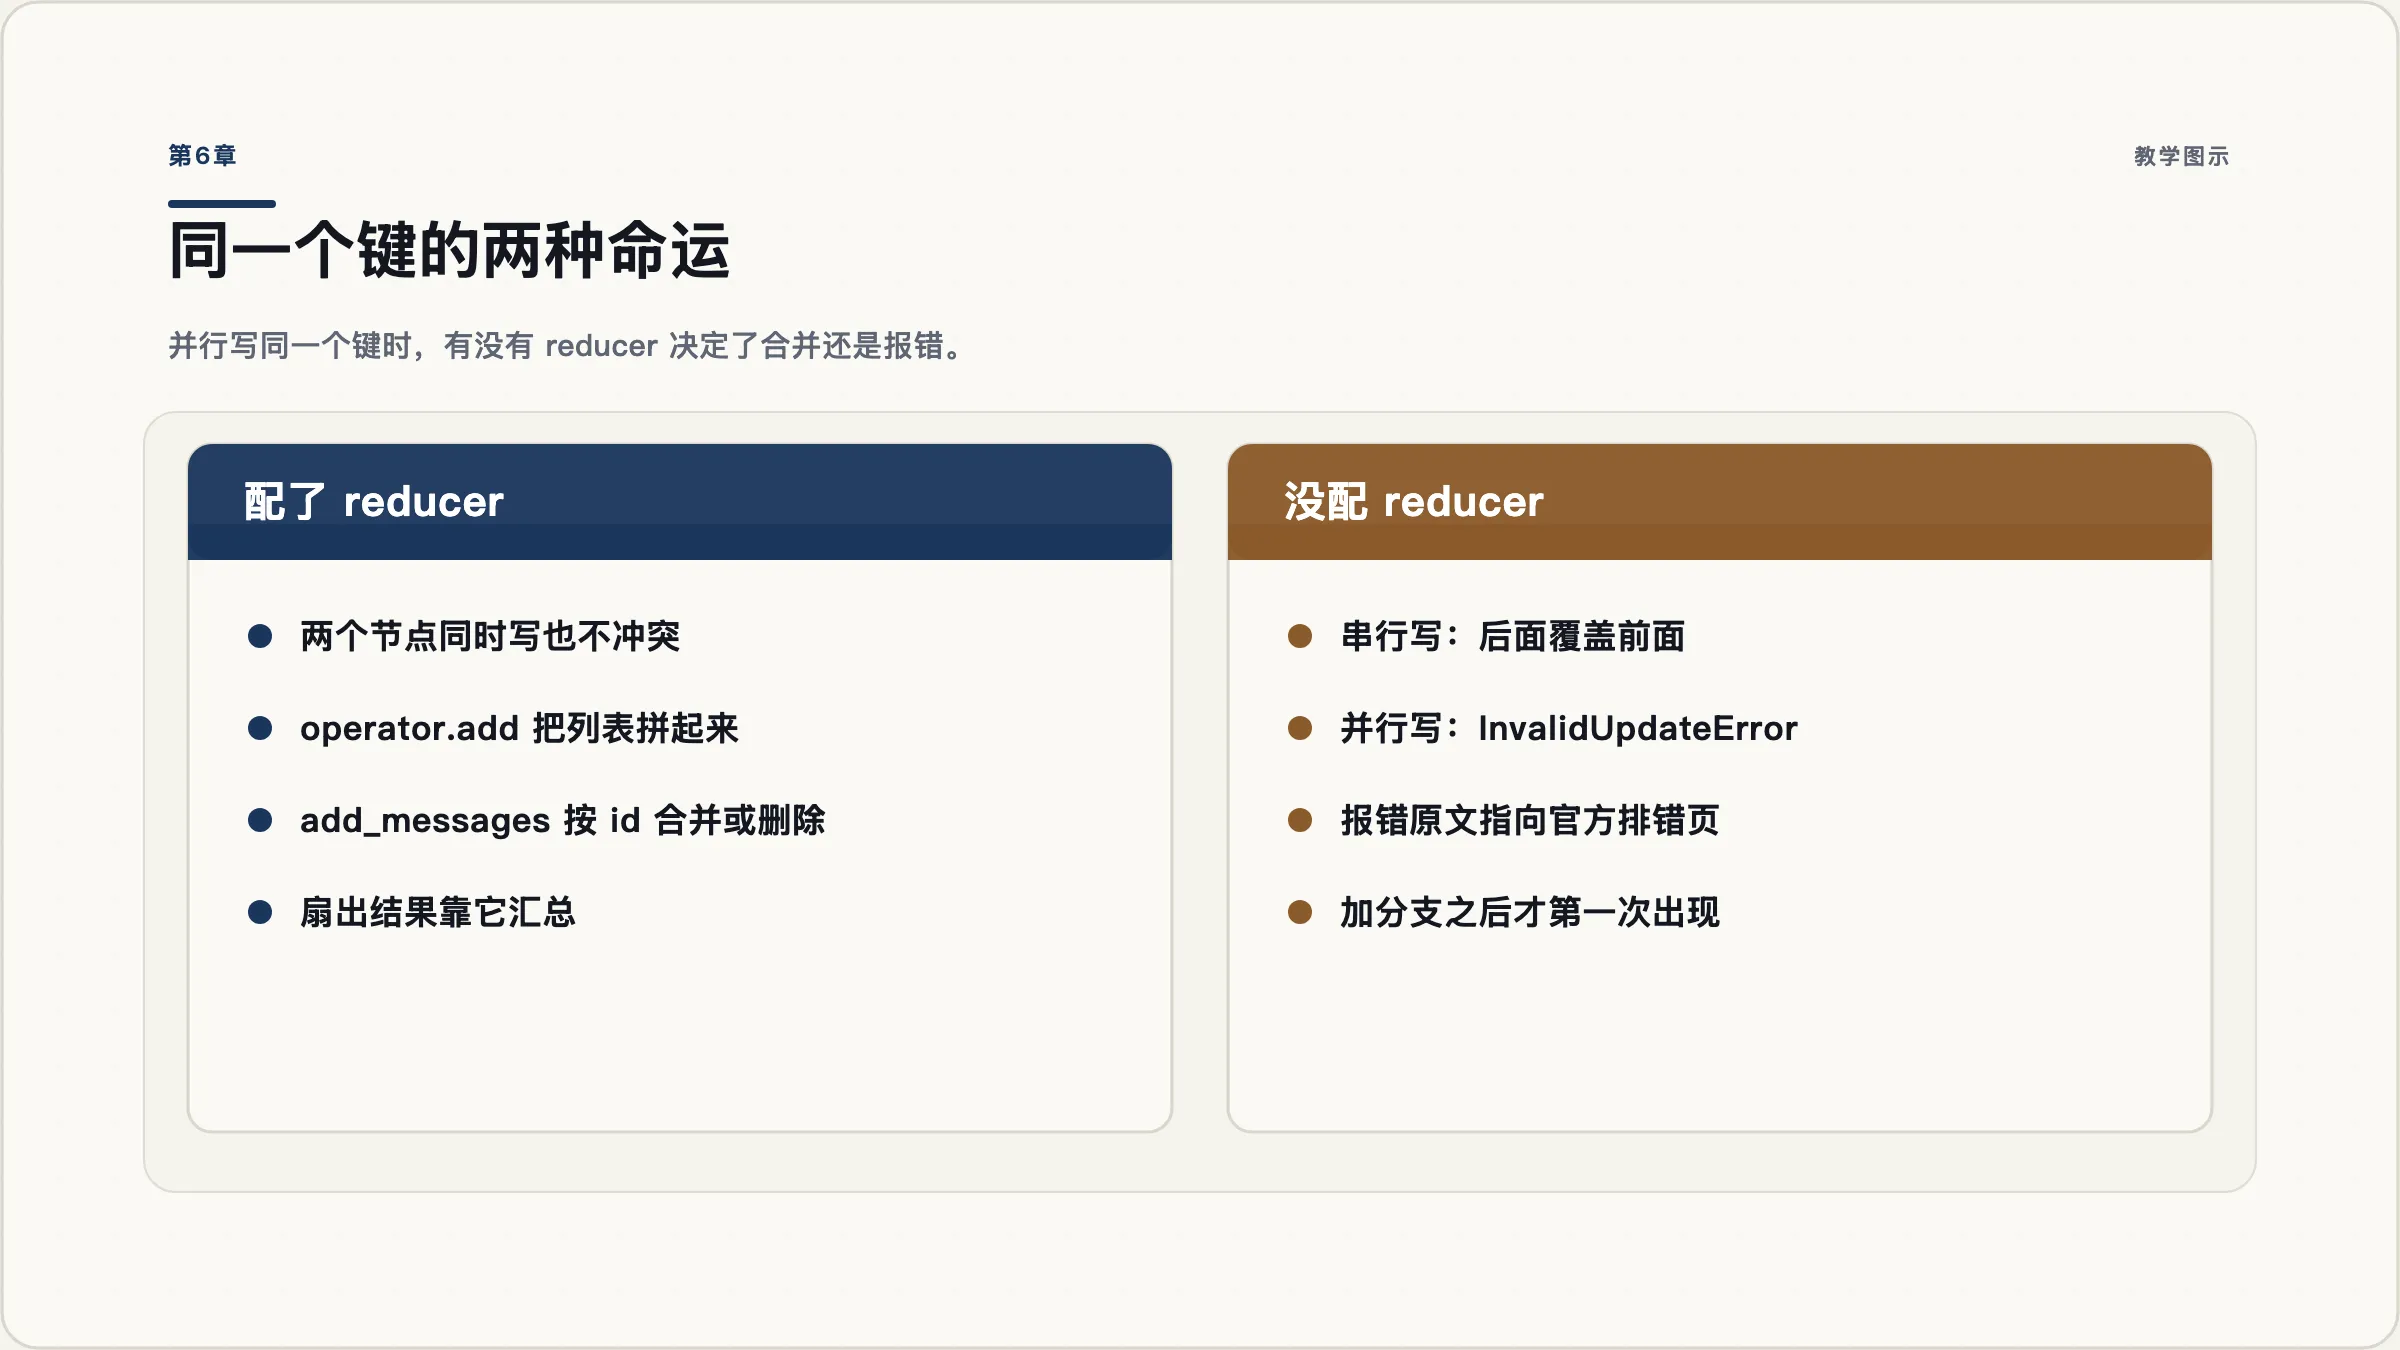
For troubleshooting, visit: https://docs.langchain.com/oss/python/langgraph/errors/INVALID_CONCURRENT_GRAPH_UPDATE这个报错值得慢慢读,因为它把整个机制说清楚了:同一步之内,一个键只能收到一个值。两个节点在同一步都想写 v,框架不知道该听谁的,于是它不猜——直接报错,并告诉你解决办法是给这个键加个 Annotated。
6.2 reducer 就是那条合并规则
from typing import Annotated
import operator

class TicketState(TypedDict):
    steps: Annotated[list[str], operator.add]   # 有 reducer:追加
    amount: float                               # 没有 reducer:覆盖
Annotated[T, fn] 里的 fn 就是 reducer,签名是 fn(旧值, 新值) -> 合并后的值。operator.add 用在 list 上就是拼接。
两种行为的对照(本机实测):
| 键 | 声明 | 节点 A 返回 | 节点 B 返回 | 最终值 |
|---|---|---|---|---|
steps | Annotated[list, operator.add] | ["a"] | ["b"] | ["a", "b"] |
n | int(无 reducer) | 2 | 4 | 4(后写的赢) |
v | int(无 reducer)并行写 | 1 | 2 | 报错 |
6.3 消息列表的 reducer 不是简单拼接
消息历史用的是内置的 add_messages:
from langgraph.graph import MessagesState, add_messagesMessagesState 的完整定义就一行:{"messages": Annotated[list[AnyMessage], add_messages]}。
但 add_messages 比 operator.add 聪明得多,它拿 message id 当主键做 upsert。三种行为(本机实测):
| 右侧传入 | 结果 |
|---|---|
| 一条新消息(新 id) | 追加到末尾 |
| 一条 id 已存在的消息 | 覆盖那一条,位置不变 |
一条 RemoveMessage(id=...) | 删除那一条 |
实测输出:
原始:        [human/hi/id=1, ai/hello/id=2]
+ AIMessage(id="3")      -> [human/hi/1, ai/hello/2, ai/again/3]
+ AIMessage(id="2")      -> [human/hi/1, ai/改写了/2]
+ RemoveMessage(id="1") -> [ai/hello/2]这是修改历史消息的唯一正确入口。想删掉一条含敏感信息的工具返回,不要去 state["messages"] 上做列表操作——那是一份快照,改了不会生效。正确做法是让节点返回一条 RemoveMessage。
6.4 子图共享 key 的重复累加陷阱
这是本教程实测出来的一个坑,网上很少讲,但一旦踩上会让人怀疑人生。
把一个编译好的子图直接当节点挂到父图上,父子共用同一个带 reducer 的键:
# 父图和子图的 state 都是 {"log": Annotated[list[str], operator.add]}
par.add_node("child", subapp)      # subapp = sub.compile()
期望输出是 ['parent', 'sub-1'],真实输出是:
{'log': ['parent', 'parent', 'sub-1']}'parent' 出现了两次。用 subgraphs=True 流式跑一遍就看清了(实测):
()                        {'p1':    {'log': ['parent']}}
('child:7d482543-...',)   {'s1':    {'log': ['sub-1']}}
() {'child': {'log': ['parent', 'sub-1']}} ← 整份被当成增量原因:子图作为节点被调用时收到的是父状态(log=['parent']),它返回的是自己的完整状态(['parent','sub-1']),这份返回值又一次经过父图的 operator.add 被追加了上去。
修法是给子图一套独立的 state schema,用普通函数包一层,只把真正的增量交回父图:
def call_child(state):
    out = subapp.invoke({"task": state["task"]})
    return {"log": [f"child->{out['result']}"]}
改完输出变成 {'log': ['parent', 'child->ABC']}。
判据:父图和子图共享带 reducer 的键时,直接挂子图;不共享时,用函数包一层。前者省事但只在你确实想要「子图的完整状态并入父图」时才正确。
6.5 设计 state 的三条经验
- 能不放进 state 的就不放。 state 会被序列化进每一个检查点,放得越多,存储和恢复越慢(第 11 章有具体数字)。中间计算结果用局部变量。
- 给每个键先问一遍「并行写怎么办」。 答案是「追加」就配
operator.add,是「以最后一个为准」就不配,是「按 id 合并」就写自定义 reducer。 - 消息之外的业务字段单独放。 不要把订单信息塞进
messages让模型自己记,那是最贵的存储方式。