第 14 章 / 共 14 章
交付:把它做完,并且知道自己做完了
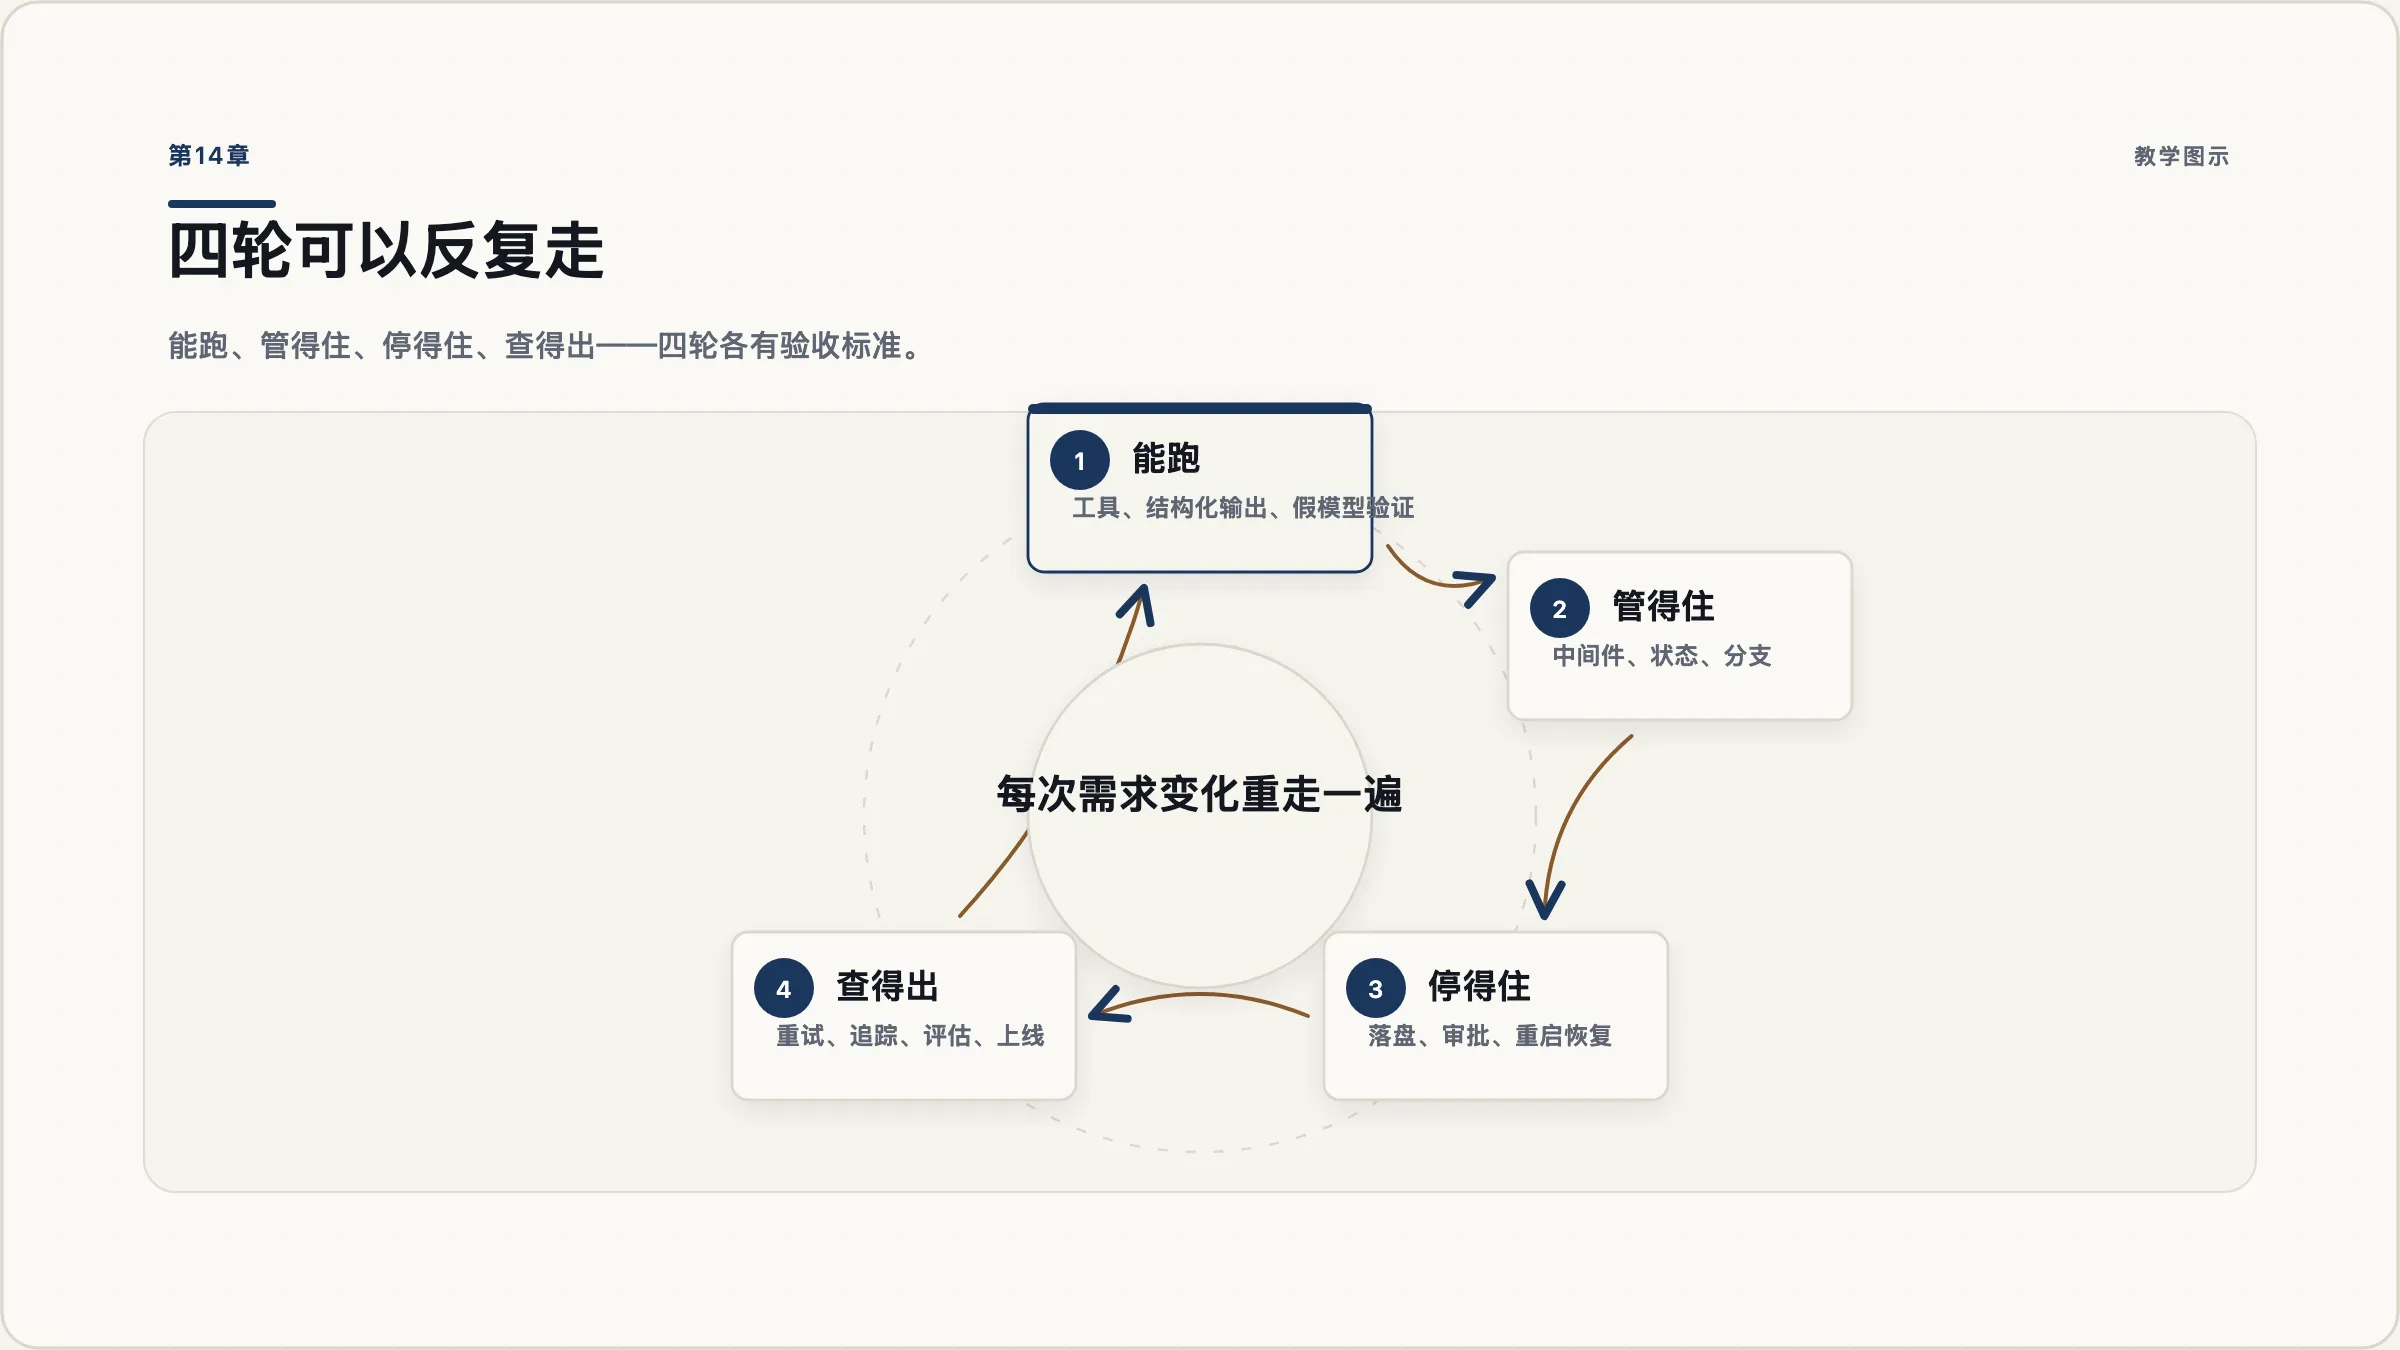
14.1 四轮任务卡
前面十三章是零件,这一章是把它们装起来。每一轮都有明确的产出和验收标准,不要跳。
第一轮:能跑(对应第 2、3 章)
- 建项目,装
langchain、langgraph和一个厂商包。 - 写两个工具:
lookup_order、check_refund_policy,都带parse_docstring=True。 - 用
create_agent跑通一条工单,打印完整的messages。 - 定义
RefundDecision结构化输出,确认result["structured_response"]拿得到。 - 验收:不用真实模型也能跑通——用
ScriptedChatModel写一个剧本,断言消息序列是 Human → AI(tool_calls) → Tool → AI。
第二轮:管得住(对应第 4、6、7 章)
- 加三个中间件:调用次数上限(用
thread_limit)、PII 处理、一个记录耗时的wrap_tool_call。 - 从
create_agent迁到自己画的StateGraph:fetch_order→ 条件边(金额 500 分叉)→ 两条路径。 - state 至少四个键,其中带 reducer 的键要能解释「为什么是这个 reducer」。
- 验收:故意造一个并行写冲突,看到
InvalidUpdateError,然后用 reducer 修好它。
第三轮:停得住、接得回(对应第 8、9、10 章)
- 接
SqliteSaver(记得单独装包)。 - 超额路径上加
interrupt(),抛出的内容要足够前端渲染一个审批框。 - 分别用批准和拒绝恢复,对比最终状态。
- 杀掉进程,重启,用同一个
thread_id恢复——这一步是整个教程的分水岭。 - 给每个节点加
get_stream_writer()的人话进度。 - 验收:进程重启之后仍能恢复;前端只订阅
custom就能显示完整进度。
第四轮:查得出、上得线(对应第 11、12、13 章)
- 给外部调用配显式的
retry_on,给慢节点配缓存。 - 把返回最大的那个工具改成
artifact模式。 - 落一份至少二十条的评估数据集,跑出基线准确率。
- 写
langgraph.json,用langgraph dev起服务,走完 REST 三步。 - 对照 13.6 的十四条清单逐项确认。
- 验收:能回答「昨天那条工单为什么判错」——从追踪或日志里翻出模型那一步的完整输入。
14.2 十项自评量表
每项 0 / 1 / 2 分(0 = 没做,1 = 做了但心里没底,2 = 能给别人讲清楚):
| # | 项目 | 2 分的样子 |
|---|---|---|
| 1 | 选型判断 | 能说出你的需求为什么需要(或不需要)画图 |
| 2 | 工具设计 | 每个工具的参数都有独立 description,返回体积可控 |
| 3 | 状态设计 | 每个键的 reducer 选择都有理由,没有冗余字段 |
| 4 | 控制流 | 分支、循环、扇出各写过一次,知道 Command 和条件边的分工 |
| 5 | 持久化 | 进程重启后能恢复,知道改图对在途会话的影响 |
| 6 | 人在回路 | 审批前没有副作用代码,恢复载荷形状写对 |
| 7 | 流式 | 前端订阅的是 custom 而不是内部结构 |
| 8 | 韧性与成本 | 有显式重试、有次数上限,知道 token 花在哪 |
| 9 | 可观测 | 能定位到「模型那一步收到了什么」 |
| 10 | 交付 | 有服务接口、有评估基线、过了上线清单 |
16 分以上可以交付;12 到 15 分能上线但会疼;12 分以下,找出得 0 分的那几项,回对应章节。
14.3 三种「差一点」的典型表现
第一种:能跑但查不了。 功能都对,出了问题只能靠猜。症状是每次线上问题都要「本地复现一下」。缺的是第 12 章。
第二种:能查但停不住。 追踪很全,但所有危险操作都是自动执行的,出事只能事后补救。缺的是第 9 章。
第三种:什么都有但很贵。 每条工单成本高得没法规模化。通常是工具返回体积过大加上 state 太肥。缺的是第 11.4 节那次测量。
14.4 关于多智能体:两个权威给了相反的答案
做到这一步,你大概率会想:要不要把这个 agent 拆成「查询 agent + 判断 agent + 执行 agent」?
这个问题在 2025 年 6 月有过一次很有意思的正面碰撞,两篇文章隔了一天:
- Cognition(Devin 团队)的《Don’t Build Multi-Agents》主张两条原则:共享上下文,而且要共享完整的 agent 轨迹而不只是单条消息;行动隐含着决策,冲突的决策带来糟糕的结果。他们举的例子是做一个 Flappy Bird 克隆拆成两个子 agent,结果一个做出了超级马里奥风格的背景。(这篇文章点名批评的是另外两个框架,并没有点名 LangGraph——中文二手文章里常有误传。)
- 第二天,Anthropic 发文说他们的多 agent 研究系统比单 agent 高 90.2%(内部评测),但同时自己划了边界:不适合需要所有 agent 共享同一份上下文的任务,不适合 agent 之间依赖很多的任务,也不适合大多数编码任务——因为「模型目前还不太擅长实时地协调和委派给其它 agent」。
学术侧也有材料:一项跨七个主流多智能体框架、标注了 1600 多条轨迹的研究,把失败归纳成 14 种模式三大类——系统设计问题、agent 之间的目标错位、任务验证不足。它开篇就指出多智能体系统在主流基准上的性能增益往往很小。
所以这个问题没有唯一答案,但有一个可操作的判据:如果拆分之后各个子 agent 需要看到彼此的完整过程才能做对决定,那就别拆——你只会把上下文问题变成通信问题。反过来,如果子任务之间天然独立、可以并行、各自的输出能被机械地合并(比如「同时研究十个候选供应商」),那就是多 agent 合适的场景,第 7.4 节的 Send 已经够用了。
先把单 agent 做好。这句话在 2026 年依然是最省钱的建议。
14.5 下一步
这份教程覆盖的是编排层。做完之后,往下走有三个方向:
- 上下文工程:什么该进模型上下文、什么不该。这是决定 agent 质量上限的地方,也是官方自己反复强调的难点——「难的是控制什么进入 LLM 的上下文」。
- 评估工程:从二十条数据集扩到几百条,引入模型裁判,把评估接进 CI。第 12 章只开了个头。
- 给 agent 写工具:如果你需要的能力现在还不存在,那就得自己写。工具的描述、schema、错误返回、返回体积,每一条都直接影响 agent 的表现。
最后留一句实践习惯,比本教程里任何一个 API 都更耐用:
动手之前先核对版本,动手之后先看模型收到了什么。 这两个动作能解决你未来八成的问题——第一个躲开的是「教程过期」,第二个躲开的是「模型犯蠢」。而这两类,恰好就是 agent 开发里最常见的两种卡壳。