第 9 章 / 共 21 章
记忆层:跨会话留住真正重要的事实
上一章留下的问题:压缩是有损的。你在第 5 轮说过”这个项目用 tab 缩进,不要空格”,压缩到 L4 之后,摘要里可能只剩一句”讨论了代码风格”。更狠的是:明天你开一个新会话,连那句摘要都没有了——大模型本身没有任何持久状态,一切都活在上下文窗口里。
于是你每次开新会话都要重新交代一遍偏好、约束、项目背景。三次之后你就不想用了。
9.1 记忆是压缩之外的一层
解法在于承认一件事:有些信息不该活在对话里。
对话是会被压缩、会随会话结束而消失的;而”这个项目用 tab 缩进”这类事实,应该存在一个压缩碰不到、会话结束也还在的地方——文件系统。
结构很简单:一个 .memory/ 目录,每条记忆一个 .md 文件,带 YAML frontmatter;外加一个 MEMORY.md 作为索引。
---
name: indent-tabs-not-spaces
description: 该项目统一使用 tab 缩进,禁止空格
type: user
---

本项目所有源文件使用 tab 缩进。提交前会被 lint 检查拦截,
所以生成代码时直接用 tab,不要事后再转换。
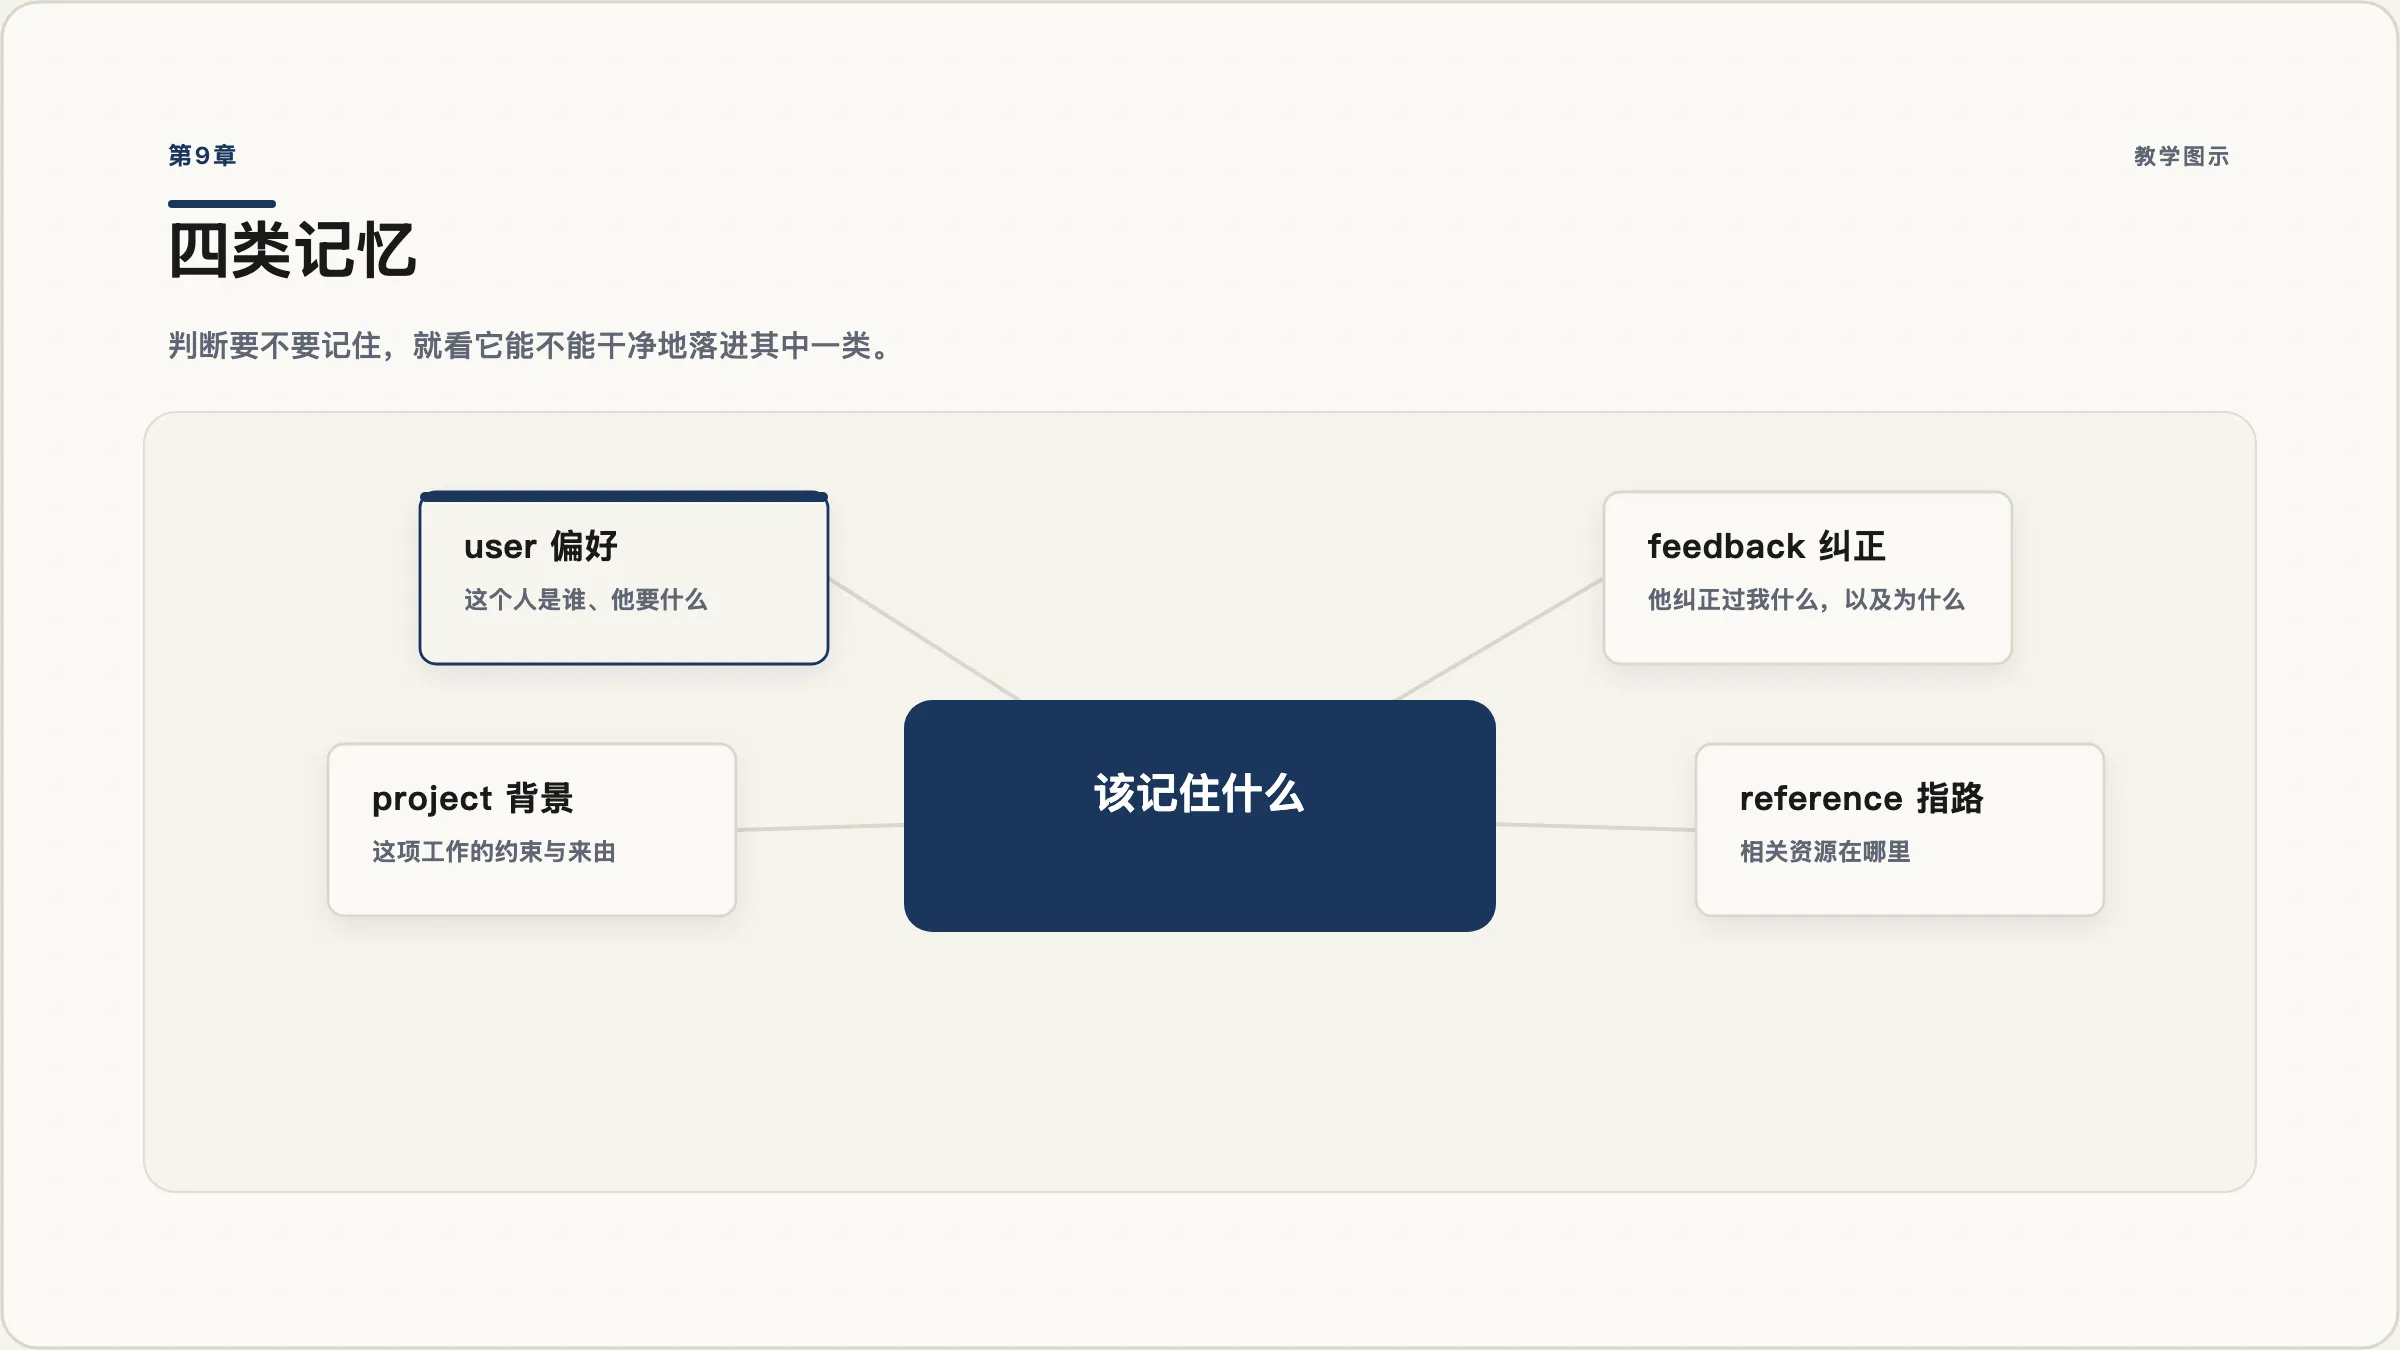
type 分四类,各自回答一个不同的问题:
| type | 回答的问题 | 例子 |
|---|---|---|
user | 这个人是谁、他偏好什么 | “用 tab 不用空格”、“回答要简短” |
feedback | 他纠正过我什么 | “不要 mock 数据库,用测试容器” |
project | 这项工作的背景和约束 | “认证模块重写是合规要求,不能改接口” |
reference | 相关资源在哪里 | “数据管道的 bug 记在 Linear 的 INGEST 项目” |
**这四类不是分类学游戏,是保存判断的依据。**问自己:“这条信息属于哪一类?“如果一类都不属于,它多半不该被存成记忆——它可能只是这次对话里的临时细节。
9.2 两条装载路径
和第7章的技能一样,记忆也用”廉价索引 + 按需正文”:
- 索引进系统提示词:
MEMORY.md每条一行(名字 + 描述),常驻、可被 API 的提示词缓存复用。 - 正文按需装载:把最近几轮对话 + 记忆目录发给模型做一次轻量的侧查询,让它挑出最相关的(上限比如 5 条),只读这几个文件的正文注入上下文。
侧查询会失败(网络、限流、返回格式不对)。失败时降级为关键词匹配——拿当前对话里的词去匹配记忆的 name 和 description。宁可不那么准,也不要整条路径挂掉。
9.3 写入:显式与自动
显式写入:用户说”记住这个”,直接调用一个 remember 工具写文件。
自动抽取:在一轮对话自然结束时(stop_reason != "tool_use"),跑一次抽取——把这轮对话和现有记忆目录一起发给模型,让它找出”这轮里出现了、但现有记忆里没有”的新事实,按格式返回,然后写成新文件。
抽取里有个关键动作:**必须带上现有记忆目录做去重。**否则同一条偏好会被反复写十遍。
整理(consolidation):记忆文件数超过阈值(比如 10 个)时,跑一次低频合并——把所有记忆发给模型,让它合并重复的、消解矛盾的、删掉过时的,然后用整理结果替换原文件集。这一步很贵,所以要用阈值卡住频率。
9.4 走一遍:同一句话在两个会话里的命运
周一,会话 A:
你说”以后不要在测试里 mock 数据库,我们用 testcontainers”。Agent 照做。会话结束时自动抽取,写入 .memory/no-db-mocking.md,type: feedback,索引更新。
周三,会话 B(全新会话,模型对周一的事一无所知):
系统提示词里带着索引,其中一行是 - [不要 mock 数据库](no-db-mocking.md) — 测试用 testcontainers。你说”给这个 service 补测试”。侧查询判定这条相关,读入正文。Agent 写出的测试直接用了 testcontainers——你一个字都没重复说。
对比一下没有记忆层的情况:周三你得再说一遍,Agent 才知道。第五次重复说同一句话时,你就会开始怀疑这东西到底省了你什么时间。
9.5 工程现实
一个成熟实现在这里会多做几件事:
- **相关性判断用模型本身做,而不是向量检索。**对几十条记忆的规模,一次轻量模型调用比维护一套嵌入索引简单得多,效果也够。
- **抽取跑在受限的分叉进程里。**抽取时模型只需要读和写记忆文件,不该有 bash 权限。
- **整理有多重节流。**时间间隔、扫描节流、会话计数、文件锁四层门控,避免频繁触发这个昂贵操作。
- **注入有预算上限。**单个文件截断到一定行数/字节,整个会话的记忆注入总量也要封顶——否则记忆层自己就把上下文吃光了,那就本末倒置了。
- **会话记忆和用户记忆分开存。**前者服务于”压缩后的连续性”,后者服务于”跨会话的持久性”,两者生命周期不同。
9.6 什么不该被记住
这一节可能比前面所有内容都重要。记忆层最大的失败模式不是记不住,是记了一堆垃圾。
不该存的:
- 代码库本身已经记录的东西:目录结构、函数签名、过去的修复、git 历史、
CLAUDE.md里已有的规则。模型可以直接去读,存成记忆只会过期。 - 只对本次对话有意义的细节:“我们刚才在看
parser.py第 88 行”——下次会话这句话毫无价值。 - 未经确认的推测:把”我猜他喜欢简洁的回答”存成事实,之后每次都会照着这条错误的事实办事。
还有一条时效性问题:**记忆反映的是它被写下时的情况。**如果一条记忆提到某个文件、某个函数、某个命令行参数,用之前先确认它还存在。不然你会得到一个自信地引用着半年前已被删除的接口的 Agent。