第 2 章 / 共 21 章
工具调度表:从一把钥匙到一串钥匙
上一章留下的问题:只有 bash 一把工具时,模型想读一个文件,得先在脑子里把”读文件”翻译成 cat path/to/file,再把命令写出来。这层翻译既费 token,又容易出错——路径带空格、需要转义、想读前 50 行还得再套 head。更麻烦的是,bash 是一把万能钥匙,你没法对”读文件”和”删除整个磁盘”施加不同的管控。
2.1 加一个工具,只加一行
解法朴素到有点反高潮:**把”工具名 → 处理函数”做成一张字典。**加一个工具 = 在数组里加一条定义,在字典里加一行映射。
循环里唯一变化的是这两行:
# 第1章
output = run_bash(block.input["command"])

# 第2章
handler = TOOL_HANDLERS[block.name]
output = handler(**block.input)
while True、stop_reason 判断、消息追加,全都原封不动。这就是第2章要教给你的全部结构性洞察:能力横向扩展,内核纵向不动。
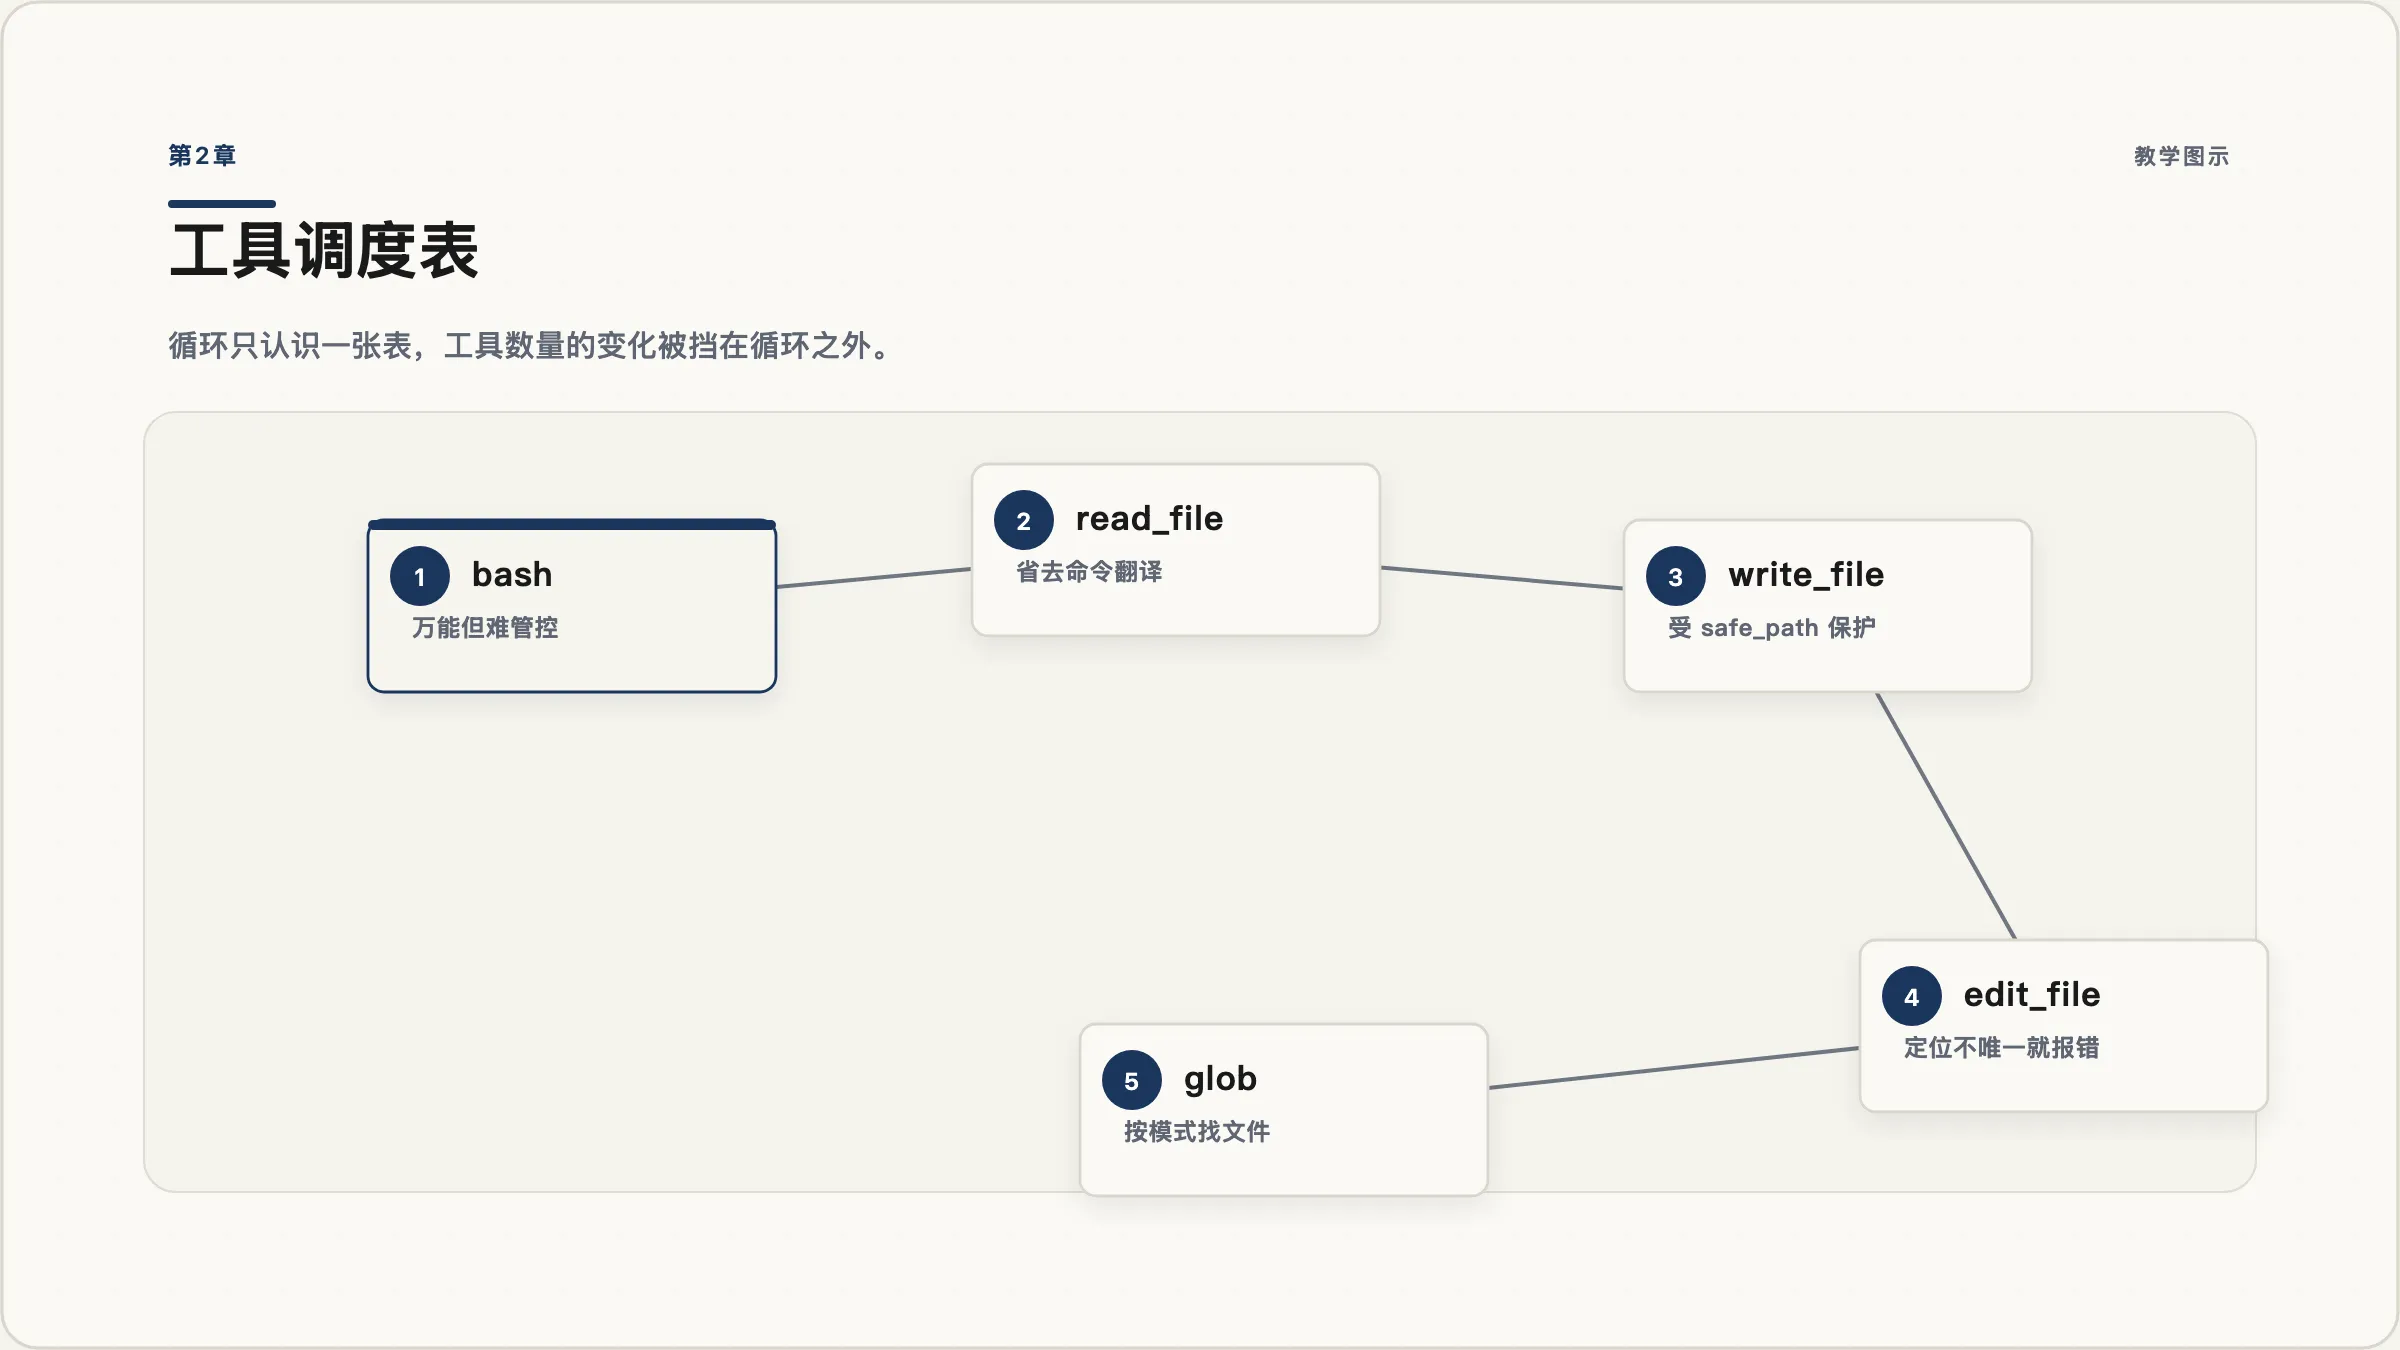
2.2 五把工具
给它一组常用的:
TOOLS = [
    {"name": "bash",       "description": "执行一条 shell 命令。", "input_schema": {...}},
    {"name": "read_file",  "description": "读取文件内容,可用 limit 限制行数。", "input_schema": {...}},
    {"name": "write_file", "description": "把内容写入文件,覆盖已有内容。", "input_schema": {...}},
    {"name": "edit_file",  "description": "在文件中把 old 替换为 new,只替换一次。", "input_schema": {...}},
    {"name": "glob",       "description": "按通配符查找文件,如 **/*.py。", "input_schema": {...}},
]
处理函数各自很短:
from pathlib import Path

WORKDIR = Path("/tmp/agent-sandbox").resolve()

def safe_path(path: str) -> Path:
    """把相对路径解析到工作目录内,并拒绝越界。"""
    p = (WORKDIR / path).resolve()
    if not p.is_relative_to(WORKDIR):
        raise ValueError(f"路径越界:{path}")
    return p

def run_read(path: str, limit: int | None = None) -> str:
    lines = safe_path(path).read_text().splitlines()
    if limit:
        lines = lines[:limit]
    return "\n".join(lines)

def run_write(path: str, content: str) -> str:
    p = safe_path(path)
    p.parent.mkdir(parents=True, exist_ok=True)
    p.write_text(content)
    return f"已写入 {path}({len(content)} 字符)"

def run_edit(path: str, old: str, new: str) -> str:
    p = safe_path(path)
    text = p.read_text()
    if text.count(old) != 1:
        return f"替换失败:old 在文件中出现 {text.count(old)} 次,需要恰好 1 次。"
    p.write_text(text.replace(old, new, 1))
    return f"已修改 {path}"

def run_glob(pattern: str) -> str:
    import glob as g
    return "\n".join(g.glob(pattern, root_dir=WORKDIR)) or "(无匹配)"

TOOL_HANDLERS = {
    "bash": run_bash,
    "read_file": run_read,
    "write_file": run_write,
    "edit_file": run_edit,
    "glob": run_glob,
}
run_edit 里那个”必须恰好出现一次”的检查值得单独说一句。它看起来像是在给模型添堵,实际上是在逼出一个明确的失败:与其在文件里悄悄替换掉三处、其中两处是误伤,不如直接告诉模型”你的定位不够唯一,请把上下文写长一点”。让工具在模糊的时候报错,比让它猜要安全得多。
2.3 走一遍:同样的任务,省下多少事
还是”统计 Python 文件并看看最大的三个”,对比两版的动作:
| 第1章(只有 bash) | 第2章(五把工具) | |
|---|---|---|
| 找文件 | bash: find . -name '*.py' | glob: **/*.py |
| 读某个文件前 50 行 | bash: head -n 50 src/main.py | read_file: path=src/main.py, limit=50 |
| 改一行配置 | bash: sed -i 's/old/new/' cfg.py(还得担心转义和 macOS/Linux 的 -i 差异) | edit_file: path=cfg.py, old=..., new=... |
| 路径越界保护 | 无 | safe_path 直接拒绝 |
专用工具让模型少写一层翻译,也让你多了一个可以单独管控的接缝。
2.4 工程现实:并行与顺序
模型在一条回复里可以同时返回多个 tool_use 块——比如一次性读三个文件。教学版按原顺序逐个执行,简单可读。生产实现会区分工具是否”并发安全”:读文件、grep、glob 这类只读操作可以并发跑,写文件和 bash 通常保持串行。
不管并发还是串行,有一条约束不能破:**这一轮所有的 tool_result 必须放进同一条 user 消息里。**拆成多条 user 消息,模型会慢慢学会”不要并行调工具了”,你的吞吐反而掉下去。