第 13 章 / 共 21 章
后台任务:让慢命令不再阻塞推理
上一章留下的问题:任务图告诉 Agent “现在可以同时做 B 和 D”,可它做不到——因为它是单线程的:调 npm install,subprocess.run 一直阻塞到命令结束,这三分钟里 Agent 什么也干不了。
而这三分钟是纯粹的浪费。模型按 token 计费,但”等待”本身没有产出。真实项目里,npm install、docker build、跑完整测试套件动辄好几分钟,一个下午能这样耗掉一半。
13.1 三条泳道
思路是把执行分成三条独立的通道:
| 泳道 | 谁在跑 | 干什么 |
|---|---|---|
| 主线程 | 循环 | 调模型、执行快工具、继续推理 |
| 后台线程 | 守护线程 | 跑慢命令,跑完把结果记下来 |
| 通知队列 | 中间层 | 每轮把已完成的后台任务变成消息,注入对话 |
关键在于第三条。后台线程跑完之后,结果不能凭空进入模型的视野——需要有一个明确的机制把它注入对话流。
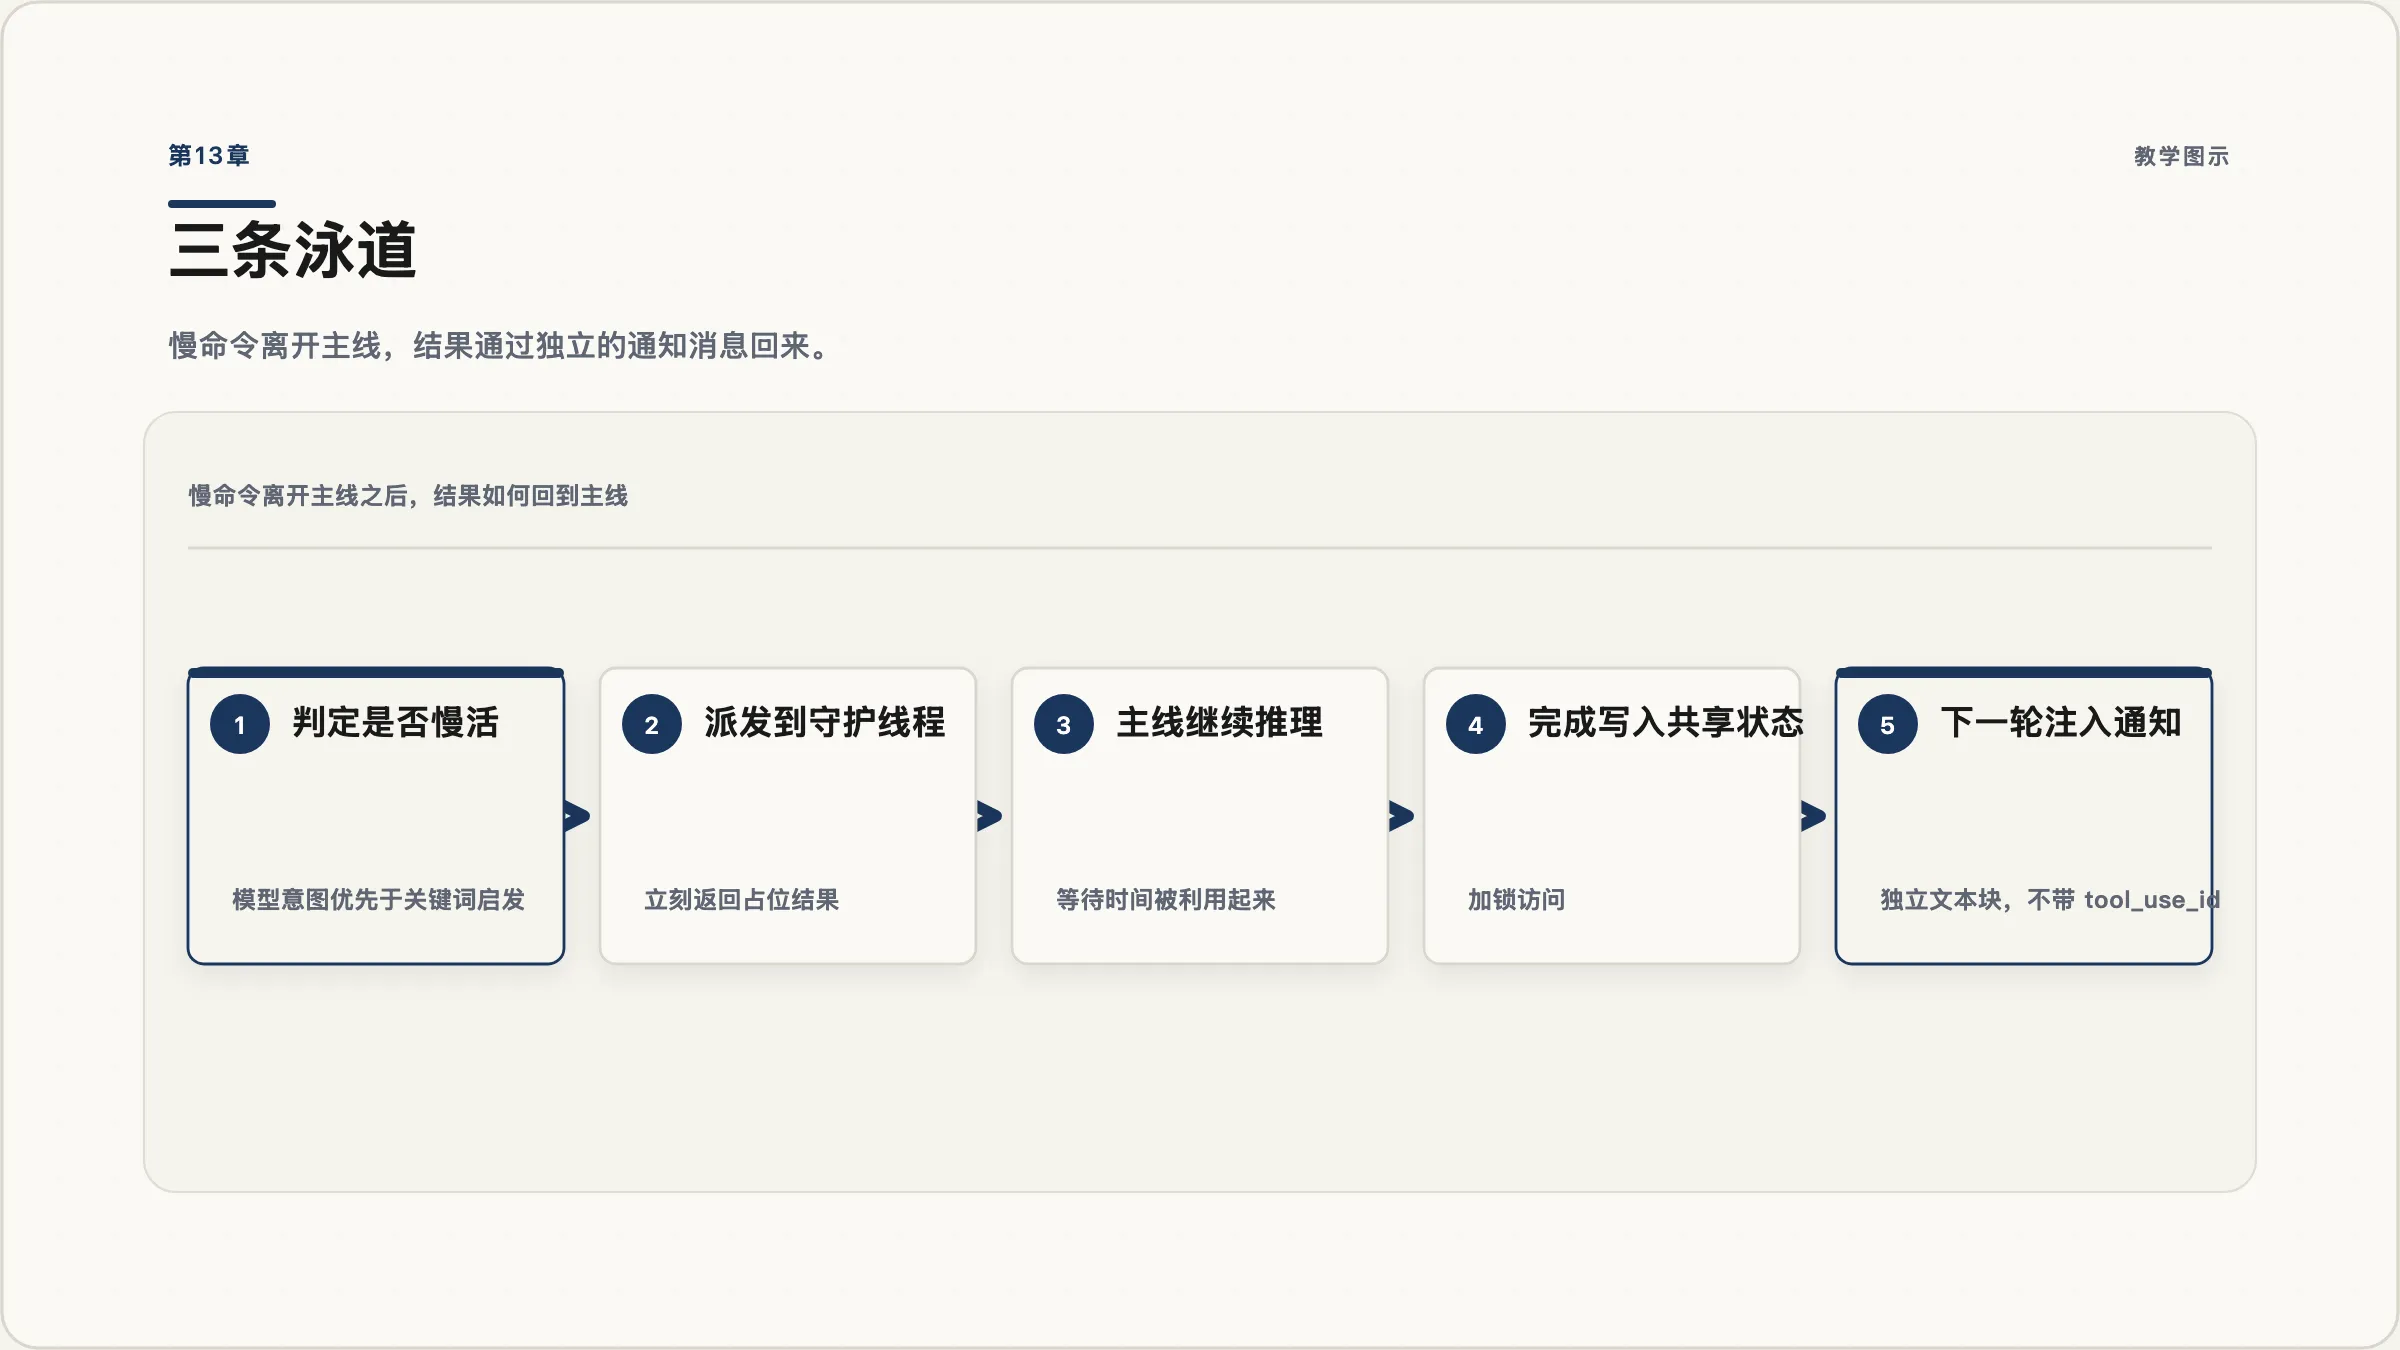
tool_use 上,而是作为一条独立的通知消息进入下一轮。理解了这条虚线为什么不能接回原处,就理解了本章最重要的约束。13.2 谁来决定跑后台
两个来源,模型的意图优先:
def should_run_background(tool_name: str, tool_input: dict) -> bool:
    if tool_input.get("run_in_background"):        # 模型显式要求,优先
        return True
    return is_slow_operation(tool_name, tool_input)  # 兜底启发式

SLOW_KEYWORDS = ["install", "build", "test", "deploy", "compile", "docker", "migrate"]

def is_slow_operation(tool_name: str, tool_input: dict) -> bool:
    if tool_name != "bash":
        return False
    cmd = tool_input.get("command", "")
    return any(kw in cmd for kw in SLOW_KEYWORDS)
在 bash 工具的 schema 里加一个布尔参数 run_in_background,描述写清楚”预计超过 30 秒的命令请设为 true”。让模型显式表达意图,比你用关键词猜要可靠得多——它知道自己在跑什么,而关键词表永远会漏(比如 make 就不在上面的列表里)。启发式只是兜底。
13.3 派发与回收
import threading

_bg_tasks: dict[str, dict] = {}
_bg_lock = threading.Lock()
_bg_counter = 0

def start_background_task(block) -> str:
    global _bg_counter
    _bg_counter += 1
    bg_id = f"bg_{_bg_counter:04d}"
    command = block.input.get("command", "")

    with _bg_lock:
        _bg_tasks[bg_id] = {"tool_use_id": block.id, "command": command,
                            "status": "running", "output": ""}

    def worker():
        try:
            output = TOOL_HANDLERS[block.name](**block.input)
        except Exception as e:
            output = f"后台任务失败:{e}"
        with _bg_lock:
            _bg_tasks[bg_id]["status"] = "completed"
            _bg_tasks[bg_id]["output"] = output

    threading.Thread(target=worker, daemon=True).start()
    return bg_id

def collect_background_results() -> list[str]:
    notifications = []
    with _bg_lock:
        for bg_id, task in _bg_tasks.items():
            if task["status"] == "completed" and not task.get("reported"):
                task["reported"] = True
                excerpt = task["output"][:2000]
                notifications.append(
                    f"<task_notification>\n"
                    f"  <task_id>{bg_id}</task_id>\n"
                    f"  <status>completed</status>\n"
                    f"  <command>{task['command']}</command>\n"
                    f"  <output>{excerpt}</output>\n"
                    f"</task_notification>")
    return notifications
循环里的接法:
        for block in response.content:
            if block.type == "tool_use":
                if should_run_background(block.name, block.input):
                    bg_id = start_background_task(block)
                    results.append({"type": "tool_result", "tool_use_id": block.id,
                                    "content": f"已在后台启动,任务 ID:{bg_id}。"
                                               f"完成后你会收到通知,期间可以继续做别的事。"})
                else:
                    output = TOOL_HANDLERS[block.name](**block.input)
                    results.append({"type": "tool_result", "tool_use_id": block.id, "content": output})

        for note in collect_background_results():          # 把完成通知并进同一条消息
            results.append({"type": "text", "text": note})
        messages.append({"role": "user", "content": results})
13.4 那条最容易踩的约束
后台任务完成时,你可能很自然地想把结果作为那个原始 tool_use 的 tool_result 回传。不行。
Messages API 有一条硬约束:**每个 tool_use 有且只有一个 tool_result。**而你在派发时已经回过一个”已在后台启动”的占位结果了。再回一个,就是重复配对,API 直接报错。
所以通知必须用另一种形式——上面代码里的 <task_notification> 是一个普通的文本块,不带任何 tool_use_id。它和 tool_result 一起放在同一条 user 消息里,模型能读到,但它在协议层面是独立的。
用 XML 标签而不是纯文本,是为了让模型一眼分清”这是后台完成事件”和”这是我刚才那次调用的返回值”。这两者在语义上完全不同——一个是异步事件,一个是同步返回。
13.5 走一遍:省下来的三分钟
任务:“安装依赖,然后更新 README 里的安装说明。”
| 时刻 | 主线程 | 后台 |
|---|---|---|
| T0 | bash: npm install,判定为慢 → 派发,立刻拿到 bg_0001 | 开始跑 |
| T0+2s | 继续推理:read_file: README.md | 跑着 |
| T0+8s | edit_file: README.md 更新安装说明 | 跑着 |
| T0+15s | 模型说”README 已更新,等 npm 完成后确认” | 跑着 |
| T0+180s | 下一轮收到 <task_notification>,看到安装成功 | 完成 |
| T0+182s | 模型确认两件事都做完了 | — |
同样的任务,同步版本要 195 秒(180 秒纯等 + 15 秒干活),异步版本 182 秒,而且那 15 秒是和等待重叠的。任务越多、慢活越多,这个差距越大。
13.6 工程现实
- 静默失败:后台线程崩了却不更新状态,Agent 会一直以为它还在跑。教学版用 try/except 兜住异常并写进状态,生产实现还会加看门狗和停滞检测。
- 交互式命令会挂死:等待输入密码的命令在后台会永远等下去。成熟实现会检测长时间无输出(比如 45 秒)并识别
(y/n)这类交互提示,然后主动报警。 - 并发上限:不能让模型无限派发后台任务。设一个上限(比如同时最多 5 个),超了就排队或拒绝。
- 进程退出时的清理:
daemon=True意味着主进程退出时后台线程直接被杀,跑到一半的构建不会有任何交代。需要在退出前给一个汇报机会。