第 10 章 / 共 21 章
系统提示词组装:按运行时状态拼装身份
上一章留下的问题:数一数现在系统提示词里有多少东西——身份说明、工具使用建议、工作目录、技能目录、记忆索引。这还只是第10章,后面还有任务系统、团队、MCP。如果继续用一段硬编码的长字符串,你会遇到三个具体麻烦:
- 换个项目就要重写整段,还说不清哪几行必须改;
- 改一处,可能悄悄破坏了另一处依赖它的表述;
- 每次调用都带上全部内容,哪怕这次根本没有记忆、没有技能。
10.1 分段 + 条件装配
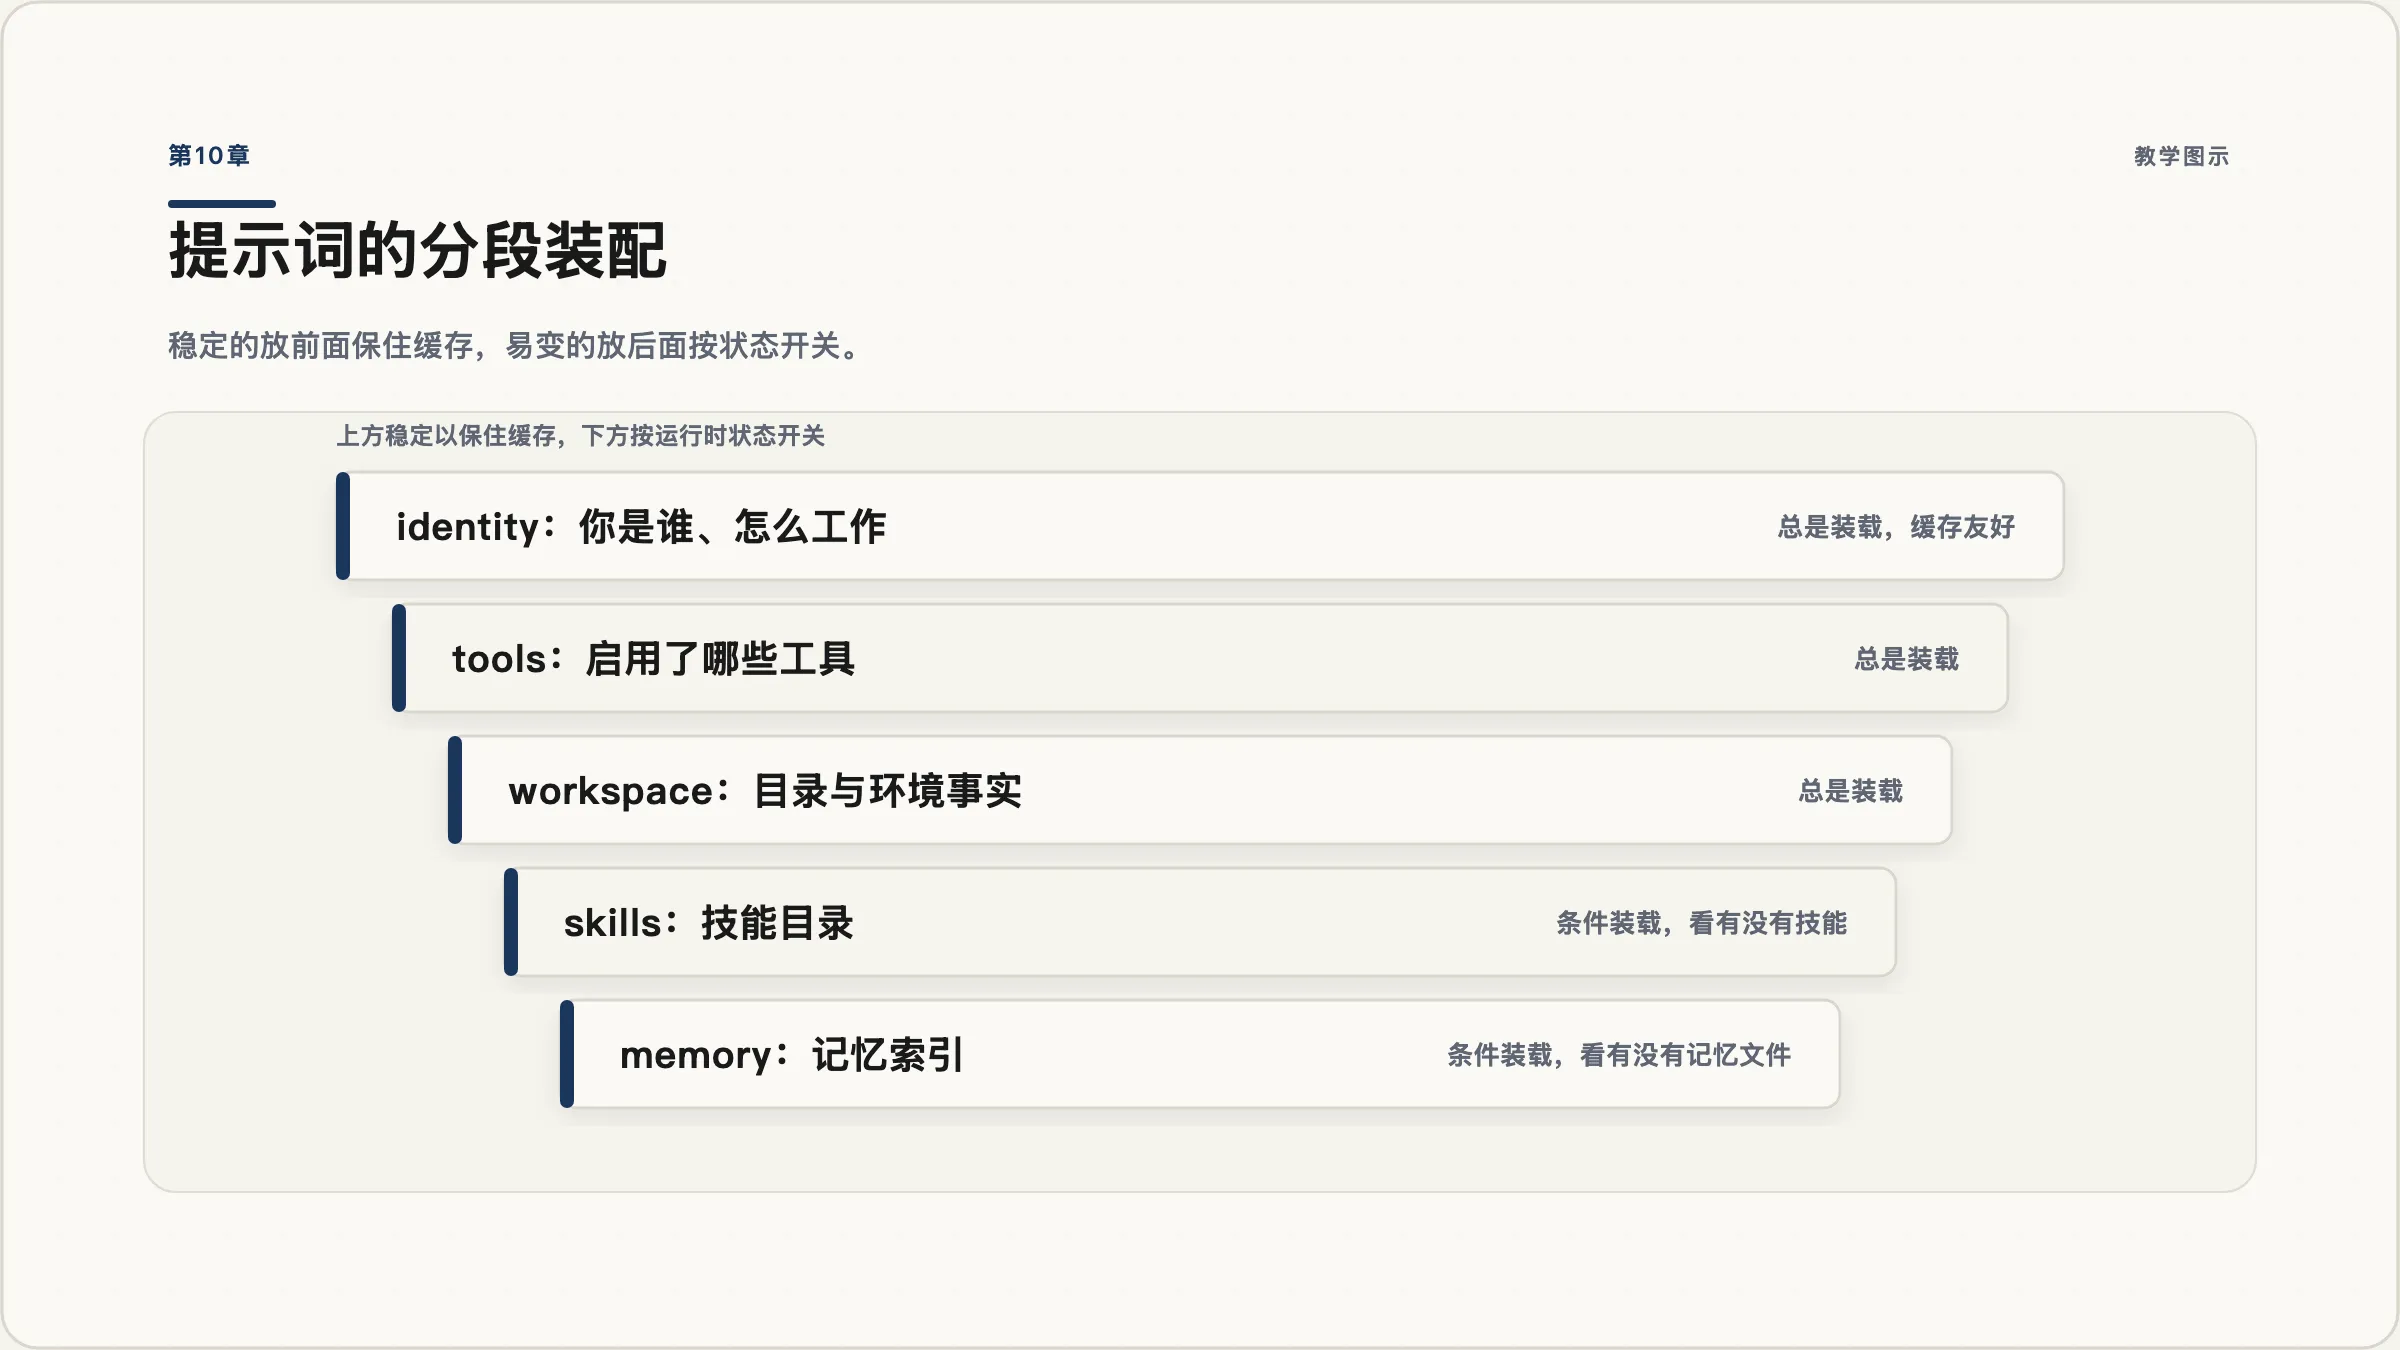
把提示词切成互相独立的片段,每段有自己的装载策略:
| 片段 | 策略 | 内容 |
|---|---|---|
identity | 总是 | 你是谁、你的工作方式 |
tools | 总是 | 当前启用了哪些工具、什么时候用哪个 |
workspace | 总是 | 工作目录、当前分支等环境事实 |
skills | 有技能才带 | 技能目录 |
memory | 有记忆才带 | 记忆索引 |
PROMPT_SECTIONS = {
    "identity": "你是一个命令行开发助手。先理解,再动手;改动前先读现状。",
    "tools":    "你可以使用工具完成任务。文件操作优先用专用工具,复杂操作再用 bash。",
}

def assemble_system_prompt(context: dict) -> str:
    sections = [PROMPT_SECTIONS["identity"], PROMPT_SECTIONS["tools"]]
    sections.append(f"工作目录:{context['workdir']}")

    if context.get("skills_catalog"):
        sections.append(context["skills_catalog"])
    if context.get("memory_index"):
        sections.append(f"已知的长期事实(索引):\n{context['memory_index']}")
    if context.get("mcp_servers"):
        sections.append(f"已连接的外部服务:{', '.join(context['mcp_servers'])}")

return "\n\n".join(sections)注意条件判断的依据是”真实状态”,不是”关键词”。if context.get("memory_index") 问的是”现在到底有没有记忆索引”,而不是”用户这句话里有没有提到’记住’“。用关键词猜意图,是这一层最常见的错误——用户说”按老规矩来”时不会出现任何关键词,但记忆恰恰是这时候最该带上的。
10.2 缓存:别每轮都重新拼
拼装本身很便宜,但如果状态没变,重复拼装是无谓的。更重要的是,提示词的字节稳定性直接影响 API 侧的提示词缓存命中率——系统提示词哪怕改一个字符,后面所有缓存都会失效。
import json

_prompt_cache: dict[str, str] = {}

def get_system_prompt(context: dict) -> str:
    key = json.dumps(context, sort_keys=True, default=str)
    if key not in _prompt_cache:
        _prompt_cache[key] = assemble_system_prompt(context)
    return _prompt_cache[key]
用 json.dumps(..., sort_keys=True) 而不是 hash(),有两个理由:hash() 对字符串在不同进程间不稳定(Python 默认开启哈希随机化),而且字典本身不可哈希。sort_keys=True 保证同样的状态一定序列化出同样的字节。
顺带记住一条实践准则:**稳定的内容放前面,易变的内容放后面。**系统提示词里如果混进了 datetime.now() 或者每次都变的请求 ID,缓存命中率会直接归零,而你在账单上才会发现。
10.3 走一遍:三种状态下的同一个 Agent
| 场景 | 装配出的片段 | 大致长度 |
|---|---|---|
| 全新项目,无技能无记忆 | identity + tools + workspace | 短 |
| 老项目,有 4 个技能、12 条记忆 | 上面三段 + 技能目录 + 记忆索引 | 中 |
| 老项目 + 已连接 2 个 MCP 服务 | 再加一段外部服务说明 | 长 |
同一份代码,三种身份。你没有为”全新项目”这个场景付技能目录和记忆索引的费用,也不用为它单独维护一份提示词。
10.4 提示词分段的写作建议
分段之后,每一段的写法也值得讲究:
- 一段只讲一件事。
identity里不要混进工具说明,否则改工具时要在两个地方找。 - 写行为约束,不写抽象品质。“改动文件前先读一遍现状”比”你是一个严谨的助手”有用得多。
- **给冲突定优先级。**当片段变多,指令难免打架。在
identity里写清”发生冲突时以哪一层为准”。 - **别写”不要做 X”却不给替代方案。**只说禁止,模型容易卡住;说”不要 A,改用 B”,它才知道怎么走。
10.5 工程现实
真实系统里,进程内缓存只是第一层。API 侧还有自己的提示词缓存机制,命中它能显著降低重复前缀的成本。这两层的关注点不同:进程内缓存省的是 CPU,API 缓存省的是钱。
还有一个后面会踩到的坑先预告:**第19章连接 MCP 服务之后,工具列表会变,系统提示词也得跟着变。**如果那时你的缓存键里没包含”已连接哪些服务”,模型会拿着一份过期的提示词去用新工具。这就是为什么 context 要如实反映所有影响提示词的状态。