第 1 章 / 共 21 章
一个 while 循环:Agent 的最小内核
1.1 让你变成中间件的那个瞬间
设想你要让模型帮你统计一个项目里有多少个 Python 文件。你问它,它回答:“你可以运行 find . -name '*.py' | wc -l。”
于是你打开终端,粘贴,回车,看到输出 47,再切回聊天窗口把 47 贴给它。它说:“好的,一共 47 个文件。接下来我需要看看其中最大的几个,请运行 ls -S……”
注意这个循环里各人的分工:**模型负责决定做什么,你负责执行,还负责把结果搬回去。**模型缺的不是智力,是手,和一个愿意帮它跑腿的循环。
那个循环,写出来只有几行。
1.2 唯一的控制信号:stop_reason
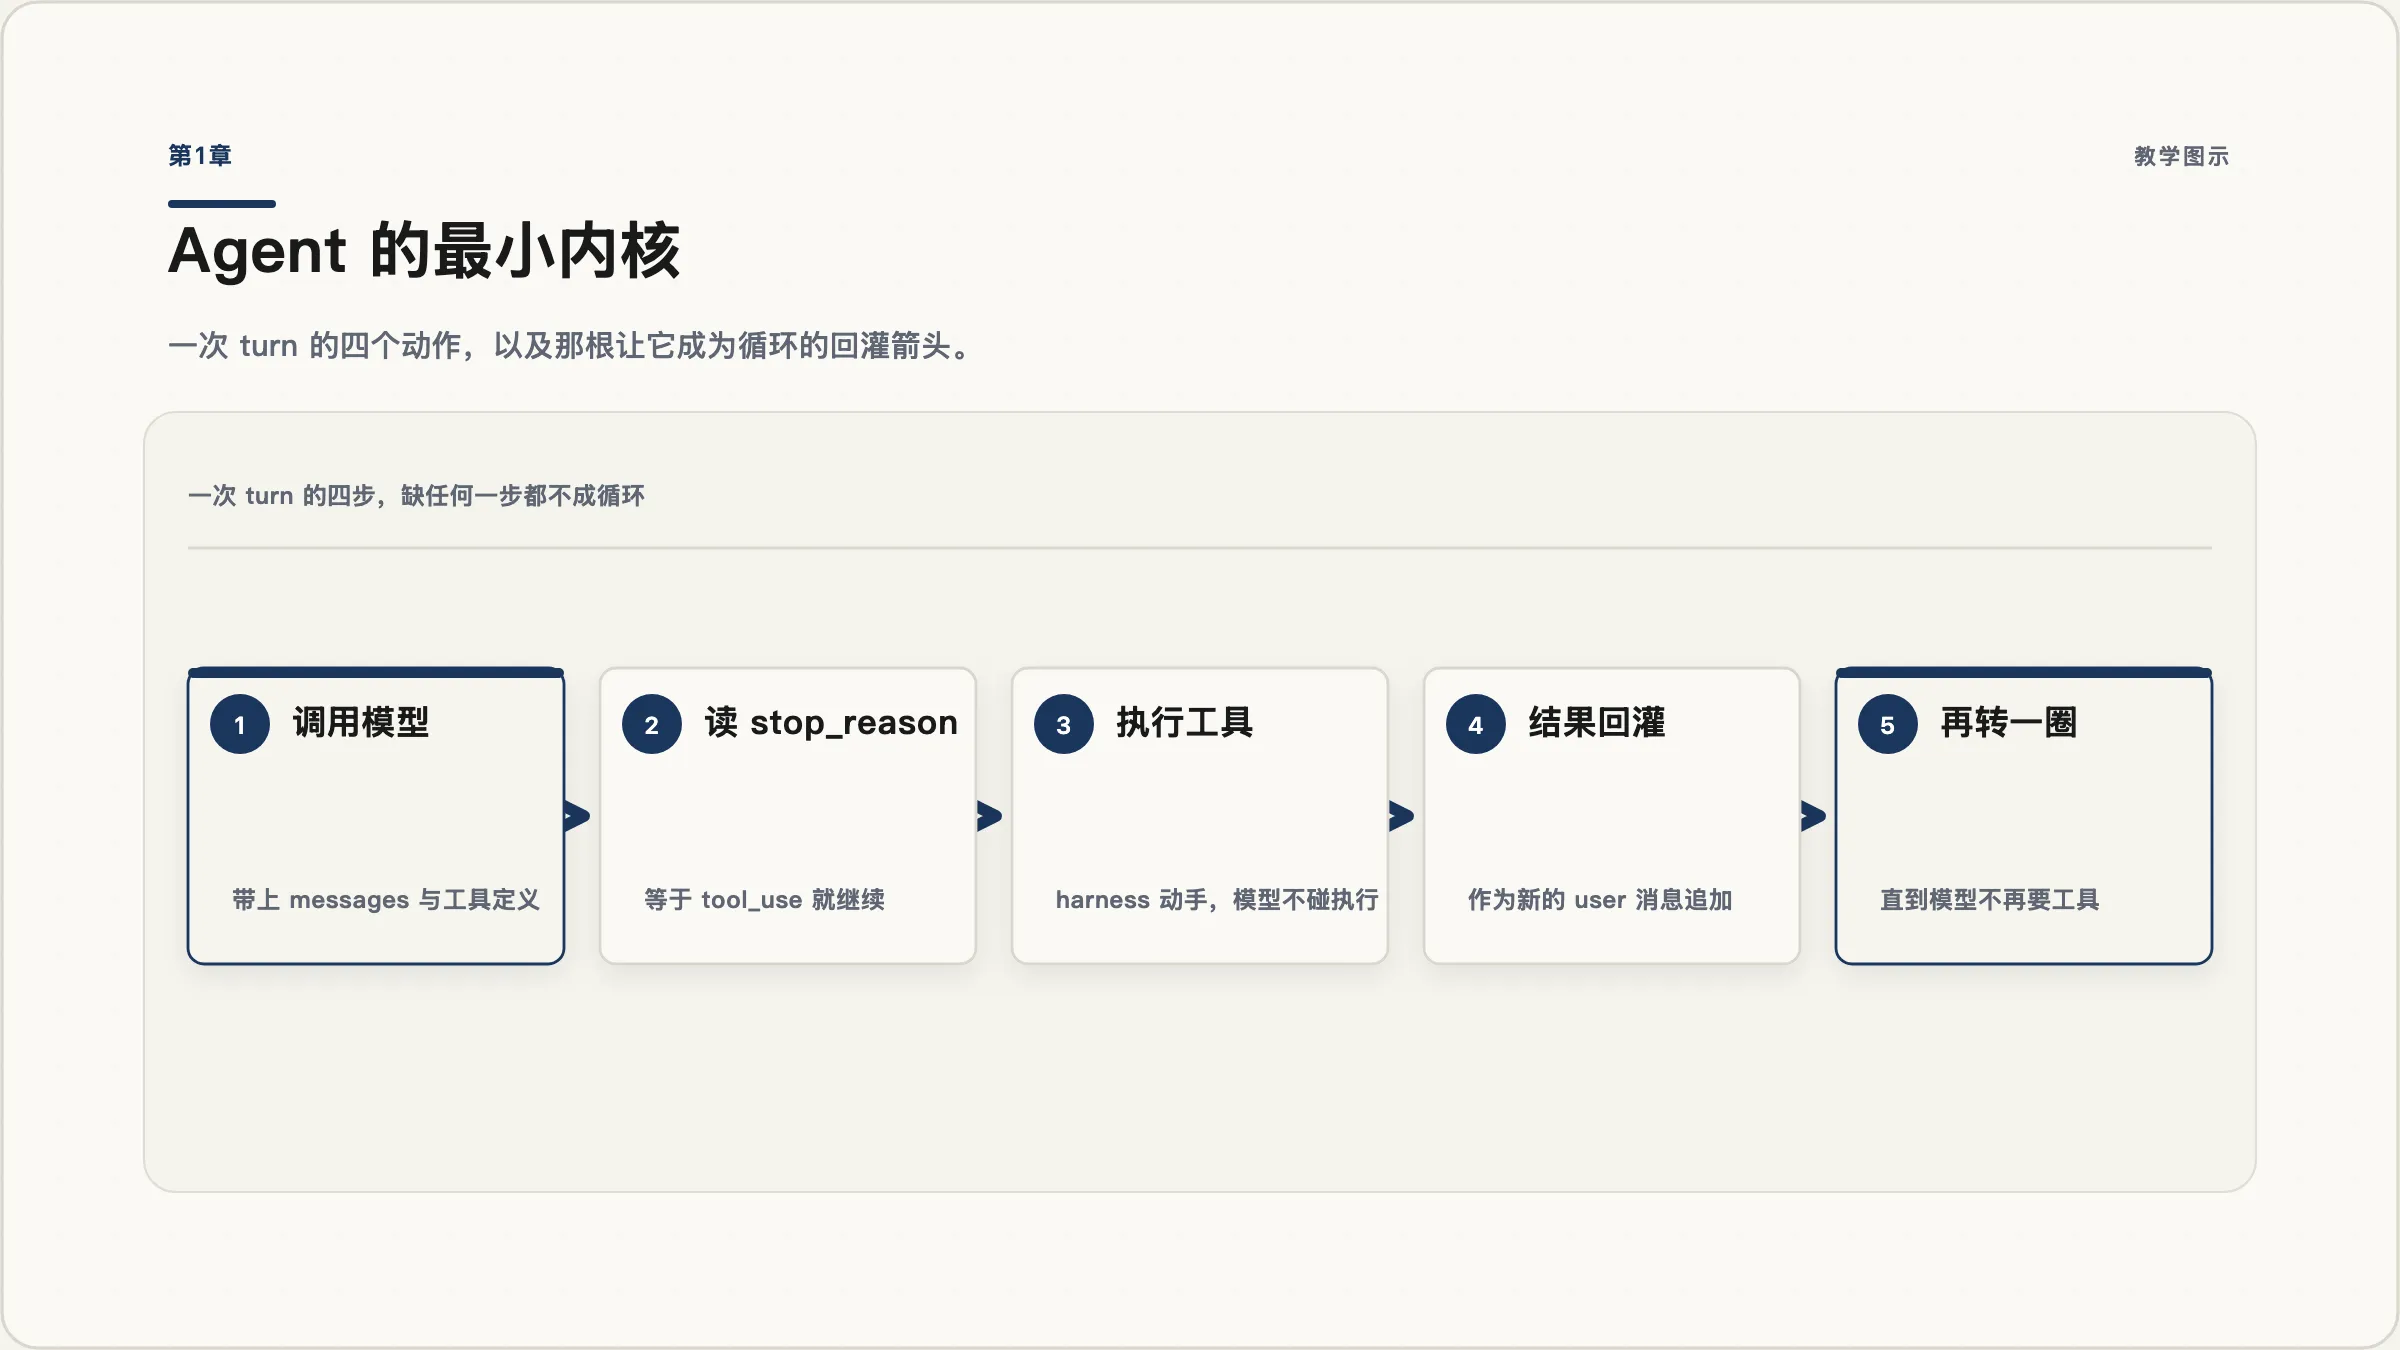
模型返回的每条消息都带一个字段 stop_reason,它告诉你模型为什么停下来。对我们来说,全部逻辑压缩成一句判断:
stop_reason | 含义 | 循环该做什么 |
|---|---|---|
tool_use | 模型想调工具,话还没说完 | 执行工具 → 把结果喂回去 → 再转一圈 |
其他(end_turn 等) | 模型说完了 | 退出循环 |
就这一个布尔判断,撑起了整个 Agent 的自主性。模型决定”要不要用工具、用哪个”,循环负责”执行并回灌”。职责分离得非常干净:模型不碰执行,循环不做判断。
stop_reason 还有几个值你迟早会遇到——max_tokens(输出被截断)、pause_turn(可恢复的暂停)、refusal(模型出于安全拒绝)。第11章会专门处理它们,现在先只认 tool_use 这一个。
1.3 三十行,跑起来
先定义一把工具。第一版只给它 bash——一把万能钥匙,够用来体会自主性:
import subprocess
import anthropic

client = anthropic.Anthropic()
MODEL = "claude-opus-5"
WORKDIR = "/tmp/agent-sandbox"        # 务必用临时目录

SYSTEM = "你是一个命令行助手。需要了解或改动文件系统时,调用 bash 工具。"

TOOLS = [{
    "name": "bash",
    "description": "在工作目录下执行一条 shell 命令,返回它的标准输出与标准错误。",
    "input_schema": {
        "type": "object",
        "properties": {
            "command": {"type": "string", "description": "要执行的 shell 命令"}
        },
        "required": ["command"],
    },
}]

def run_bash(command: str) -> str:
    result = subprocess.run(
        command, shell=True, cwd=WORKDIR,
        capture_output=True, text=True, timeout=60,
    )
    return (result.stdout + result.stderr)[:20000] or "(无输出)"
然后是全书唯一不变的那段代码:
def agent_loop(messages: list) -> None:
    while True:
        response = client.messages.create(
            model=MODEL, system=SYSTEM, messages=messages,
            tools=TOOLS, max_tokens=8000,
        )
        messages.append({"role": "assistant", "content": response.content})

        if response.stop_reason != "tool_use":
            return                                    # 模型说完了,收工

        results = []
        for block in response.content:
            if block.type == "tool_use":
                output = run_bash(block.input["command"])
                results.append({
                    "type": "tool_result",
                    "tool_use_id": block.id,
                    "content": output,
                })
        messages.append({"role": "user", "content": results})
跑起来:
agent_loop([{"role": "user", "content": "统计当前目录下有多少个 Python 文件,并告诉我最大的三个。"}])它会自己调 find、自己调 ls -S、自己把两次结果串起来给你结论。中间没有你的任何一次复制粘贴。
1.4 走一遍:消息数组到底发生了什么
把上面那次运行拆开看,messages 数组是这样长大的:
| 轮次 | 追加了什么 | 长度 |
|---|---|---|
| 起点 | user:统计 Python 文件…… | 1 |
| 第 1 轮 | assistant:tool_use(find . -name '*.py') | 2 |
user:tool_result → 47 个路径 | 3 | |
| 第 2 轮 | assistant:tool_use(ls -S ...) | 4 |
user:tool_result → 按大小排序的列表 | 5 | |
| 第 3 轮 | assistant:文本结论,stop_reason = end_turn | 6 |
三件事值得注意:
- **API 是无状态的。**每一轮你都要把完整的
messages再发一次。所谓”记忆”,此刻就等于这个数组。这也预告了第8、9两章的麻烦:数组会一直变长。 tool_result必须和tool_use一一配对。每个tool_use_id要有且只有一个对应的结果块。模型一次返回多个tool_use时,所有结果要放进同一条 user 消息里;拆成多条会破坏配对,而且会让模型逐渐不再并行调工具。- **工具失败也要回传。**不要因为命令报错就把结果丢掉——把错误文本当作
tool_result的内容回去(更严谨的做法是带上is_error: true),模型看到报错才知道换个思路。悄悄吞掉错误,模型只会以为自己成功了。
1.5 工程现实:这三十行离生产有多远
原课程的作者读过一份真实 Agent 产品的实现,那份代码在对应文件里有一千七百多行,而内核仍然是这段 while True。多出来的一千六百行是十来个状态字段、多条退出路径、token 恢复、主动压缩、权限检查——全是保护机制,不是新的内核。
有一处差异现在就值得记住:生产实现不完全依赖 stop_reason == "tool_use" 来判断是否继续,而是维护一个类似 needsFollowUp 的标志。原因是在流式响应里,tool_use 内容块会先到,stop_reason 更新得不够及时。你的教学版用非流式调用,所以没这个问题;等你换成流式,记得改成”看内容块里有没有 tool_use”。
1.6 该不该做成 Agent
顺手立一个判断标准,免得你把所有东西都做成 Agent。模型厂商自己的建议是把系统分成两类:工作流是用预先写死的代码路径去编排模型调用;Agent 是让模型自己决定流程和工具。Agent 更灵活,但也更贵、更慢、更难预测。
四个问题都答”是”,再上 Agent:
- 复杂度:任务是不是多步、且事先说不清步骤?(“把这份设计文档变成一个 PR”是;“从这份 PDF 里抽出标题”不是。)
- 价值:值不值得为它付更高的成本和延迟?
- 可行性:模型在这类任务上本来就够强吗?
- 纠错成本:出错了能被发现和回滚吗(有测试、有评审、有版本控制)?
有一个答”否”,就退回更简单的那一层——一次调用,或者一条你自己写死的流水线。