第 6 章 / 共 21 章
子代理:用上下文隔离换取专注
上一章留下的问题:清单解决了”忘记目标”,但没解决”上下文被撑爆”。设想 Agent 要定位一个跨越三十个文件的 bug:它读文件、看调用链、试探性地加日志、跑测试——六十轮下来,messages 里塞满了三十份文件内容和几十条命令输出。而这些中间过程,对于接下来要做的事几乎毫无价值:真正有用的只有一句”问题出在 parser.py 第 88 行的空值处理”。
你自己排查 bug 时是怎么做的?大概率是新开一个终端窗口,在那里翻来翻去,找到结论以后记在笔记里,然后关掉那个窗口,回到原来的窗口继续干活。那些翻找过程不需要留在你的主工作区里。
6.1 把子任务丢进一个新的对话
给 Agent 加一把 task 工具:它接收一段任务描述,开一个全新的 messages 数组,在里面跑一个独立的小循环,最后只把最终那段文字返回。
SUB_SYSTEM = "你是一个专注的子任务执行者。完成任务后,用简洁的文字给出结论,不要复述过程。"

def spawn_subagent(description: str) -> str:
    sub_tools = [t for t in TOOLS if t["name"] != "task"]     # 关键:不给它 task
    messages = [{"role": "user", "content": description}]

    for _ in range(30):                                        # 安全上限
        response = client.messages.create(
            model=MODEL, system=SUB_SYSTEM,
            messages=messages, tools=sub_tools, max_tokens=8000,
        )
        messages.append({"role": "assistant", "content": response.content})
        if response.stop_reason != "tool_use":
            break

        results = []
        for block in response.content:
            if block.type == "tool_use":
                blocked = trigger_hooks("PreToolUse", block)   # 权限照旧生效
                if blocked:
                    results.append({"type": "tool_result", "tool_use_id": block.id,
                                    "content": str(blocked)})
                    continue
                output = TOOL_HANDLERS[block.name](**block.input)
                results.append({"type": "tool_result", "tool_use_id": block.id, "content": output})
        messages.append({"role": "user", "content": results})

    return extract_text(messages[-1]["content"])               # 只带结论回去

TOOL_HANDLERS["task"] = spawn_subagent
这段代码里有四个设计决定,每一个都值得单独理解:
| 决定 | 怎么做的 | 为什么 |
|---|---|---|
| 上下文隔离 | 全新的 messages | 子任务的六十轮翻找不会进入主线 |
| 只回结论 | extract_text(messages[-1]) | 主线拿到的是笔记,不是录像 |
| 防递归 | 子代理的工具列表里剔掉 task | 否则子代理可以再开子代理,无限套娃 |
| 权限不放松 | 子循环里照样触发 PreToolUse | 隔离的是上下文,不是权限 |
最后一条最容易被误解。“独立进程”听起来像是自由了,其实不是——子代理仍然在同一台机器上操作同一个文件系统,护栏一寸都不能松。
6.2 走一遍:一次委派的收支账
任务:“这个项目的 CI 最近变慢了,找出原因并修掉。”
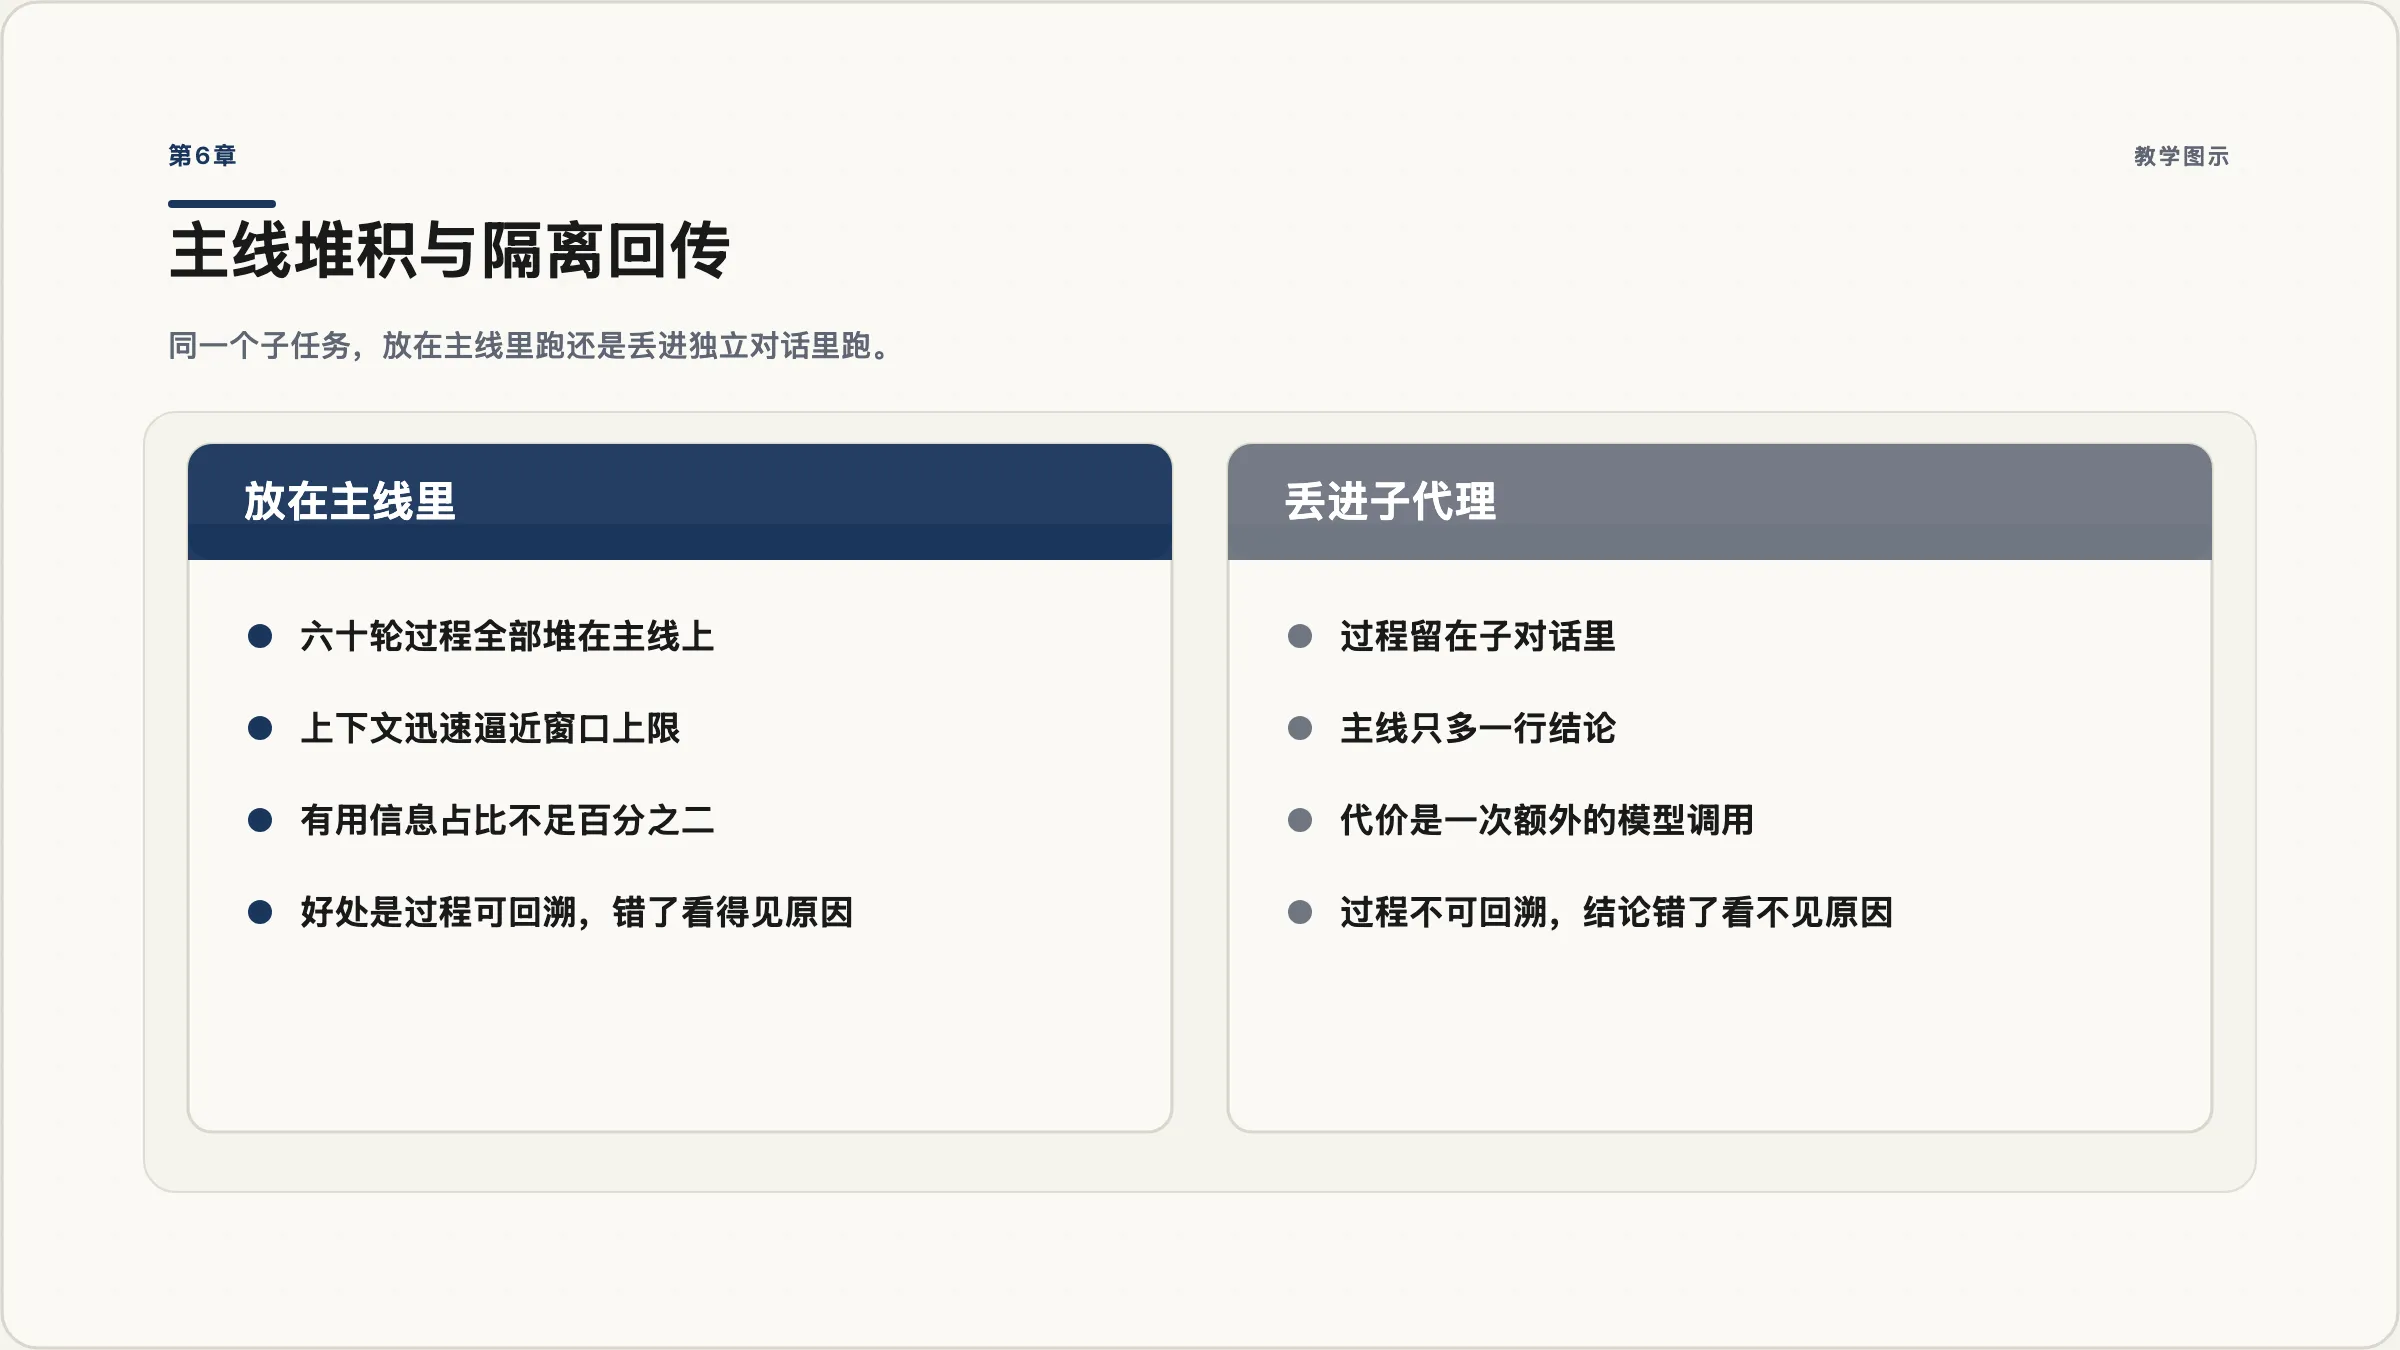
不用子代理时,主线上下文大致是这样堆起来的:CI 配置文件(约 3K token)、最近二十次构建日志(约 40K)、五个测试文件(约 15K)、十几条命令输出(约 8K)——加起来 60K 出头,而其中真正影响后续修复动作的信息不到 1K。
用子代理时:主线调用一次 task("分析最近的 CI 构建日志,找出耗时增加的根本原因"),子代理在自己的对话里烧掉那 60K,返回一句”test_integration.py 里新增的 sleep(30) 是主要原因,占新增耗时的 82%“。主线上下文只增加了这一句。
账要这么算:你省下的是主线上下文,付出的是一次额外的模型调用开销,以及”中间过程不可回溯”——如果子代理的结论是错的,主线看不到它是怎么错的。所以子代理适合结论明确、过程冗长的任务(搜索、定位、调研、批量核对),不适合需要主线持续参与判断的任务。
6.3 工程现实:隔离的边界在哪里
有一件事必须说明白:**只有对话被隔离了,副作用没有。**子代理调用 write_file 写下的文件是真实存在的,跑的命令是真实执行的。它不是沙箱,是一个干净的笔记本。
真正的并行安全需要文件系统级别的隔离——那是第18章 worktree 要解决的问题。
另外,那个 range(30) 的硬上限也不是随手写的。子代理没有人在旁边看着,一旦陷进死循环,你不会立刻发现。给它一个明确的上限,让它”失败得快一点”。