第 11 章 / 共 21 章
错误恢复:先分类,再决定重试什么
上一章留下的问题:到目前为止,我们的代码假设每次 API 调用都成功。真实情况不是这样:模型服务会返回 429(限流)、529(过载);输出会因为撞上 max_tokens 被截断;上下文会超长。任何一个都能让你这个跑了二十分钟的任务瞬间归零。
新手的第一反应是套一个 try: ... except: retry。这在两种情况下是错的:上下文超长时你重试一百次也还是超长;输出被截断时重试等于重来一遍,前面生成的内容白扔。
恢复的前提是分类。
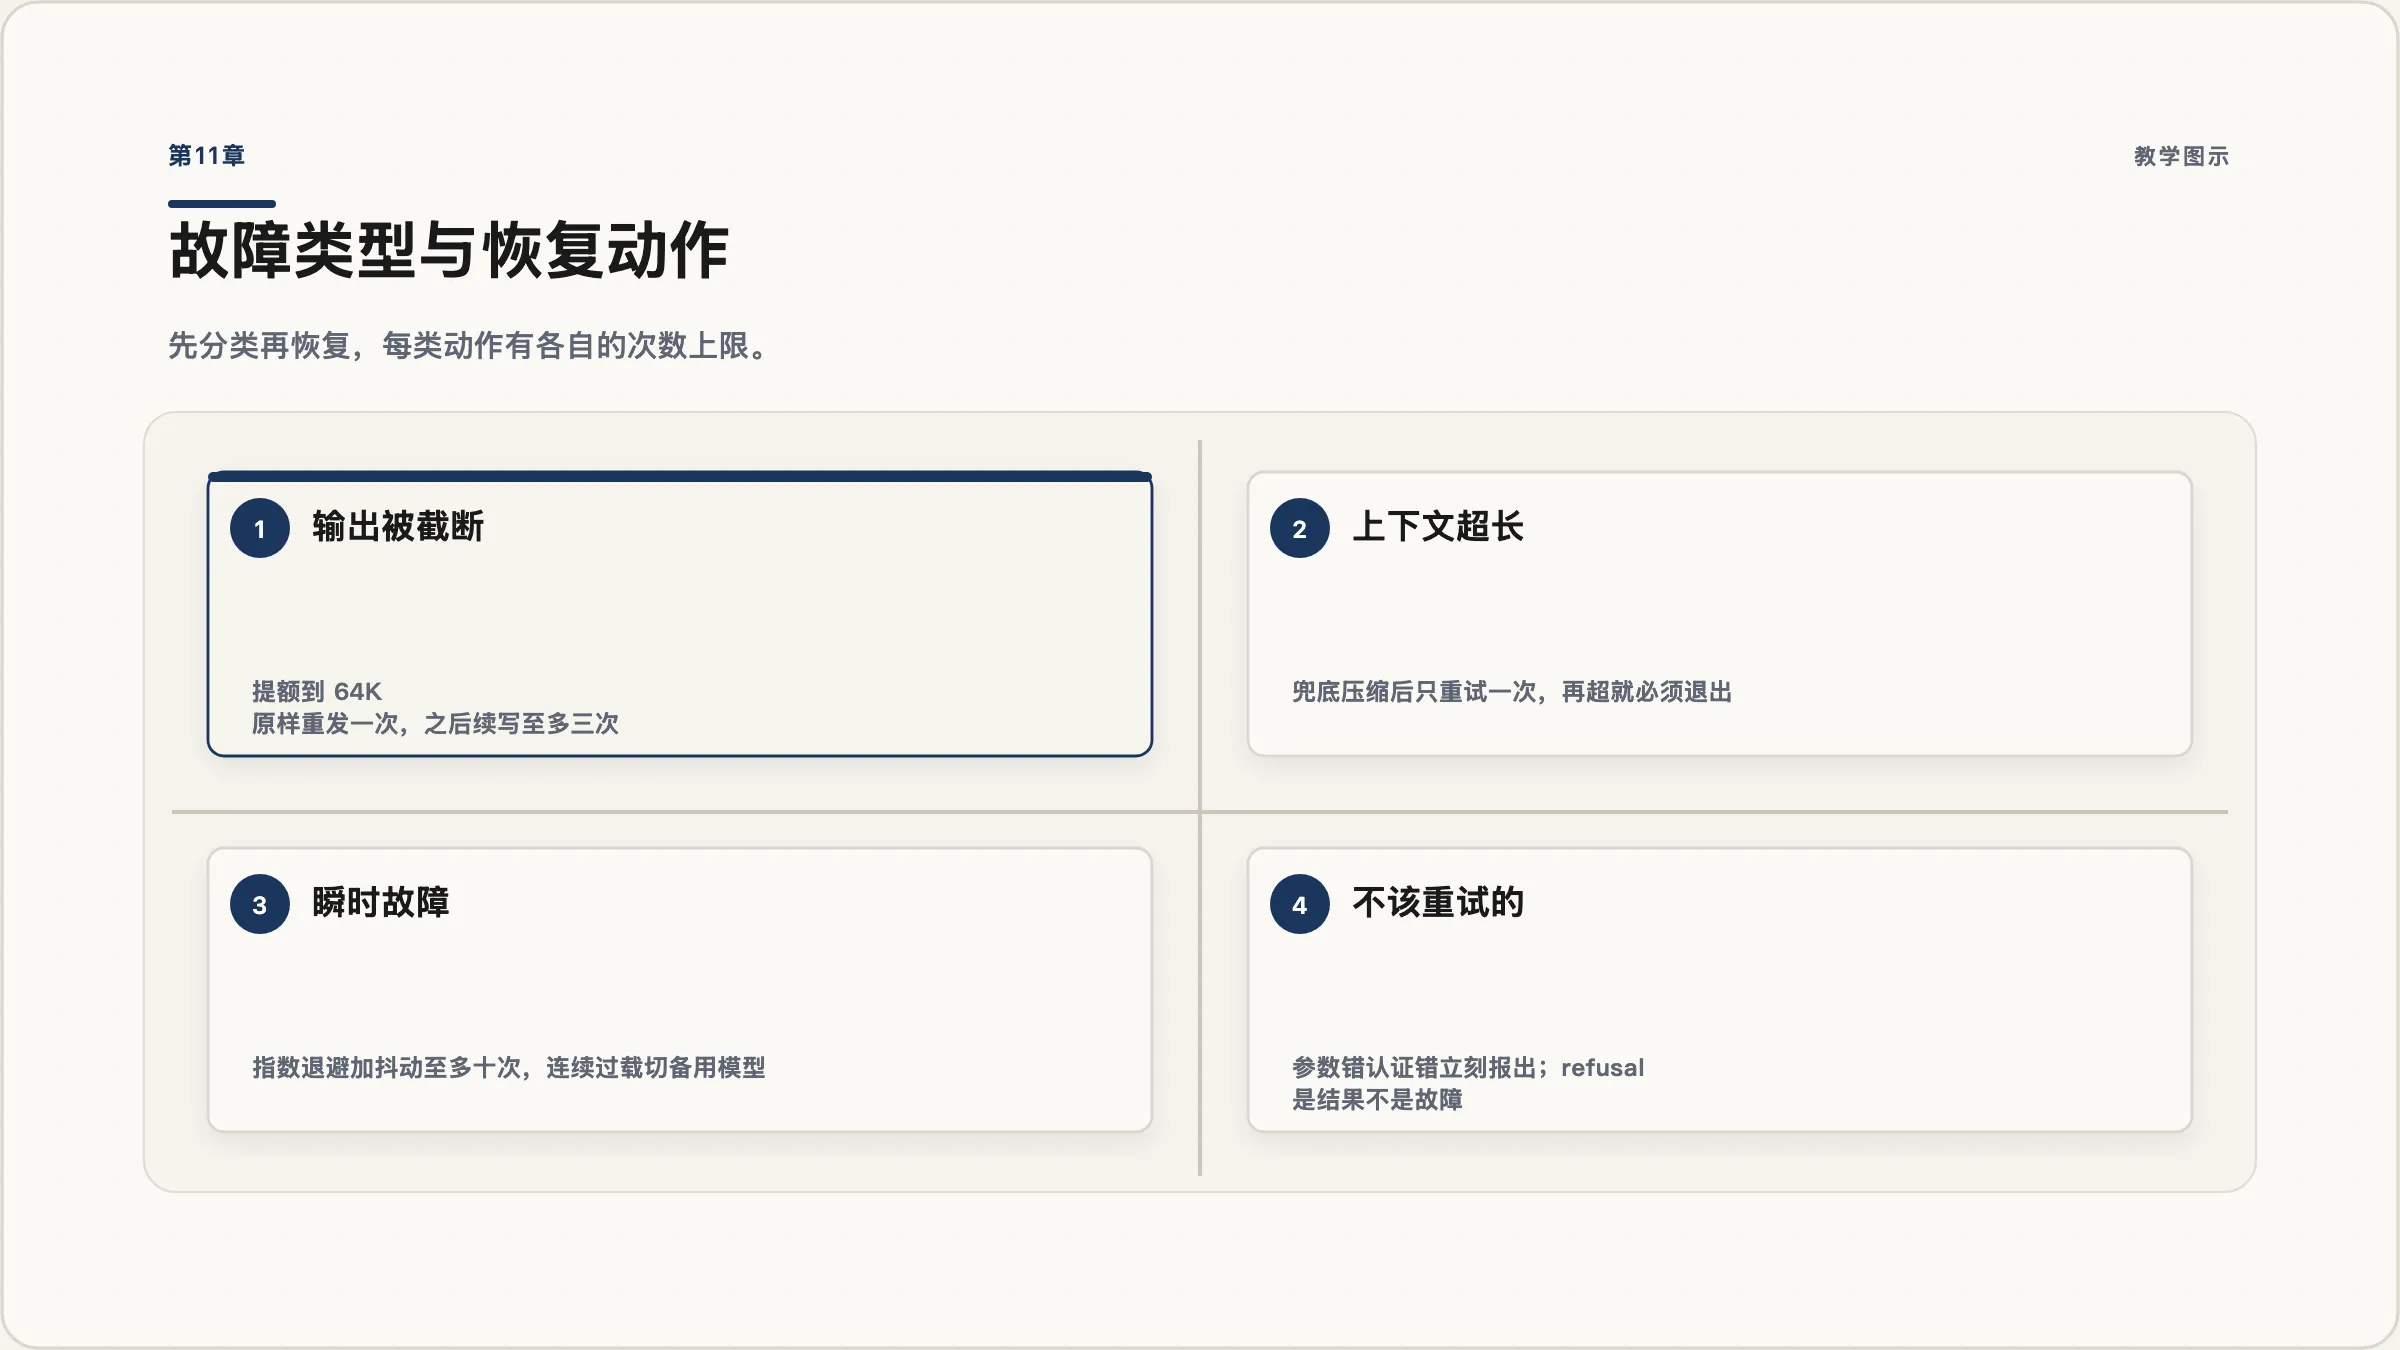
11.1 三类故障,三条路径
| 故障 | 识别方式 | 恢复动作 | 尝试次数 |
|---|---|---|---|
| 输出被截断 | stop_reason == "max_tokens" | 先把 max_tokens 从 8K 提到 64K 重试;如果还截断,把已生成内容追加进去,再发一条”接着写”的续写提示 | 提额 1 次 + 续写至多 3 次 |
| 上下文超长 | 抛出 prompt_too_long | 触发兜底压缩,重试 | 1 次 |
| 瞬时故障 | 429 / 529 | 指数退避 + 抖动后重试;连续 3 次 529 就切到备用模型 | 至多 10 次 |
11.2 代码
先用一个状态对象把”已经试过什么”记下来——这是防死循环的关键:
from dataclasses import dataclass
import random, time

@dataclass
class RecoveryState:
    has_escalated: bool = False              # 是否已提过 max_tokens
    continuations: int = 0                   # 已续写次数
    has_compacted: bool = False              # 是否已做过兜底压缩
    consecutive_529: int = 0
    model: str = MODEL

def backoff_delay(attempt: int) -> float:
    base = min(500 * (2 ** attempt), 32000) / 1000        # 上限 32 秒
    return base + random.uniform(0, base * 0.25)          # 加最多 25% 抖动
那个抖动不是可有可无的装饰。没有抖动时,同时被限流的一百个客户端会在完全相同的时刻一起重试,把服务再打垮一次——这就是”惊群效应”。加一点随机偏移,重试就被摊开了。
主循环里的处理骨架:
def call_model(messages, state: RecoveryState, max_tokens: int = 8000):
    for attempt in range(10):
        try:
            return client.messages.create(
                model=state.model, system=get_system_prompt(ctx),
                messages=messages, tools=TOOLS, max_tokens=max_tokens,
            )
        except anthropic.RateLimitError:                       # 429
            time.sleep(backoff_delay(attempt))
        except anthropic.APIStatusError as e:
            if e.status_code == 529:                           # 过载
                state.consecutive_529 += 1
                if state.consecutive_529 >= 3:
                    state.model = FALLBACK_MODEL               # 切备用模型
                time.sleep(backoff_delay(attempt))
            elif e.status_code >= 500:
                time.sleep(backoff_delay(attempt))
            else:
                raise                                          # 4xx 不重试
    raise RuntimeError("重试次数耗尽")
截断和超长的处理放在循环里:
        if response.stop_reason == "max_tokens":
            if not state.has_escalated:
                state.has_escalated = True
                max_tokens = 64000                 # 消息不动,直接放大重试
                continue
            if state.continuations < 3:
                state.continuations += 1
                messages.append({"role": "assistant", "content": response.content})
                messages.append({"role": "user", "content":
                    "直接从中断处继续,不要道歉,不要复述前面已经写过的内容。"})
continue那句续写提示的措辞是刻意的。如果只写”请继续”,模型往往会先道个歉、再把前面写过的复述一遍,然后才接着写——你花钱买了一段重复内容。明确禁止道歉和复述,能省下可观的 token。
prompt_too_long 的处理:
        except anthropic.BadRequestError as e:
            if "prompt_too_long" in str(e) and not state.has_compacted:
                state.has_compacted = True
                messages[:] = reactive_compact(messages)
                continue
            raise           # 压过一次还超长,说明压不动了,只能退出
11.3 走一遍:一次不太顺的调用
| 时刻 | 发生了什么 | 恢复动作 | 状态变化 |
|---|---|---|---|
| T0 | 调用返回 529 | 等 0.5s 后重试 | consecutive_529 = 1 |
| T1 | 又是 529 | 等 1.1s 后重试 | consecutive_529 = 2 |
| T2 | 还是 529 | 切到备用模型,等 2.3s 重试 | consecutive_529 = 3,model 已切换 |
| T3 | 成功,但 stop_reason == max_tokens | 提额到 64K,消息不变重试 | has_escalated = True |
| T4 | 又截断 | 追加已生成内容 + 续写提示 | continuations = 1 |
| T5 | 正常结束 | — | 任务继续 |
如果没有 RecoveryState,第 T4 步会再次尝试”提额”(因为它不知道自己提过了),而 max_tokens 已经是上限了,于是无限循环。记账不是可选项。
11.4 工程现实
- 哪些错误不该重试:4xx(除了 429)通常是你的请求写错了,重试一百次还是错。参数错误、认证失败、模型名写错——这些要立刻报出来。
- 续写的收益递减:连着续写三次之后,每次新增的内容会越来越少。一个实用的停止信号是”这次续写新增的 token 数低于某个下限(比如 500)“,说明模型已经没什么可写的了。
- 备用模型不是免费的:切换模型会让提示词缓存失效(缓存是按模型隔离的),所以这是应急手段,不是常规策略。
- 别忘了
refusal:模型也可能出于安全原因拒绝。这不是故障,重试通常也没用——应该把它当成一个需要报告给用户的结果。