第 7 章 / 共 21 章
技能装载:目录常驻,正文按需
上一章留下的问题:你希望 Agent 懂点具体的东西——你们团队的 React 组件规范、内部 SQL 查询的注意事项、那套遗留 API 的调用方式。最直接的做法是把这些文档全塞进系统提示词。于是系统提示词变成了六千行,而 Agent 每次调用——哪怕只是问一句”当前目录有哪些文件”——都要为这六千行付 token 费。
更糟的是,塞得越多,真正相关的那部分在模型注意力里的占比越低。
7.1 把”知道有什么”和”知道是什么”分开
关键洞察:“知道有这份文档”和”读完这份文档”是两件不同成本的事。
- 知道有一份《SQL 查询规范》,需要一行描述,大约 100 token;
- 读完它,需要两千 token。
所以做成两级:
| 级别 | 时机 | 内容 | 成本 |
|---|---|---|---|
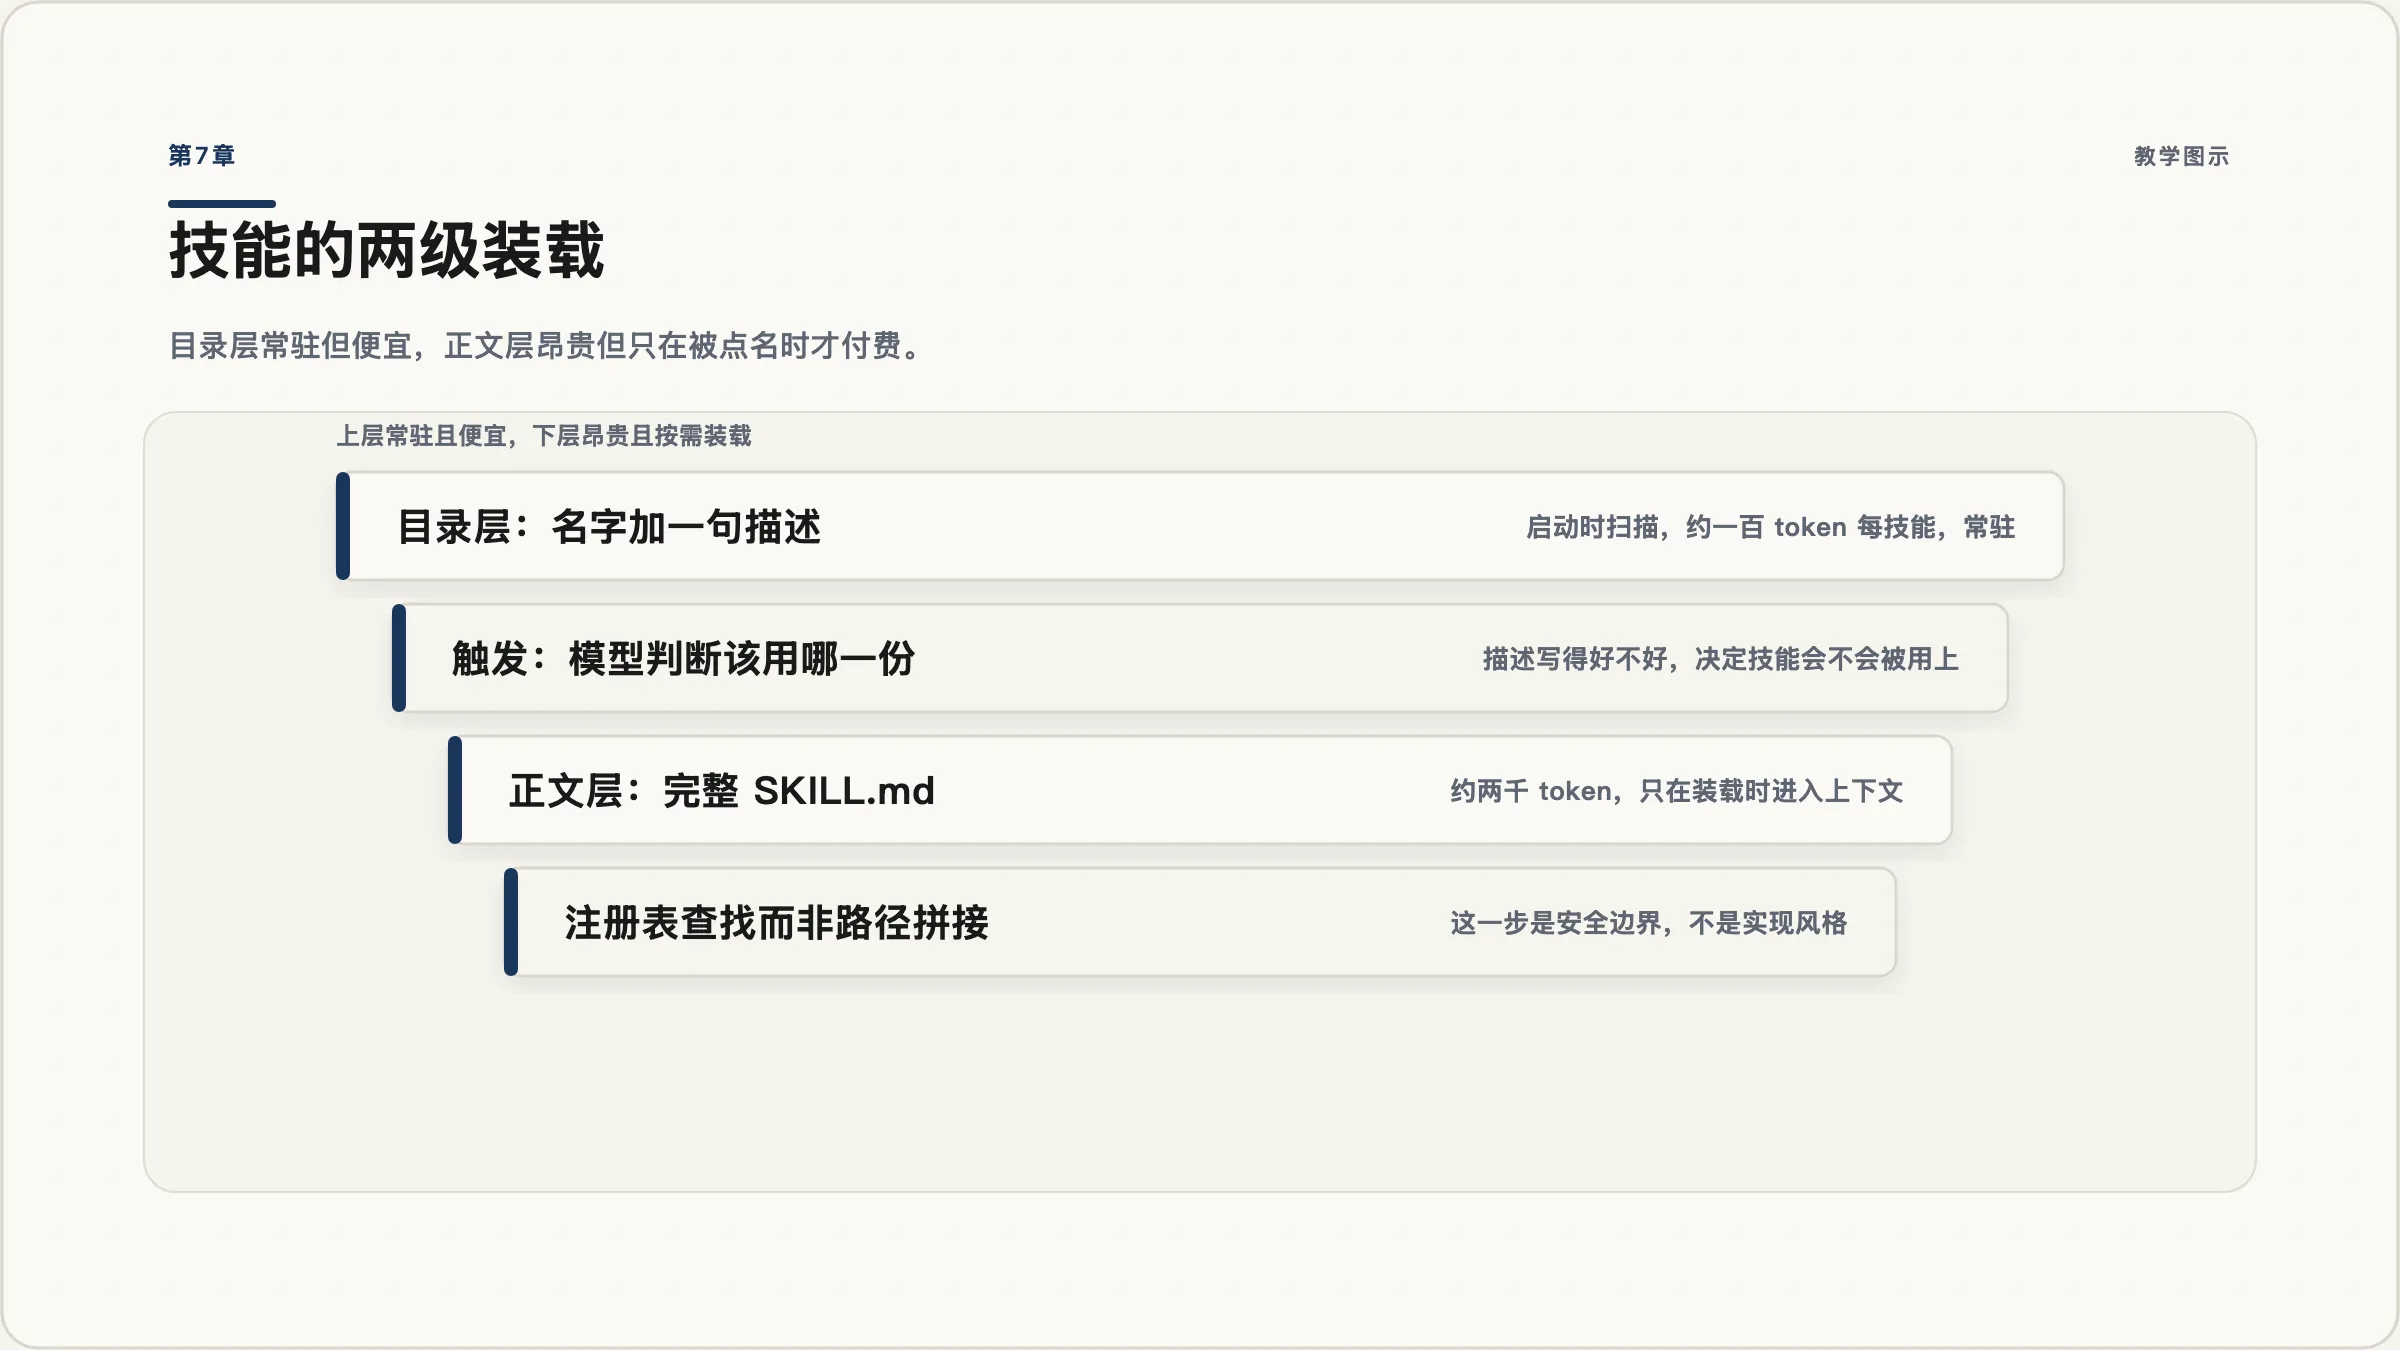
| 一:目录 | 启动时扫描一次,写进系统提示词 | 每个技能的名字 + 一句话描述 | 约 100 token / 技能,常驻 |
| 二:正文 | 模型调用 load_skill(name) 时 | 整份 SKILL.md | 约 2000 token,只在用到时进上下文 |
二十个技能,常驻成本 2000 token;实际用到两个,再加 4000。对比全塞进去的四万 token,差了一个数量级。
7.2 实现
技能就是一个带 YAML frontmatter 的 Markdown 文件:
---
name: sql-review
description: 审查 SQL 查询的性能与安全问题,适用于写或改任何数据库查询之前。
---

# SQL 审查规范

## 必查项
1. WHERE 子句涉及的列是否有索引……
(正文可以很长)
启动时扫描,只把元数据放进提示词:
import re
from pathlib import Path

SKILL_REGISTRY: dict[str, dict] = {}

def load_skills(skills_dir: str = "skills") -> None:
    for path in Path(skills_dir).glob("*/SKILL.md"):
        raw = path.read_text()
        m = re.match(r"^---\n(.*?)\n---\n(.*)$", raw, re.S)
        if not m:
            continue
        front, body = m.group(1), m.group(2)
        name = re.search(r"^name:\s*(.+)$", front, re.M).group(1).strip()
        desc = re.search(r"^description:\s*(.+)$", front, re.M).group(1).strip()
        SKILL_REGISTRY[name] = {"name": name, "description": desc, "content": body}

def skills_catalog() -> str:
    if not SKILL_REGISTRY:
        return ""
    lines = ["可用技能(需要时用 load_skill 装载完整内容):"]
    lines += [f"- {s['name']}:{s['description']}" for s in SKILL_REGISTRY.values()]
    return "\n".join(lines)

def load_skill(name: str) -> str:
    skill = SKILL_REGISTRY.get(name)
    if not skill:
        return f"未找到技能 '{name}'。可用:{', '.join(SKILL_REGISTRY)}"
    return skill["content"]

TOOL_HANDLERS["load_skill"] = load_skill
**注意 load_skill 是按注册表查名字,而不是按路径读文件。**如果写成 Path(skills_dir) / name / "SKILL.md",模型传一个 ../../../etc/passwd 就能读到不该读的东西。注册表查找天然堵死了路径穿越——这是一个很小的实现选择,但它是安全边界。
技能正文是通过 tool_result 进入上下文的,也就是说它躺在对话历史里,而不是系统提示词里。这有个副作用:它会一直占着位置,直到被第8章的压缩机制清理掉。
7.3 走一遍:一次技能装载
假设 skills/ 下有四个技能:sql-review、react-conventions、api-migration、incident-report。
| 轮次 | 发生了什么 | 上下文增量 |
|---|---|---|
| 启动 | 扫描四个技能,目录写进系统提示词 | +约 400 token(常驻) |
| 1 | 用户:“帮我优化这条订单查询的 SQL” | — |
| 2 | 模型从目录里看到 sql-review 相关,调用 load_skill("sql-review") | +约 2000 token |
| 3 | 模型按规范逐条检查,指出缺索引和一处注入风险 | — |
react-conventions、api-migration、incident-report 三份正文自始至终没有进入上下文。它们的存在感只体现在那 300 个 token 的目录里——而恰恰是这 300 个 token,让模型知道自己该去装载哪一份。
7.4 技能描述怎么写
技能能不能被用上,几乎完全取决于那句 description。模型只能看到这一句来决定要不要装载。
| 写法 | 效果 |
|---|---|
❌ SQL 相关知识 | 太模糊,模型不知道什么时候该用 |
❌ 本文档介绍了我们团队在长期实践中总结的关于关系型数据库查询的若干经验 | 说了半天没说触发条件 |
✅ 审查 SQL 查询的性能与安全问题,适用于写或改任何数据库查询之前。 | 说清了”做什么”和”什么时候用” |
一个可靠的模板:「做什么」+「什么时候该用」。把它当成写给一个刚入职、不了解你们项目的同事看的一句话。