第 20 章 / 共 21 章
综合装配:很多机制,一个循环
上一章留下的问题:你现在手里有十九个机制,但它们是十九章分别讲的。真正的问题是:它们同时存在时,一次 turn 到底按什么顺序发生?
先说结论,也是全书最重要的那句话:那段 while True 一个字都没变。
第1章写下的循环——调模型、看 stop_reason、执行工具、把结果回灌——今天仍然是同一段。多出来的十九个机制,全部挂在它的四个位置上:调模型之前、调模型时、执行工具前后、准备退出时。
20.1 一次完整 turn 的时序
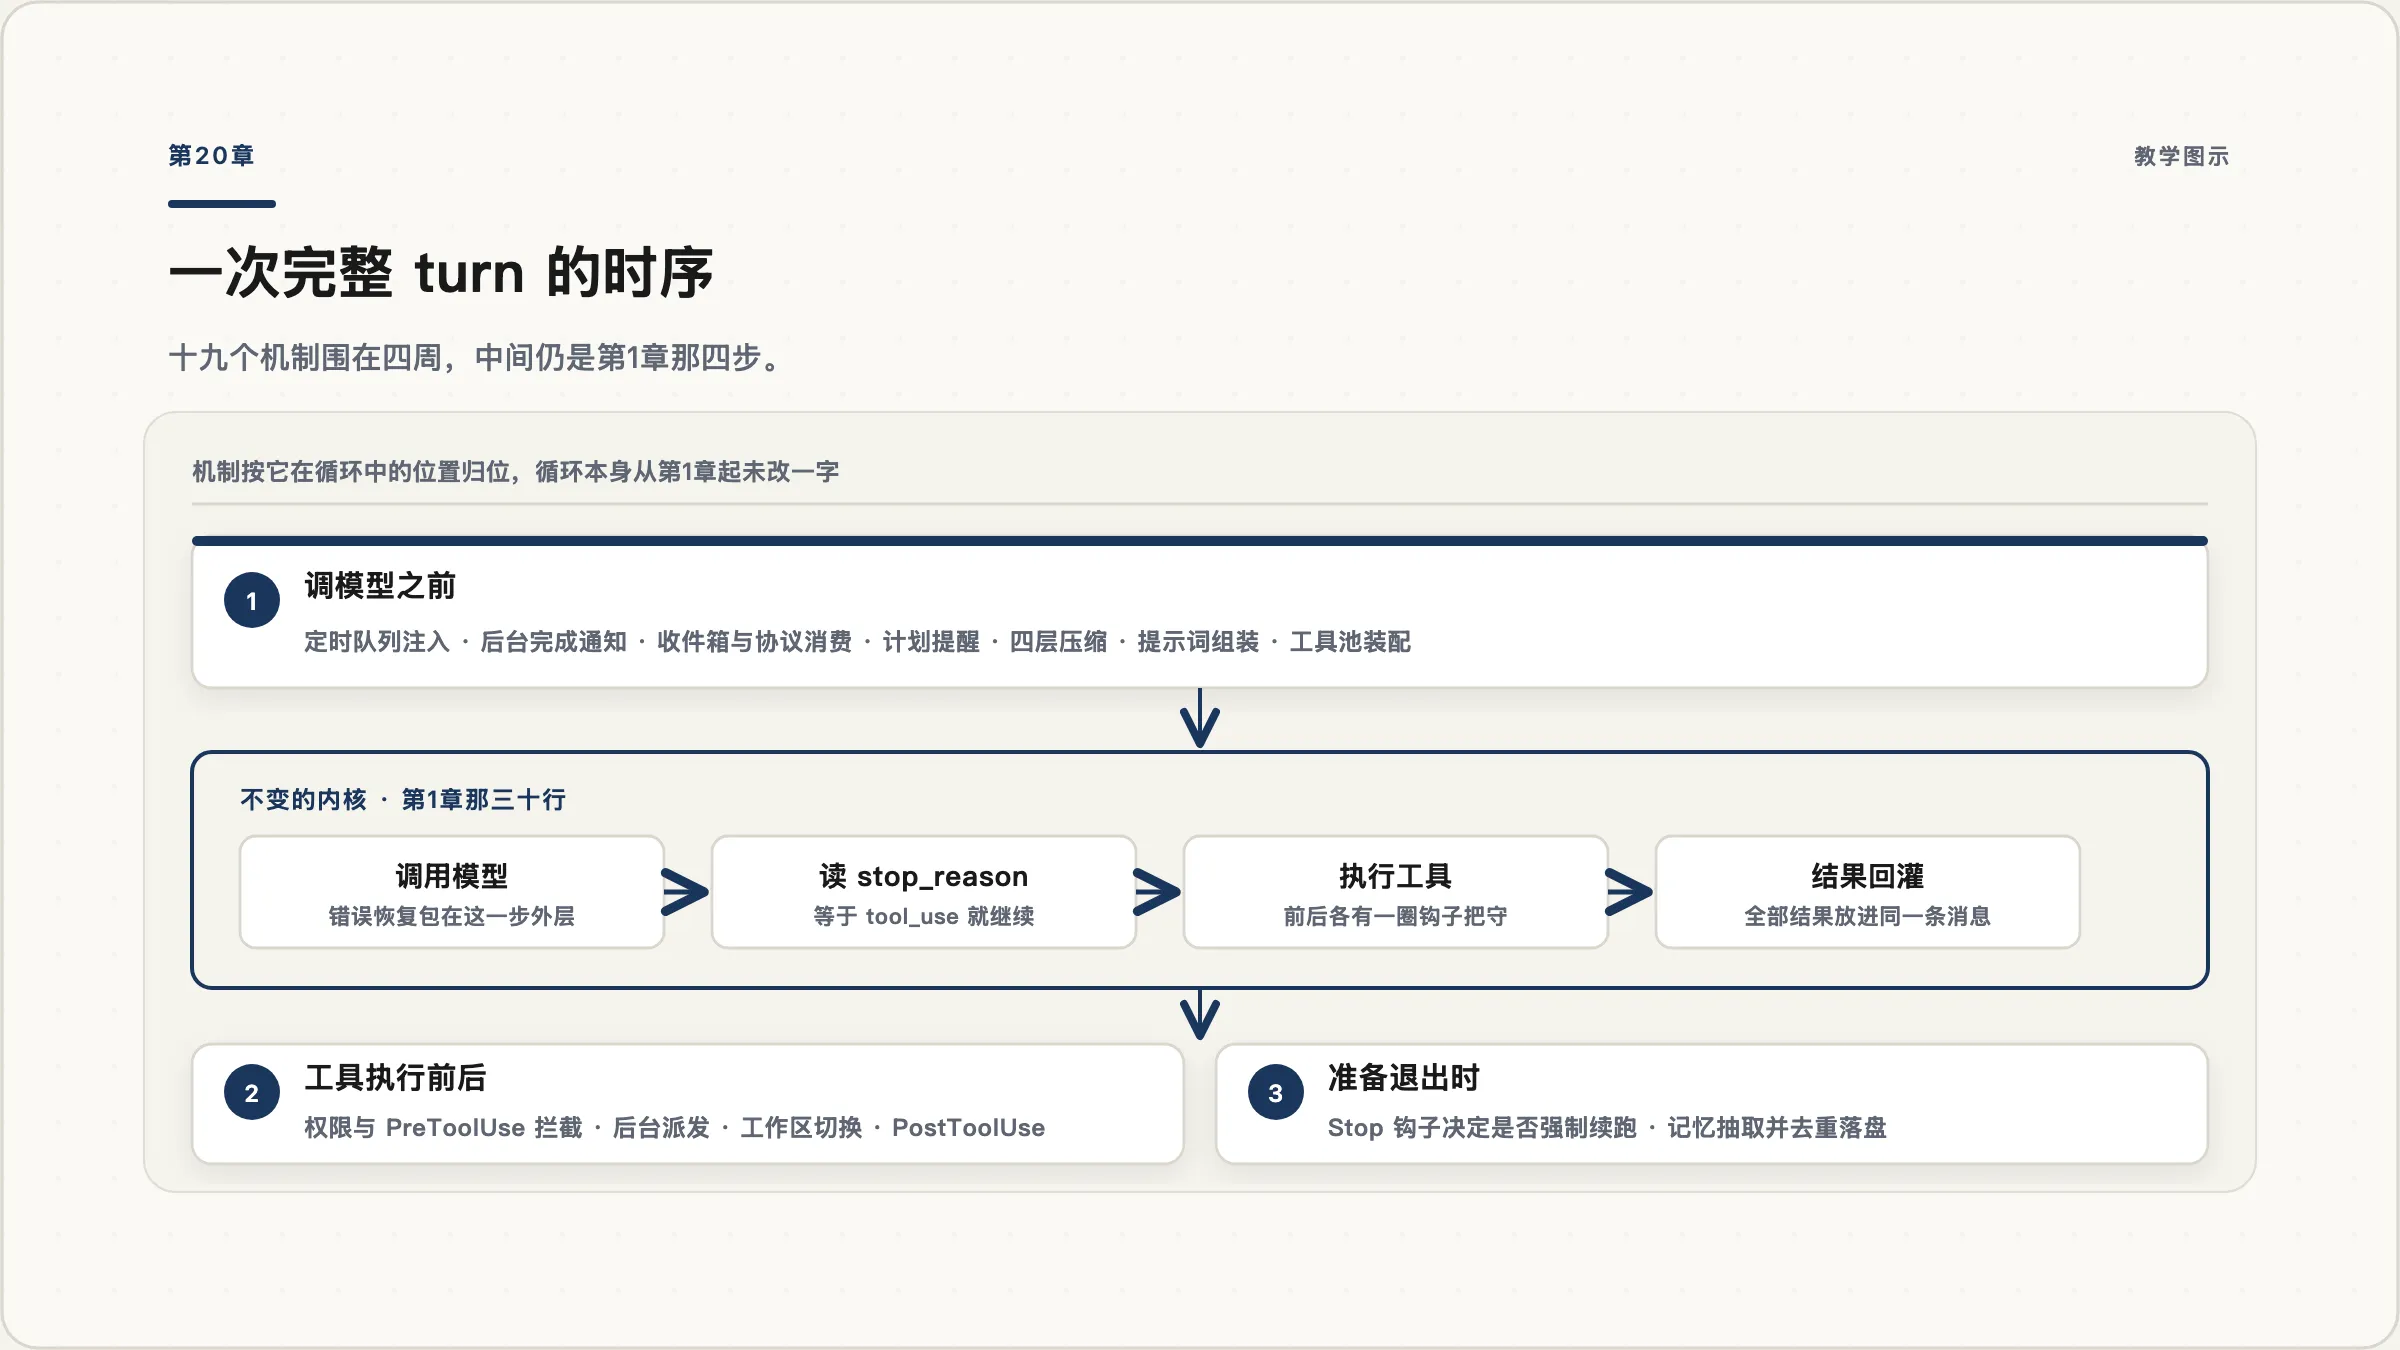
按位置列一遍:
调模型之前
| 机制 | 章 | 做什么 |
|---|---|---|
UserPromptSubmit 钩子 | 4 | 校验输入、注入上下文 |
| 定时队列消费 | 14 | 把到点的任务作为 [定时任务] 消息注入 |
| 后台完成通知 | 13 | 把 <task_notification> 并进消息 |
| 收件箱注入 | 15、16 | 协议消息先被代码消费,其余注入上下文 |
| 计划提醒 | 5 | 连续多轮没更新清单就插一条提醒 |
| 压缩流水线 | 8 | L3 → L1 → L2 →(必要时)L4 |
| 系统提示词组装 | 7、9、10、19 | 按当前状态拼身份、技能目录、记忆索引、已连服务 |
| 工具池装配 | 2、19 | 内建工具 + 已连 MCP 工具 |
调模型时
| 机制 | 章 | 做什么 |
|---|---|---|
| 错误恢复 | 11 | 429/529 退避、max_tokens 提额与续写、超长兜底压缩 |
执行工具时
| 机制 | 章 | 做什么 |
|---|---|---|
PreToolUse 钩子 + 权限 | 3、4 | 危险操作在执行前被挡下 |
| 后台派发 | 13 | 慢命令进守护线程,立刻返回占位结果 |
| worktree 上下文 | 18 | 队友的文件操作落在自己的工作区 |
| 工具调度 | 2 | 按名字查表执行 |
PostToolUse 钩子 | 4 | 日志、超大输出预警、副作用 |
准备退出时
| 机制 | 章 | 做什么 |
|---|---|---|
Stop 钩子 | 4 | 清理、统计,或者强制续跑 |
| 记忆抽取 | 9 | 一轮自然结束时提取新事实并去重写入 |
20.2 骨架代码
把上面这张表翻译成代码,就是这样:
def agent_turn(messages: list, state: RecoveryState) -> None:
    while True:
        # ── 调模型之前 ────────────────────────────────
        for job in consume_cron_queue():                       # 第14章
            messages.append({"role": "user", "content": f"[定时任务] {job.prompt}"})
        for note in collect_background_results():              # 第13章
            messages.append({"role": "user", "content": note})
        for msg in consume_inbox("lead"):                      # 第15、16章
            messages.append({"role": "user", "content": f"<inbox>{msg}</inbox>"})

        messages[:] = tool_result_budget(messages)             # 第8章 L3
        messages[:] = snip_compact(messages)                   # L1
        messages[:] = micro_compact(messages)                  # L2
        if estimate_token_count(messages) > THRESHOLD:
            messages[:] = compact_history(messages)            # L4

        ctx = current_context()                                # 第10章
        tools, handlers = assemble_tool_pool()                 # 第2、19章

        # ── 调模型 ────────────────────────────────────
        response = call_model(messages, state, tools=tools,    # 第11章
                              system=get_system_prompt(ctx))
        messages.append({"role": "assistant", "content": response.content})

        # ── 判断是否继续 ──────────────────────────────
        if response.stop_reason != "tool_use":
            force = trigger_hooks("Stop", messages)            # 第4章
            if force:
                messages.append({"role": "user", "content": force})
                continue
            extract_memories(messages)                         # 第9章
            return

        # ── 执行工具 ──────────────────────────────────
        results = []
        for block in response.content:
            if block.type != "tool_use":
                continue
            blocked = trigger_hooks("PreToolUse", block)       # 第3、4章
            if blocked:
                results.append({"type": "tool_result", "tool_use_id": block.id,
                                "content": str(blocked)})
                continue
            if should_run_background(block.name, block.input): # 第13章
                bg_id = start_background_task(block)
                results.append({"type": "tool_result", "tool_use_id": block.id,
                                "content": f"已在后台启动({bg_id}),可以继续做别的事。"})
                continue
            output = handlers[block.name](**block.input)       # 第2章
            trigger_hooks("PostToolUse", block, output)        # 第4章
            results.append({"type": "tool_result", "tool_use_id": block.id, "content": output})

messages.append({"role": "user", "content": results}) # 第1章:回灌把所有带注释的行遮住,剩下的就是第1章那三十行。这就是本书的全部结构性主张。
20.3 装配时才会暴露的三个问题
单看每一章都很清楚,装到一起会冒出一些只在集成时才出现的问题:
顺序敏感。 压缩必须在组装提示词之前(否则你按压缩前的状态算了 token),工具池必须在调模型之前重建(否则模型看不到新连的 MCP 工具),协议消息必须在注入上下文之前被消费(否则状态机停在 pending)。这些顺序不是风格,是正确性。
机制之间会互相削弱。 压缩会抹掉队友的身份(第17章),也会抹掉当前的任务清单(第5章);压缩之后需要主动把这两样重新贴回去。同样,切换备用模型(第11章)会让提示词缓存(第10章)全部失效。集成的工作量,很大一部分花在处理这类交叉影响上。
成本会叠加。 记忆的相关性侧查询、L4 摘要、子代理、队友——每一个都是额外的模型调用。全开的时候,一次”用户提问”背后可能有五六次模型调用。这些开销要能被观测、能被单独关掉。
20.4 不要一次装满
到这里你已经有能力实现所有二十个机制。但**“能装”不等于”该装”。**
一个实用的引入顺序,按痛点触发:
| 什么时候加 | 加什么 |
|---|---|
| 一开始 | 循环 + 工具调度(第1、2章) |
| 第一次看到模型跑出危险命令 | 权限 + 钩子(第3、4章) |
| 第一次看到长任务跑偏 | 计划清单(第5章) |
| 第一次撞到上下文超限 | 压缩(第8章);子代理和技能(第6、7章)通常同期出现 |
| 第一次因为报错整个任务白跑 | 错误恢复(第11章) |
| 第一次希望”关掉终端明天接着干” | 记忆 + 任务系统(第9、12章) |
| 第一次因为等命令浪费大量时间 | 后台任务(第13章) |
| 第一次希望它自己按时跑 | 定时(第14章) |
| 第一次一个 Agent 真的扛不动 | 团队 + 协议 + 自治 + 隔离(第15–18章) |
| 第一次需要接外部系统 | MCP(第19章) |
每一个机制都应该由一次真实的疼痛触发,而不是因为教程里有这一章。提前加上的机制会带来复杂度、成本和 bug,却没有对应的收益。这也和”从最简单的层级开始,只在明确需要时才增加复杂度”这个通行建议一致。