第 7 章 / 共 12 章
让 server 拥有状态:生命周期、密钥与并发
7.1 每次调用都重连一次数据库,会发生什么
到这里,你的工具都是无状态的:调用进来,读文件,返回。真实的 server 很少这么单纯——它要连数据库、要维护一个索引、要拿 API 密钥、要复用 HTTP 连接池。
如果不管,你会很自然地写成这样:
@mcp.tool()
def search_notes(keyword: str) -> str:
    """搜索笔记。"""
    index = build_index(NOTES_DIR)   # 每次调用都重建一次索引
    return index.search(keyword)
问题在模型的行为模式上:模型不像人,它常常连着调三五次工具来收敛一个答案。每次重建索引,就是把这笔开销乘以五。数据库连接更糟——连接建立本身有延迟,宿主那边体现出来就是「这个工具好慢」,慢到一定程度会触发超时。
正确的位置是生命周期:进程启动时准备一次,所有调用共享,进程退出时清理。
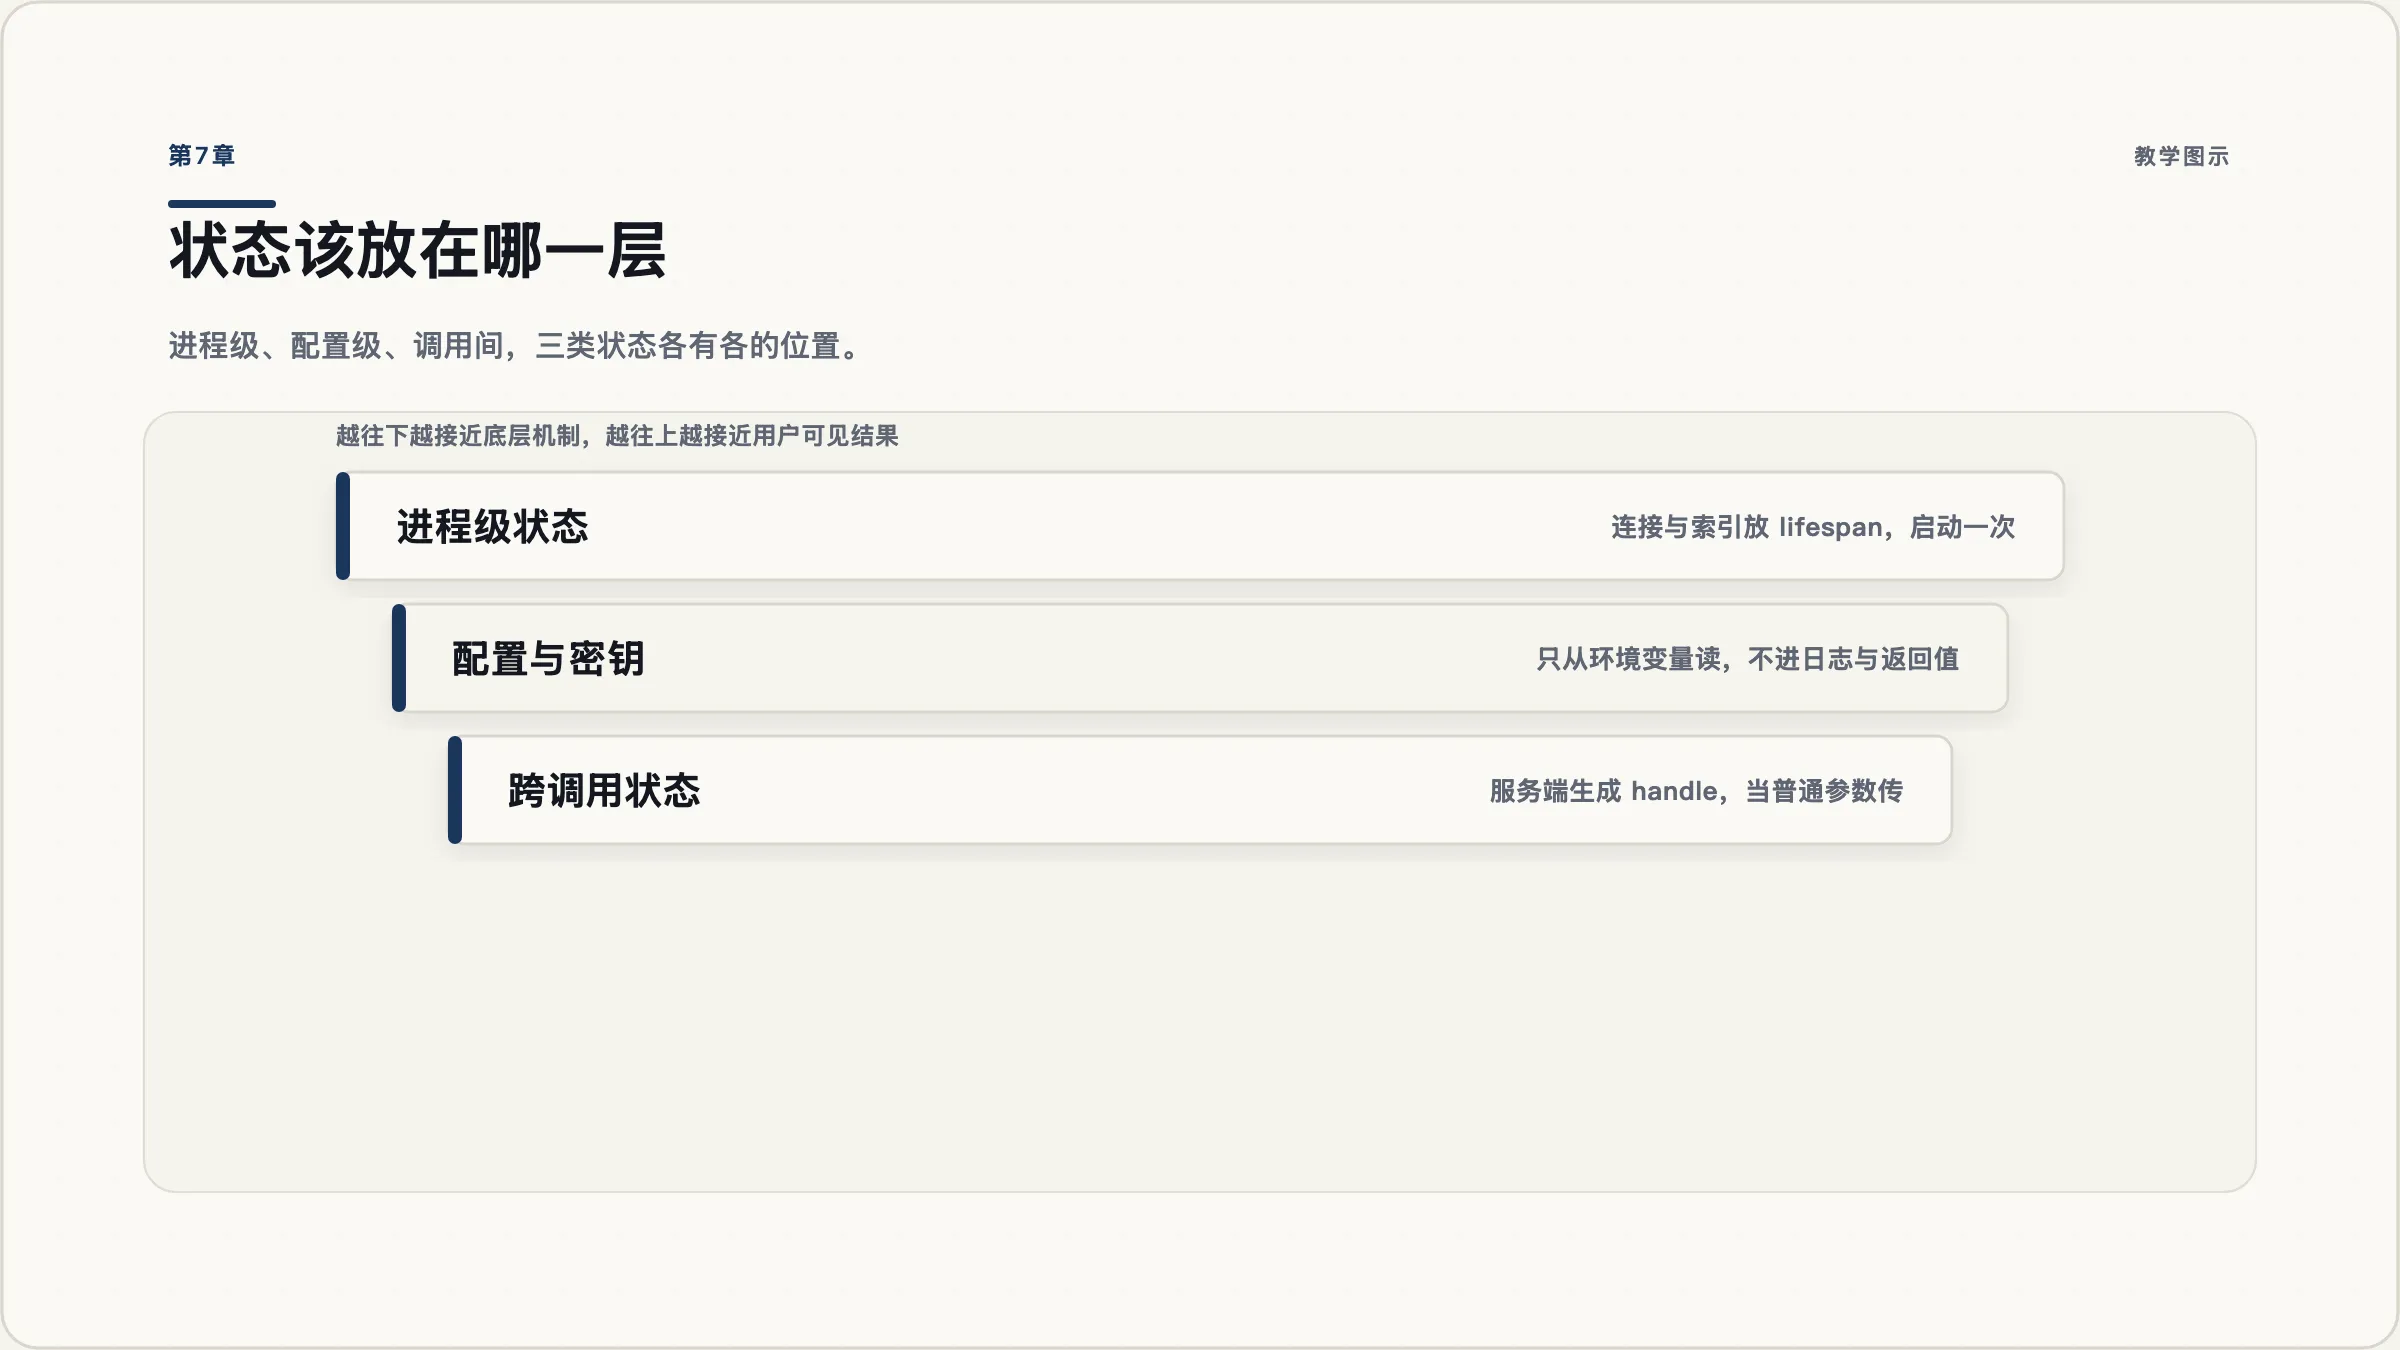
7.2 lifespan:启动准备一次,退出清理一次
SDK 用一个异步上下文管理器表达这件事,yield 之前是启动,之后是关闭:
import logging
import os
from collections.abc import AsyncIterator
from contextlib import asynccontextmanager
from dataclasses import dataclass
from pathlib import Path

from mcp.server import MCPServer
from mcp.server.mcpserver import Context

logging.basicConfig(level=logging.INFO)
log = logging.getLogger("notes")

@dataclass
class AppContext:
    notes_dir: Path
    index: dict[str, str]

@asynccontextmanager
async def app_lifespan(server: MCPServer) -> AsyncIterator[AppContext]:
    notes_dir = Path(os.environ.get("NOTES_DIR", "notes")).expanduser().resolve()
    log.info("building index from %s", notes_dir)
    index = {p.name: p.read_text(encoding="utf-8") for p in notes_dir.glob("*.md")}
    try:
        yield AppContext(notes_dir=notes_dir, index=index)
    finally:
        log.info("shutting down, dropping index of %d notes", len(index))

mcp = MCPServer("notes", version="0.2.0", lifespan=app_lifespan)
工具通过上下文对象取回它:
@mcp.tool()
async def count_notes(ctx: Context[AppContext]) -> str:
    """统计笔记库里有多少篇笔记。"""
    app = ctx.request_context.lifespan_context
    return f"{len(app.index)} 篇笔记,目录 {app.notes_dir}"
三个要注意的点:
- 上下文靠类型注解注入,不靠参数名。 参数叫
ctx还是context还是c都行,关键是标注了Context类型。(旧版本的get_context()函数已经没有了。) - 写成
Context[AppContext]能拿到类型提示,lifespan_context会被正确推断成AppContext。 - 清理逻辑放在
finally里,否则异常退出时连接不会被关。
这段代码实际跑起来的日志(stderr)是:
INFO:notes:building index from /path/to/notes
INFO:notes:shutting down, dropping index of 2 notes
启动一次,退出一次,中间的所有调用共享同一份索引。
7.3 密钥从哪里来:你的 shell 环境不在那里
这是接入阶段最常见的一个「本地好好的,装到宿主里就不行」。
原因是:server 是被宿主作为子进程启动的,它继承的是宿主的环境,不是你终端的环境。 你在 .zshrc 里 export 的 NOTES_API_KEY,在 Claude Desktop 启动的子进程里根本不存在。
所以密钥要通过宿主配置显式传进去。各客户端的写法第 9 章会讲,共同点是配置里有一个 env 字段。开发期也可以用 SDK 的安装命令把变量写进配置:
uv run mcp install server.py -v NOTES_DIR=/abs/path/notes -f .env三条纪律:
- 代码里只从环境变量读,不要硬编码,也不要读用户主目录下某个约定文件。
- 给一个安全的默认值,让没配置的人也能跑起来(比如
NOTES_DIR默认取当前目录下的notes)。 - 密钥绝不能出现在工具的返回值里。 返回值会进模型上下文,可能被记录、被转发、被展示。错误信息也一样——第 6.4 节讲的异常遮蔽机制,正是为了防这件事。
7.4 同步函数会跑在工作线程上:三个副作用
这是 SDK 2.x 的一个行为变化,写有状态 server 时特别容易踩。
旧版本里,同步的 def handler 直接在事件循环上执行,一旦阻塞就卡死整个 server。新版本改了:同步 handler 会被丢到工作线程里执行。这解决了阻塞问题,但带来三个新的副作用:
- 同步 handler 里调用
asyncio.get_running_loop()会抛RuntimeError——那个线程上没有事件循环。 - 线程亲和的状态会出问题:thread-local 变量、非线程安全的对象(很多数据库驱动的连接对象就是),现在会被不同的工作线程碰到。
- 同步 handler 之间会并发执行。你不能再假设它们是串行的,共享的可变状态需要自己加锁。
判断规则很简单:要用事件循环上的东西(异步客户端、共享的异步连接池),就把函数写成 async def;纯 CPU 或纯阻塞 IO 的短任务,写成 def 让它去工作线程,反而更好。
7.5 跨调用的状态:用 handle,不要用会话
最后一类状态:一次调用产生的东西,下一次调用要用。比如「开始一次批量整理,先返回预览,用户确认后再执行」。
在旧的有状态协议里,你可能会想把它挂在会话上。现在不行了——2026-07-28 移除了协议级会话,服务器不该假设两个请求属于同一个会话。规范给出的替代方案很明确:需要跨调用状态的服务器,使用由服务器自己生成的显式 handle,作为普通的工具参数传递。
落到代码上就是这个形状:
@mcp.tool()
def plan_cleanup(pattern: str, ctx: Context[AppContext]) -> CleanupPlan:
    """预览一次批量整理会改动哪些笔记,返回一个计划 id。不会真的修改文件。"""
    plan_id = secrets.token_urlsafe(16)
    ctx.request_context.lifespan_context.plans[plan_id] = compute_changes(pattern)
    return CleanupPlan(plan_id=plan_id, will_change=[...])

@mcp.tool()
def apply_cleanup(plan_id: str, ctx: Context[AppContext]) -> str:
    """执行之前用 plan_cleanup 生成的整理计划。"""
    plan = ctx.request_context.lifespan_context.plans.pop(plan_id, None)
    if plan is None:
        raise ToolError("这个计划 id 不存在或已过期,请先调用 plan_cleanup 重新生成。")
    ...
plan_id 是普通的工具参数,模型能看见、能传递,服务器端把它当查表的键。这个模式还有一个附带好处:它天然形成了「先预览、再执行」的两步确认,对有副作用的工具来说,这本身就是一道安全设计。
有一条纪律要写进第 11 章的清单:handle 不是身份凭据。 规范对此有硬性要求——绝不能把「持有某个状态 handle」当作认证通过。它只能用来定位数据,不能用来判断「这个人有权做这件事」。