第 4 章 / 共 12 章
工具、资源、提示词:谁来决定调用
4.1 同一个需求,三种做法,代价完全不同
现在给笔记库加第二个能力:读取某一篇笔记的全文。
这件事至少有三种做法,而且三种都合法:
- 做成工具
read_note(filename),模型想读的时候自己调。 - 做成资源
notes://reading.md,宿主应用把它列出来,由应用或用户决定要不要放进上下文。 - 做成提示词
/review-note,用户在输入框里显式触发,展开成一段带笔记内容的提示。
选错不会报错,但会让你的 server 用起来别扭——模型该调的时候不调,或者上下文被塞满了用不上的东西。
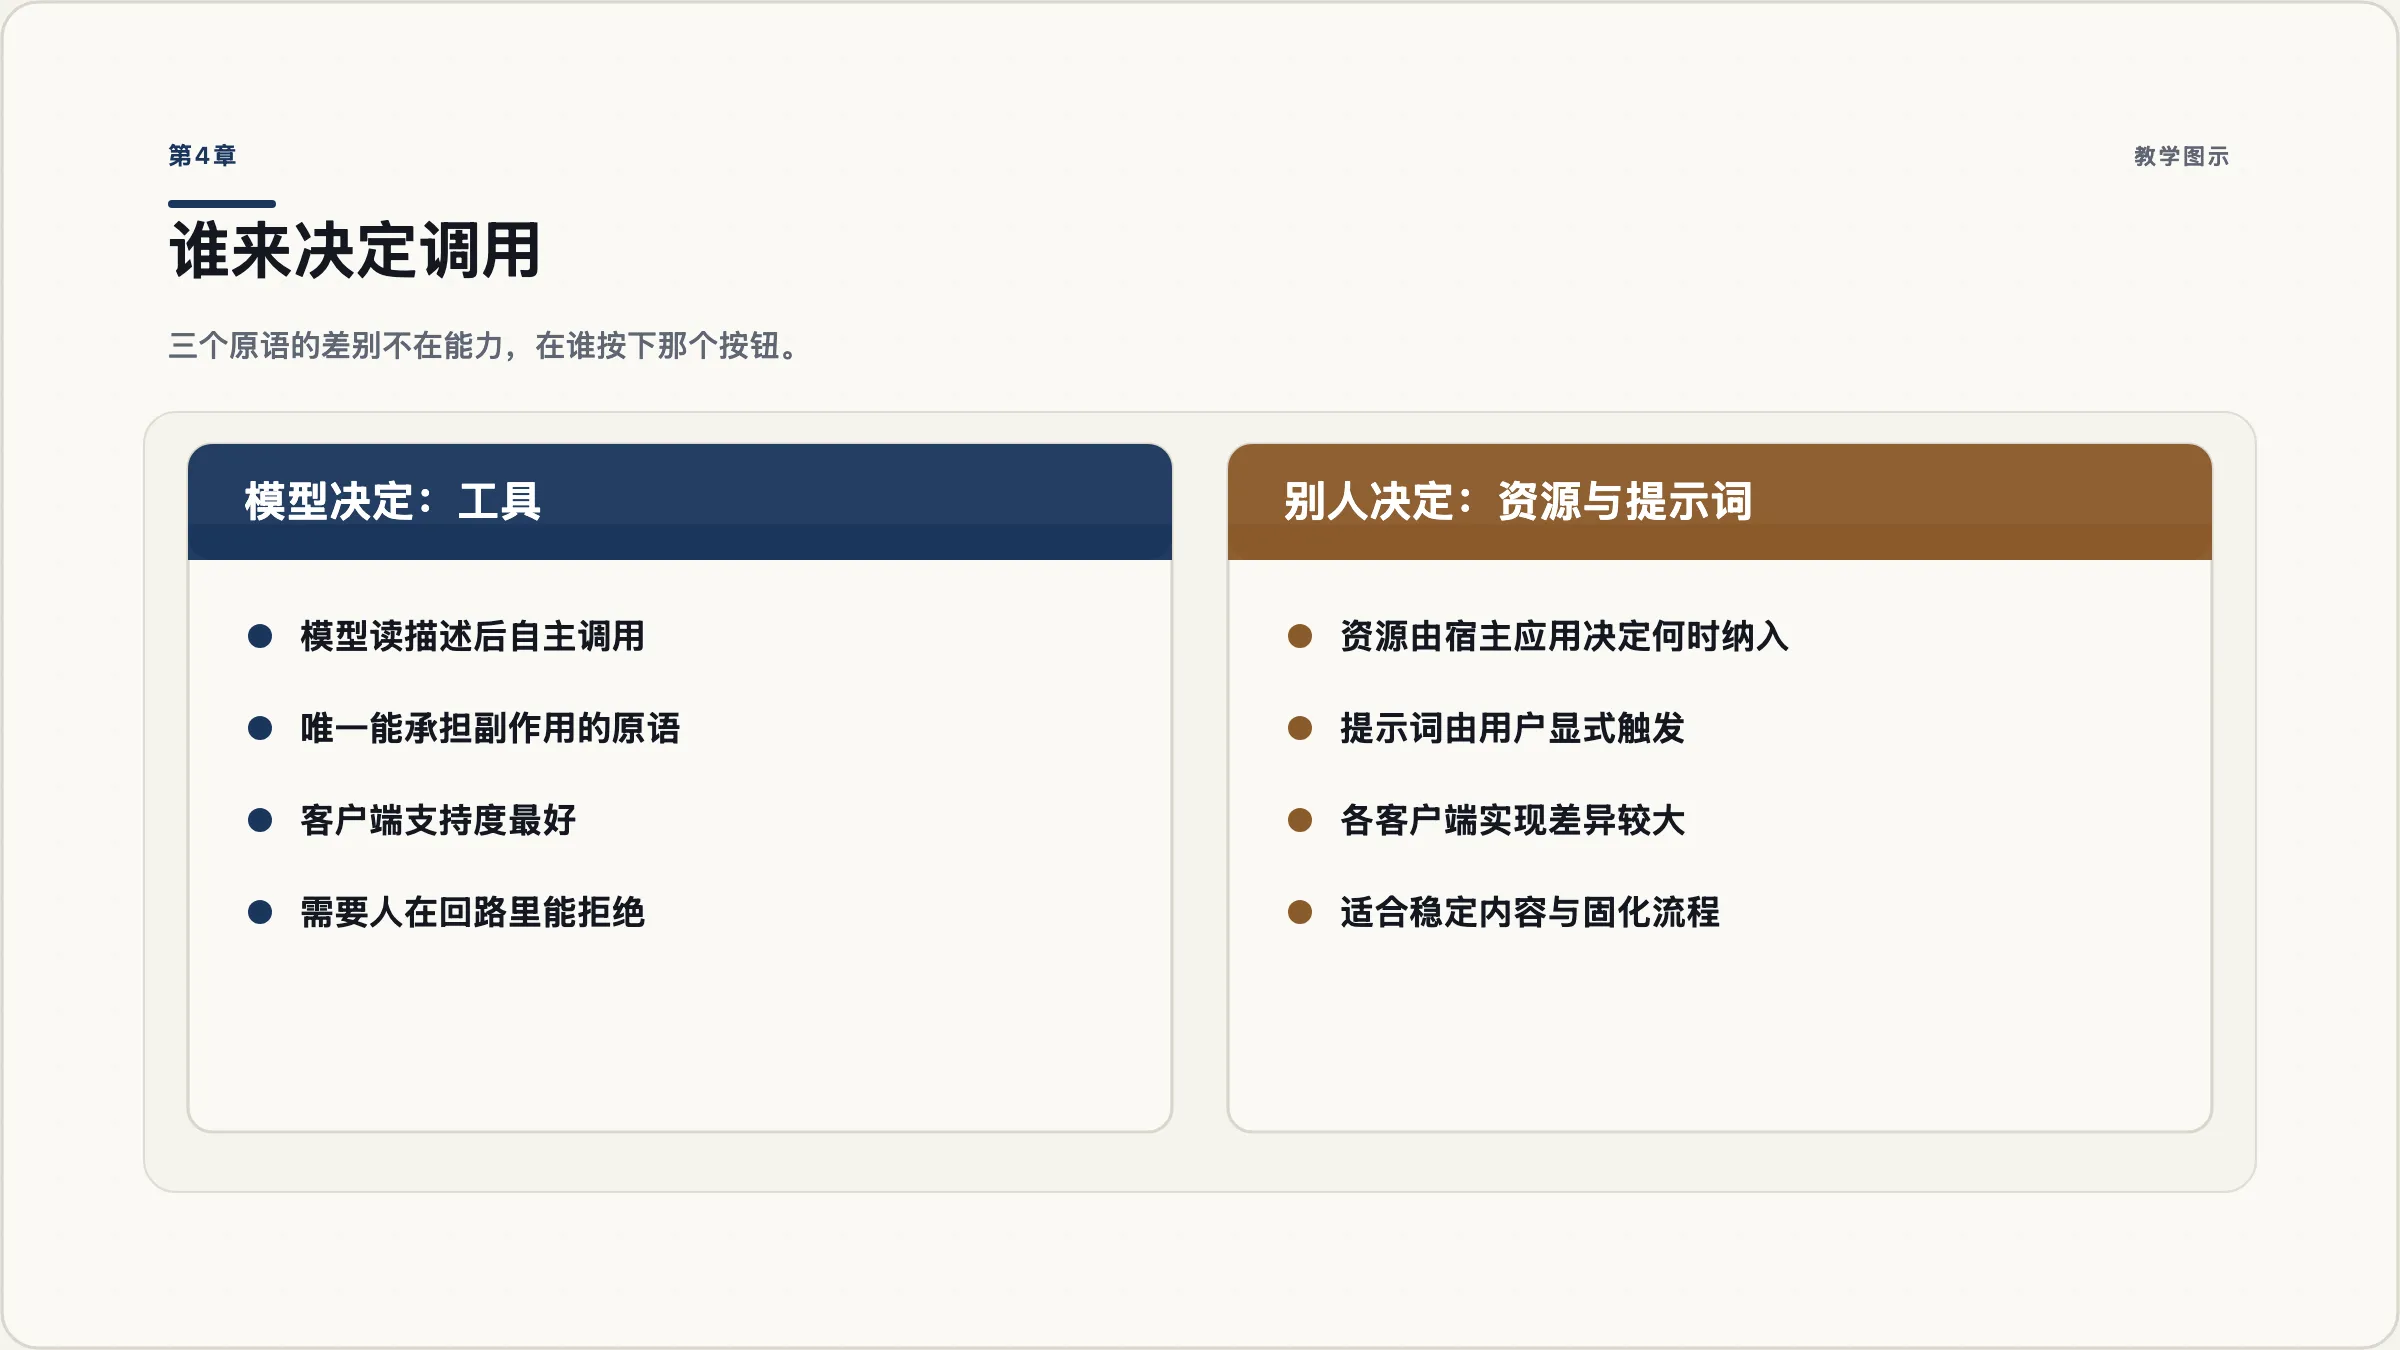
三者的区别只有一条,而且规范写得非常清楚:谁来决定它被使用。
| 原语 | 规范用词 | 谁决定 | 典型触发场景 |
|---|---|---|---|
| Tools | model-controlled | 模型 | 模型根据对话内容自主判断要不要调 |
| Resources | application-driven | 宿主应用 | 应用把它列在侧栏、做成 @ 引用、或按策略自动附带 |
| Prompts | user-controlled | 用户 | 用户显式选择,常见形态是斜杠命令 |
4.2 工具:模型自己决定要不要用
工具是模型控制的。规范原文说,模型可以基于它对上下文的理解和用户的提问,自动发现并调用工具。
这也是为什么工具比另外两个更需要小心。它有副作用的能力,而且触发时机不由人决定。规范因此配了一条硬性的安全建议:出于信任与安全考虑,应该始终有一个人在回路里,有能力拒绝工具调用。
工具的名字有规则(2025-11-25 版本开始明确):长度建议在 1 到 128 个字符之间,区分大小写,只用大小写字母、数字、下划线、连字符和点。get_user、DATA_EXPORT_v2、admin.tools.list 都是合法的。
什么该做成工具:需要执行动作、需要参数、结果依赖调用时刻的事情。搜索、查询、写入、调用外部 API,都是工具。
4.3 资源:把数据摆出来,让宿主决定怎么用
资源是应用驱动的。规范特意用了 “application-driven” 这个词——宿主应用根据自己的需要决定怎么把资源纳入上下文。文档举的例子包括:在界面上做成树形或列表让用户显式选择、让用户搜索和筛选资源、或者按启发式规则自动附带。
也就是说,你没法控制资源会不会被读,这取决于宿主怎么实现。有的客户端把资源做得很显眼,有的客户端干脆不支持资源。这是选原语时的现实考量。
资源用 URI 标识。SDK 里写成这样:
@mcp.resource("notes://index")
def notes_index() -> str:
    """笔记库的目录,列出所有笔记的文件名与首行标题。"""
    lines = []
    for path in sorted(NOTES_DIR.glob("*.md")):
        first = path.read_text(encoding="utf-8").splitlines()[0]
        lines.append(f"{path.name}\t{first.lstrip('# ').strip()}")
    return "\n".join(lines)
URI 里带 {} 变量的话,它就变成一个资源模板,按 RFC 6570 解析:
@mcp.resource("notes://{filename}")
def read_note(filename: str) -> str:
    """按文件名读取一篇笔记的全文。"""
    return (NOTES_DIR / filename).read_text(encoding="utf-8")
有三条规则会在你写错时立刻报错,值得先知道:
- URI 模板里的变量集合,必须和函数参数集合完全相等,多一个少一个都会在装饰阶段抛
ValueError。 - 静态 URI 对应的函数不能有参数,也不能注入上下文对象。
- 返回
str是文本,返回bytes是二进制,返回别的会被转成 JSON。
什么该做成资源:相对稳定、可以被整份读取、用户或应用能提前判断要不要看的东西。文档、配置、目录清单、数据库 schema。
4.4 提示词:把一段专业流程包装成一条命令
提示词是用户控制的。规范说它们被暴露出来,就是为了让用户能显式选择使用,典型形态是斜杠命令。
@mcp.prompt()
def review_note(filename: str) -> str:
    """把一篇笔记整理成要点清单。"""
    body = (NOTES_DIR / filename).read_text(encoding="utf-8")
    return f"请把下面这篇笔记整理成不超过五条的要点清单,保留笔记里出现的日期与人名:\n\n{body}"
它返回的可以是字符串、消息列表、图片、音频等。消息里的角色只能是 user 或 assistant。
什么该做成提示词:你希望人来发起、并且提示词本身有专业价值的流程。「按我们团队的规范审查这段代码」「把这份会议记录整理成待办」——这类知识写在提示词里,比指望用户每次自己描述要可靠得多。
4.5 笔记库的能力清单
把上面三节应用到我们的例子上,就得到了这份清单。这张表就是接下来八章要实现的东西:
| 能力 | 原语 | 为什么是它 | 副作用 |
|---|---|---|---|
搜索笔记 search_notes | 工具 | 需要参数、结果随时在变、模型该自主判断何时搜 | 无(只读) |
读取笔记 read_note | 工具 | 模型搜到之后往往要接着读,交给模型自己接力最顺 | 无(只读) |
笔记目录 notes://index | 资源 | 相对稳定、适合整份呈现、用户可能想手动挑一篇 | 无(只读) |
追加笔记 append_note | 工具 | 有写入动作,必须是工具 | 有(会改文件) |
整理成要点 review_note | 提示词 | 由人发起,价值在那段提示词本身 | 无 |
有一个判断技巧可以帮你快速定位:先问这件事有没有副作用。有副作用(写、删、发送、扣款)就只能是工具,没得选。没有副作用,再问「谁最适合决定这件事该不该做」,答案就是原语。
还有一个现实提醒:工具的客户端支持度最好,资源和提示词各家实现差别较大。如果你的 server 要给多种客户端用,核心能力放在工具里最稳妥,资源和提示词当增强。