第 1 章 / 共 12 章
先决定:这件事值不值得写成 MCP Server
1.1 三种旧做法,和它们各自卡在哪
假设你有一个真实需求:让 AI 助手能查你本地的笔记库——三年攒下来的几百篇 Markdown,散在一个目录里。
你有三条现成的路,每条都走不通,但走不通的原因不一样。
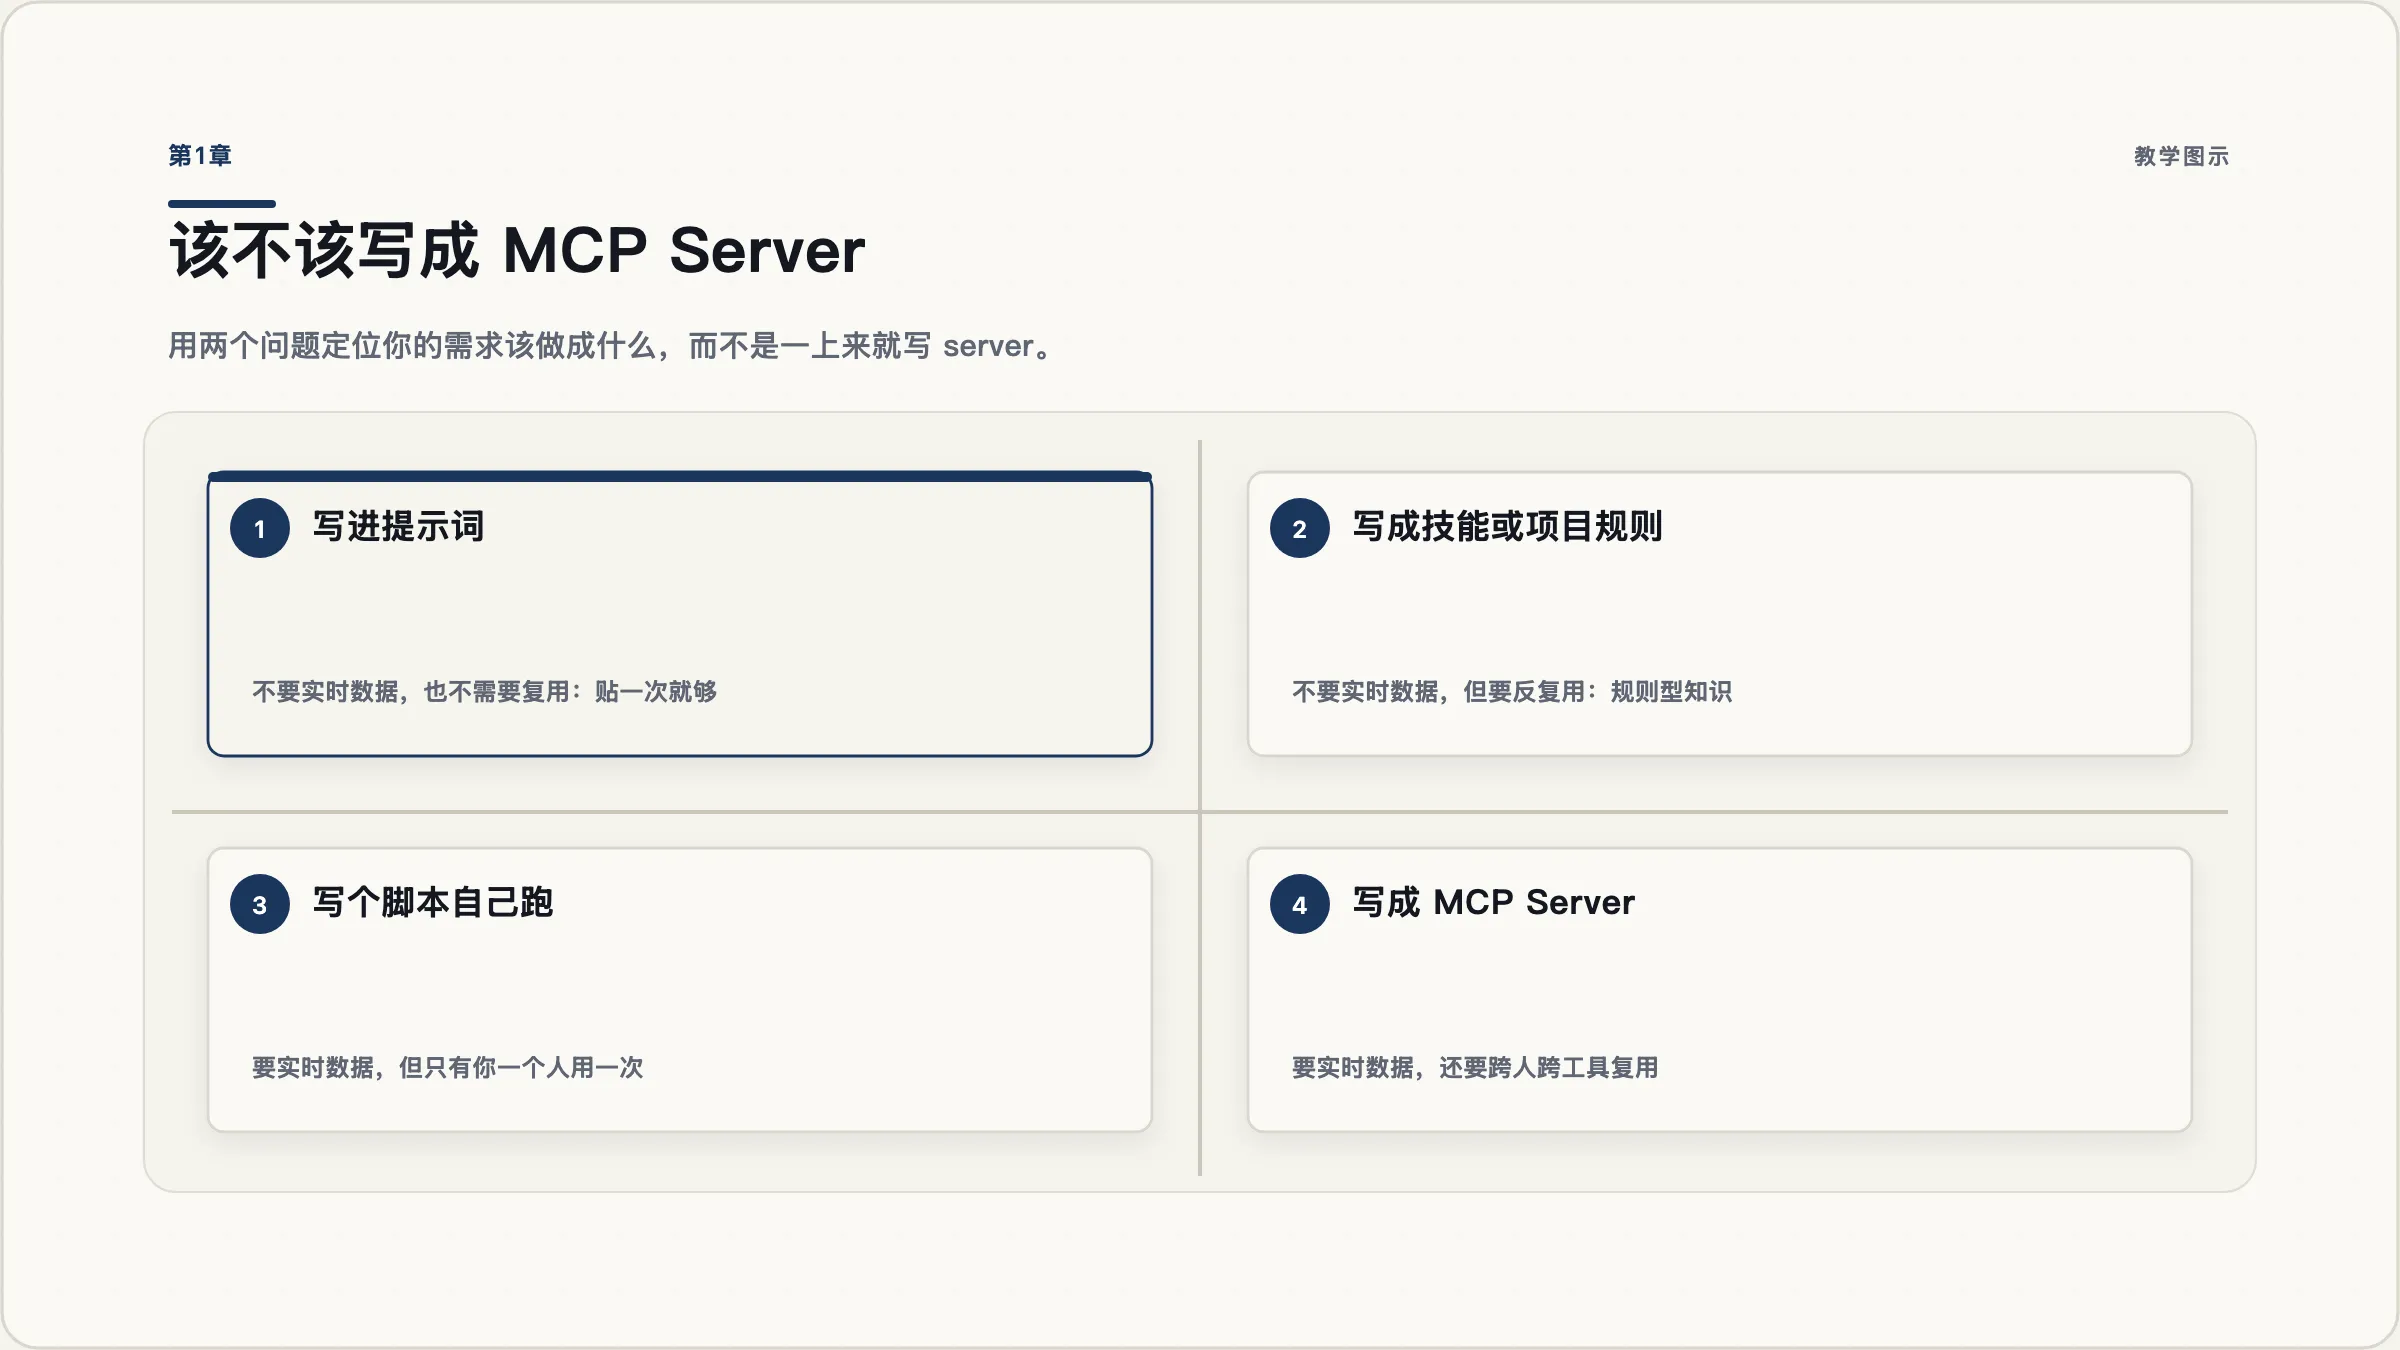
第一条:把笔记贴进提示词。 你把最相关的几篇复制进对话。它能用,但只有这一轮能用。下一轮换个话题,上下文被压缩,笔记就没了。更要命的是笔记会变——你今天贴的是旧版本,明天改了内容,模型还在用昨天那份。这条路的根本问题是快照不是连接。
第二条:写个脚本自己跑。 你写了个 search_notes.py,能按关键词搜。问题是模型不知道它存在。你得自己想起来该搜、自己敲命令、自己把输出贴回对话。AI 在这个流程里只是个读输出的人,不是使用工具的人。这条路的问题是模型没有调用权。
第三条:写成技能或者项目规则文件。 你把「怎么找笔记」写成一份说明放进 CLAUDE.md 或者一个技能里。这解决了「模型知道该做什么」,但没解决「模型能拿到数据」——说明文件是静态文本,它不会在被读取的那一刻去磁盘上查一遍。这条路的问题是规则不带数据。
MCP Server 同时解决这三个问题:它是一个持续运行的进程,模型每次调用它都会真的执行一次代码、拿到当下的真实数据;它以一份结构化契约的形式暴露自己,模型能自主发现并决定何时调用;而且这份契约是标准的,Claude Code 能用,Codex CLI 也能用,将来换工具还能用。
1.2 MCP 的三个角色,以及一个容易搞混的一对一关系
规范里的架构是三层,名字很容易混,但分清楚它们之后,后面所有的调试都会变简单。
Host(宿主) 是那个真正的应用:Claude Code、Codex CLI、Claude Desktop、你自己写的 agent 程序。它负责管理连接、执行安全策略、处理用户授权决定,也负责跟大模型对话。
Client(客户端) 是宿主内部的连接器。这是最容易被忽略的一层。规范里写得很明确:宿主应用创建并管理多个 client,而每个 client 与一个特定的 server 是一对一的关系。也就是说,你装了三个 MCP 服务器,宿主内部就有三个 client,各连各的,互不相通。
Server(服务器) 就是你要写的东西:一个独立的进程或服务,暴露工具、资源、提示词,职责聚焦,可以跑在本地也可以跑在远端。
这个架构有一条设计原则值得记住:server 不应该能读到整个对话,也不应该「看见」其它 server。你写的 server 只会收到宿主决定给它的那一个工具调用,看不到用户说了什么别的、也看不到隔壁那个 server 干了什么。这既是隐私边界,也意味着你不能指望从上下文里「顺便」拿到信息——需要什么,就得作为参数明确传进来。
官方文档给过一个很好的类比:MCP 的灵感部分来自 LSP(Language Server Protocol)——那个让一套语言支持能被所有编辑器复用的协议。MCP 想做的是同一件事,只不过对象从「编辑器和语言」变成了「AI 应用和外部能力」。写一次,处处能用。
1.3 什么时候不该写 MCP Server
这一节比上一节重要。写 server 是有持续成本的:它是一个要维护的进程,要跟着协议版本演进,要处理错误,出问题时用户第一个骂的是你。所以下面这几种情况,别写。
需求只有你一个人、只用一次。 直接写个脚本,让 AI 帮你运行它。工具化的价值来自复用,一次性的事情不值得包一层协议。
你要的只是一段固定说明。 「提交前要跑 lint」「这个项目用 pnpm 不用 npm」——这类是规则,写进项目的规则文件或技能里,成本低得多,也不需要一个进程常驻。
能力已经内建了。 读文件、跑命令、搜代码,主流 AI 编程工具本来就有。再包一个 MCP 工具去做同样的事,只会多占上下文、多一次工具选择的判断,还容易和内建能力冲突。
这件事绝对不能出错,而且没人复核。 MCP 工具是模型自主调用的。规范原文说得很直白:出于信任与安全考虑,应该始终有一个人在回路里,有能力拒绝工具调用。如果你打算写一个「直接在生产库上执行 SQL」的工具,先想清楚谁来按那个确认键。
反过来,值得写的信号也很清楚:这件事需要实时数据(每次调用结果都可能不同)、需要跨工具或跨人复用(不止你一个人、不止一个客户端)、而且模型自己判断什么时候用比你手动触发更合适。三条都占,就写。
1.4 用一句话说清你要写的东西
动手之前,先用这个句式把需求写下来,写不出来说明还没想清楚:
我要让 [哪个 AI 应用] 能够 [做什么动作],数据来自 [哪里],调用时机由 [模型自主判断 / 用户显式触发] 决定,出错的最坏后果是 [什么]。
本教程贯穿的例子填出来是这样:
我要让 Claude Code 和 Codex CLI 能够 搜索、读取和追加我的本地 Markdown 笔记,数据来自 本机一个笔记目录,调用时机由 模型自主判断(我问到相关问题时它自己去查),出错的最坏后果是 写坏或泄露我的笔记内容。
最后那一格特别重要。它在第 11 章会变成你的安全清单——最坏后果是「泄露笔记内容」,所以那一章我们会认真处理路径边界,不让工具能读到笔记目录以外的任何文件。