第 6 章 / 共 12 章
输入不可信,外部会挂:校验、错误与返回设计
6.1 一个真实的失败现场
你的 search_notes 在 Inspector 里跑得好好的。接进 Claude Code 之后,用户问了一句「帮我找找上个月关于 MCP 的笔记」,模型调用了工具,然后对话卡住了——模型说「搜索失败了」,然后开始向用户道歉,或者更糟:它绕过工具,凭记忆编了一段内容。
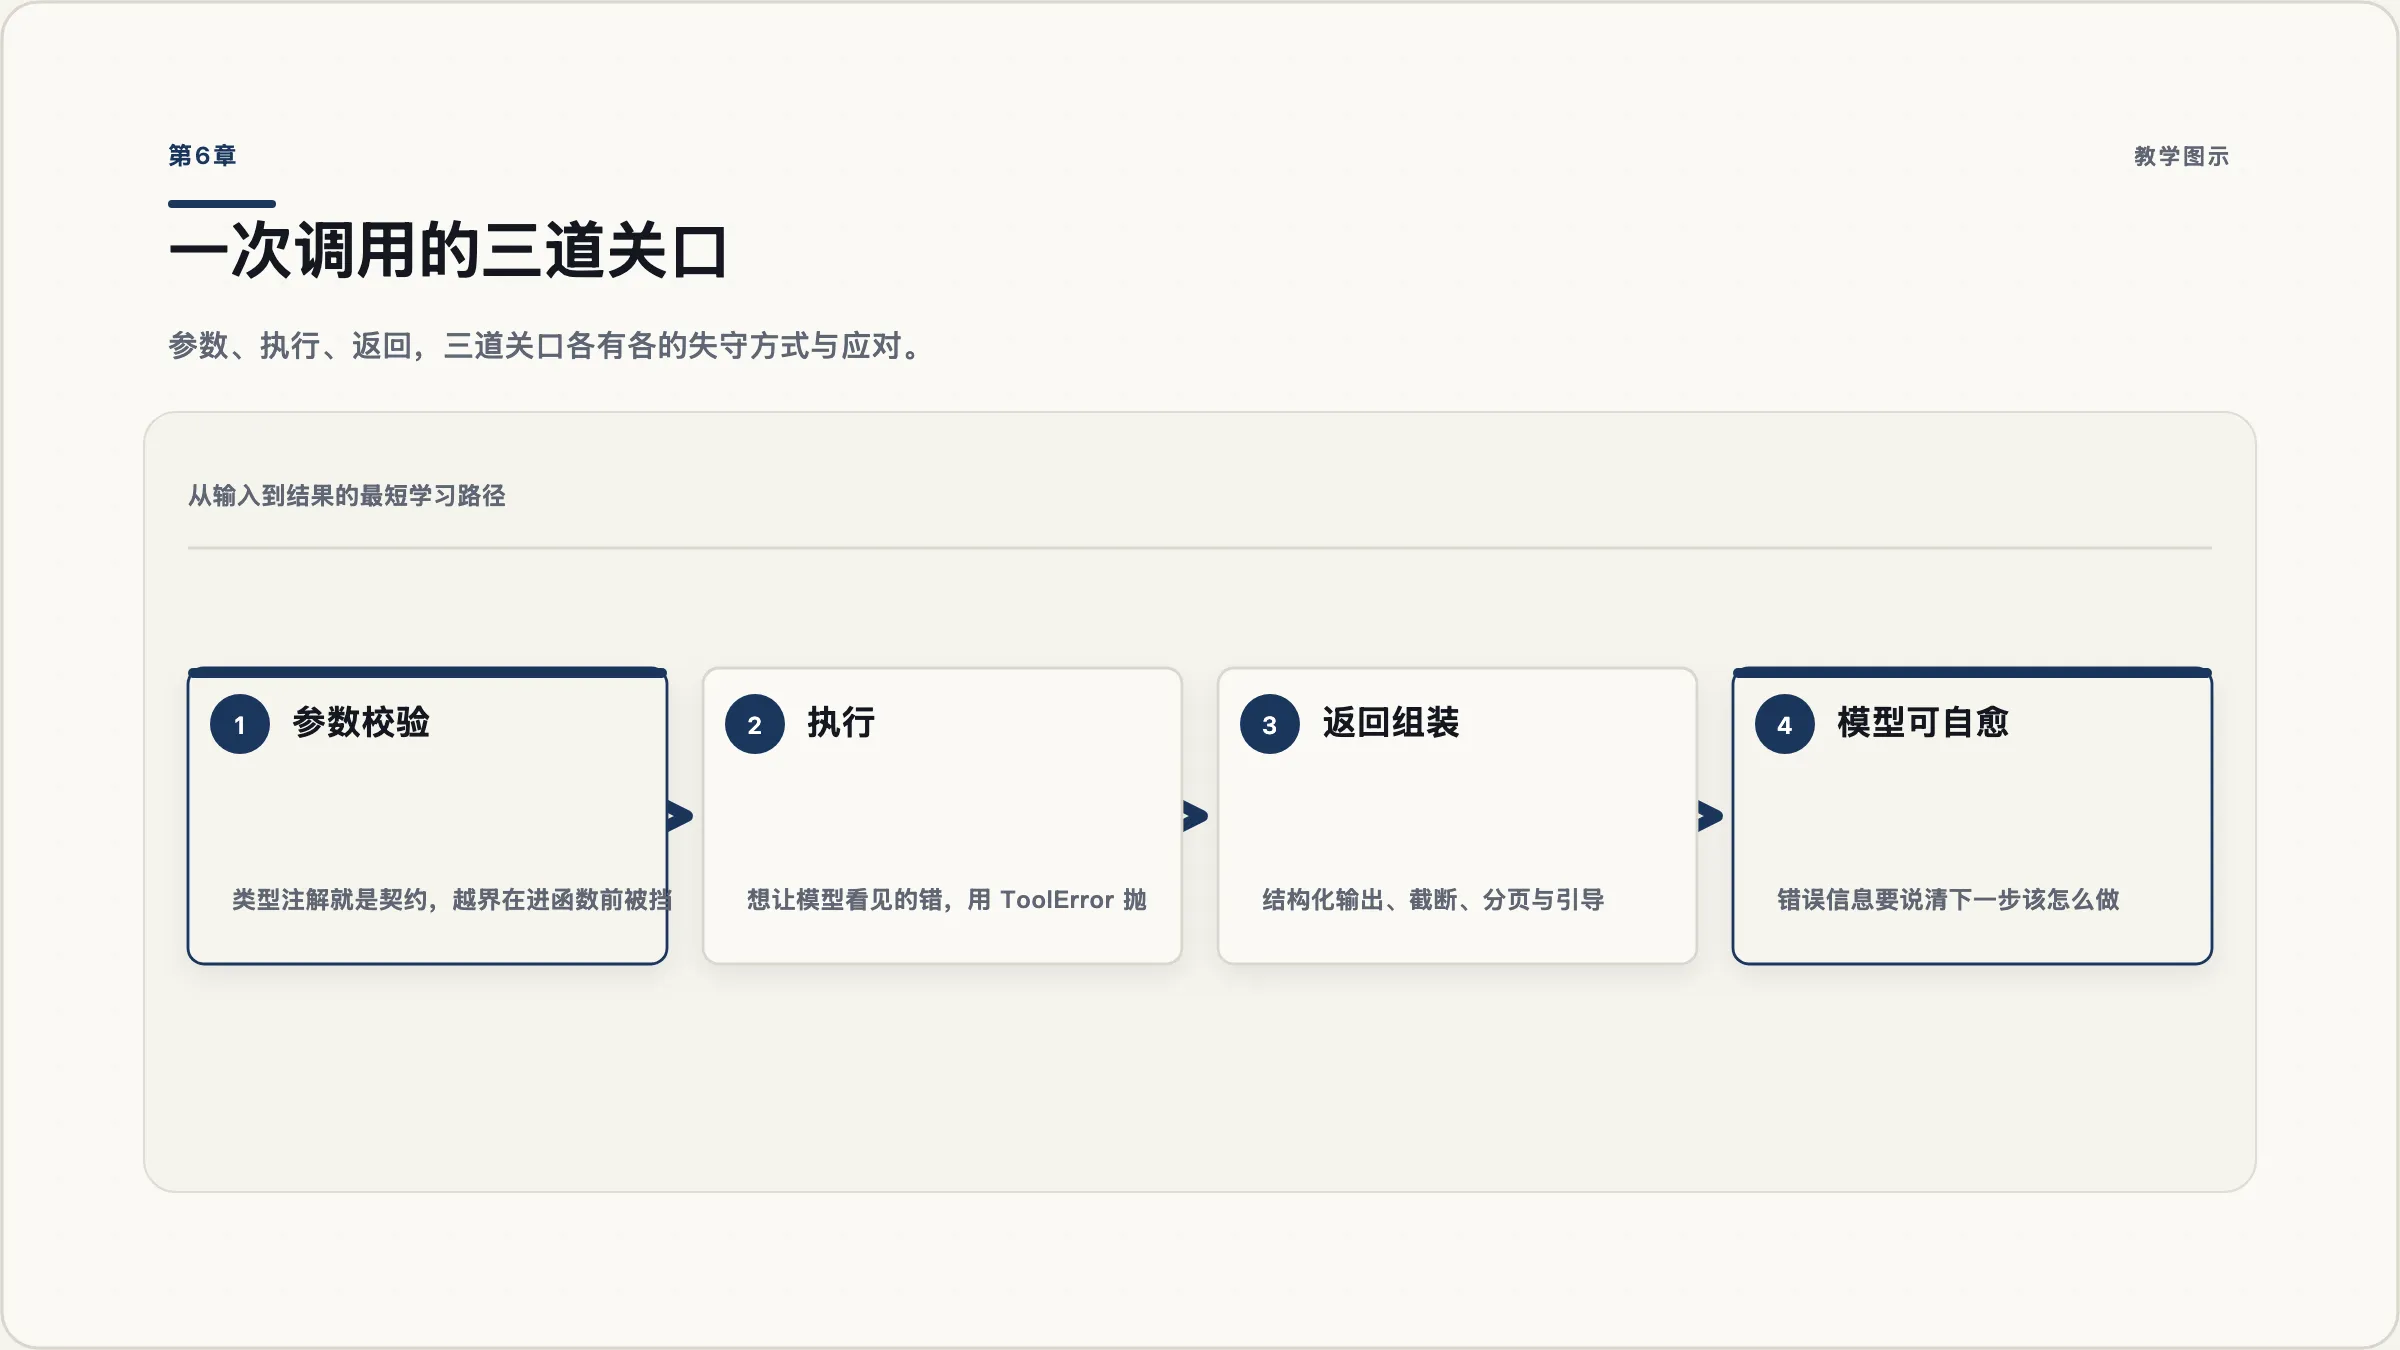
拆开看,失败可能发生在三个地方:
- 模型传了不合法的参数(比如把
limit传成"十条")。 - 你的代码在执行中抛异常(笔记目录不存在、文件编码不对、外部 API 超时)。
- 执行成功了,但返回的东西模型用不了(太长被截断、格式混乱、没有下一步线索)。
这三种情况需要三套不同的应对。这一章就是把它们分别处理干净。
6.2 第一道关口:让类型注解替你挡住脏数据
好消息是这一关基本不用你写代码。类型注解就是契约,SDK 会在进入函数之前校验参数。第 5 章那个带约束的签名,实际拦截效果是这样的——客户端传 limit=99(上限是 50):
{
  "content": [{
    "type": "text",
    "text": "Error executing tool search_notes: 1 validation error for search_notesArguments\nlimit\n  Input should be less than or equal to 50 [type=less_than_equal, input_value=99, input_type=int]"
  }],
  "isError": true,
  "resultType": "complete"
}
你的函数一行都没执行。而模型收到的这段话足够具体,它知道该把 limit 改到 50 以内重试。
所以约束要写进类型,不要写进函数体。 对比一下:
# 不推荐:模型看不见这条规则,只有撞上了才知道
def search_notes(keyword: str, limit: int = 10) -> str:
    if limit > 50:
        raise ValueError("limit 最大 50")

# 推荐:规则出现在 schema 里,模型调用前就知道
def search_notes(
    keyword: str,
    limit: Annotated[int, Field(ge=1, le=50)] = 10,
) -> str: ...
前者模型要先失败一次才知道规则;后者模型第一次就能传对。
6.3 第二道关口:两种错误机制,别选错
规范定义了两种错误上报方式,它们的差别决定了模型能不能自己恢复。
协议错误是标准的 JSON-RPC 错误,用于请求本身有问题的场合:调用了不存在的工具、请求结构不合法、服务器内部故障。
工具执行错误是一个正常的 result,但 isError 为 true,内容里放错误信息。用于 API 调用失败、输入校验失败、业务逻辑错误。
规范对两者的定位说得很清楚:工具执行错误包含可操作的反馈,语言模型能用它自我纠正并调整参数重试;而协议错误说明请求结构本身有问题,模型不太可能修好它。因此客户端应该把工具执行错误交给模型,让它自我纠正。
这里有一个版本变化要注意:输入校验失败该算哪一类,2025-11-25 版本做过一次修正——明确规定输入校验错误应当作为工具执行错误返回(也就是 isError: true),而不是协议错误,目的正是让模型能自我纠正。这和更早版本的说法不同,你读旧文档时会看到相反的表述。
好消息是,用 SDK 的高层 API 写工具时,这件事默认就是对的:上一节那个越界的 limit,返回的就是 isError: true 的正常结果。
6.4 一个不看源码就发现不了的坑:你的异常信息会被吞掉
现在看第二种失败:你的代码抛异常了。
直觉上,你会这么写:
@mcp.tool()
def read_note(filename: str) -> str:
    """读取一篇笔记的全文。"""
    path = NOTES_DIR / filename
    if not path.exists():
        raise ValueError(f"笔记 {filename} 不存在。可以先用 search_notes 确认文件名。")
    return path.read_text(encoding="utf-8")
你精心写了一句能引导模型自我纠正的错误信息。但模型实际收到的是:
{
  "content": [{"type": "text", "text": "Error executing tool read_note"}],
  "isError": true
}
你那句话没有了。 SDK 会把普通异常的细节遮蔽掉,只留一句「执行工具时出错」——这是有意的安全设计,防止把内部堆栈、路径、连接串泄露给模型和用户。异常详情会记进服务端日志,但不会跨越协议边界。
想让错误信息真的传给模型,要抛一个专门的异常类型:
from mcp.server.mcpserver.exceptions import ToolError

@mcp.tool()
def read_note(filename: str) -> str:
    """读取一篇笔记的全文。"""
    path = NOTES_DIR / filename
    if not path.exists():
        raise ToolError(f"笔记 {filename} 不存在。可以先用 search_notes 确认文件名。")
    return path.read_text(encoding="utf-8")
这次模型收到的是完整的一句:
Error executing tool read_note: 笔记 notes.md 不存在。可以先用 search_notes 确认文件名。规则记下来:想让模型看到的错误,用 ToolError 显式抛出;不想让它看到的(内部故障、依赖异常),让原始异常自然冒泡,SDK 会替你遮蔽。 这个区分很好用——它逼着你每次都明确回答一个问题:这条错误信息,是给模型看的,还是给我自己排查用的?
6.5 错误信息要写给模型看
既然错误信息会进模型的上下文,它就该按「让模型知道下一步做什么」来写。工具设计指南的原话是:错误响应应当传达具体的、可操作的改进方向,而不是不透明的错误码或堆栈。
对照着改:
| 写给机器的(差) | 写给模型的(好) |
|---|---|
FileNotFoundError: notes.md | 笔记 notes.md 不存在。可以先用 search_notes 确认文件名。 |
Invalid date | 日期格式应为 YYYY-MM-DD,收到的是 "上个月"。如果要按相对时间搜索,请先换算成具体日期。 |
Rate limited | 上游接口限流,请等待 30 秒后重试;或者把 limit 调小到 10 以内减少请求量。 |
Permission denied | 没有写入权限。这个工具只能写入笔记目录内的文件,收到的路径在目录之外。 |
三条通用规则:说清哪里错了、说清正确的形态是什么、说清下一步该怎么做。
6.6 第三道关口:返回什么,以及返回多少
执行成功了,还有最后一个设计问题:返回体。
两个通道。 第 3 章见过,工具结果里有 content(给模型看的文本块)和 structuredContent(给宿主程序用的结构化数据)。规范建议:返回结构化内容的工具,同时也应该在文本块里返回序列化后的 JSON,以保证兼容性。SDK 会替你做这件事。
返回类型决定 output schema。 这是 SDK 里一条很值得利用的规则:
| 返回类型 | 结果形态 |
|---|---|
str / int / float / bool | 包一层 {"result": ...} |
| Pydantic 模型 | 直接就是该模型的 schema,不加包装 |
| TypedDict / dataclass | 同上 |
list[...] | 不是 JSON 对象,所以包成 {"result": [...]} |
所以想让宿主拿到干净的结构化数据,就定义一个 Pydantic 模型当返回类型,Field(description=...) 会一起进 schema:
class Hit(BaseModel):
    file: str = Field(description="笔记文件名")
    line: int = Field(description="命中所在行号")
    text: str = Field(description="该行原文")

class SearchResult(BaseModel):
    total: int = Field(description="命中总数")
    truncated: bool = Field(description="是否因超出上限被截断")
    hits: list[Hit] = Field(description="命中列表")
注意 truncated 这个字段——它是下一段的重点。
返回多少,是个成本问题。 工具返回的一切都会进模型的上下文。一个「返回全部命中」的搜索工具,遇到一个高频词就能把上下文塞满,后面的对话质量会一路下滑。
工具设计指南给了几条具体做法:实现分页、区间选择、过滤和截断,并给合理的默认值;优先返回上下文相关的信息而不是追求灵活性;避免返回 UUID、MIME type 这类低层技术标识符,换成语义化的标识。
还有两条特别实用:
其一,暴露一个详略开关。指南建议给工具加一个枚举参数让模型自己选详细还是简洁,简洁版可以减少约 66% 的 token 消耗。落到笔记库上:
response_format: Literal["concise", "detailed"] = "concise"简洁版只返回文件名和命中行,详细版才带上下文的前后各两行。
其二,截断时要给指引。返回被截断了,不要默默截断,要在返回里告诉模型该怎么办。指南举的例子就是引导模型去做多次小范围的精确搜索,而不是一次宽泛的大搜索。
if result.truncated:
    hint = (
        f"共命中 {result.total} 条,只返回了前 {limit} 条。"
        "结果太多说明关键词太宽泛,建议换一个更具体的词,或者把 scope 设为 titles 只搜标题。"
    )
这句话会让模型自己收窄搜索,而不是让用户等一个永远填不满的上下文。