第 2 章 / 共 12 章
三十行跑起来:第一个 stdio server
2.1 建项目:三条命令
MCP 官方 Python SDK 发布在 PyPI 上,包名就叫 mcp。开发期建议装上 cli 这个 extra,它会带来一个 mcp 命令行工具,第 2.5 节要用。
uv init --python 3.12 notes-mcpcd notes-mcp && uv add "mcp[cli]"装完确认一下版本,后面遇到问题时这是第一个要报的数字:
uv pip show mcp写这份教程时它是 2.1.1(2026 年 8 月 25 日发布),要求 Python 3.10 以上。如果你看到的是 1.x,本教程后面所有代码都需要改写——原因见 2.4 节。
再准备一点素材,让第一个工具有东西可搜:
mkdir notes && printf '# 会议记录\n2026-09-01 讨论了 MCP 选题。\n' > notes/meeting.md2.2 第一个工具:一个函数,加一个装饰器
新建 server.py:
from pathlib import Path

from mcp.server import MCPServer

mcp = MCPServer("notes")
NOTES_DIR = Path(__file__).parent / "notes"

@mcp.tool()
def search_notes(keyword: str) -> str:
    """在本地笔记库里按关键词搜索,返回匹配的文件名与所在行。"""
    hits: list[str] = []
    for path in sorted(NOTES_DIR.glob("*.md")):
        for lineno, line in enumerate(path.read_text(encoding="utf-8").splitlines(), 1):
            if keyword in line:
                hits.append(f"{path.name}:{lineno}: {line.strip()}")
    return "\n".join(hits) if hits else f"没有笔记包含 {keyword!r}。"

if __name__ == "__main__":
    mcp.run()
就这些。没有路由表,没有 schema 定义文件,没有 JSON-RPC 的影子。
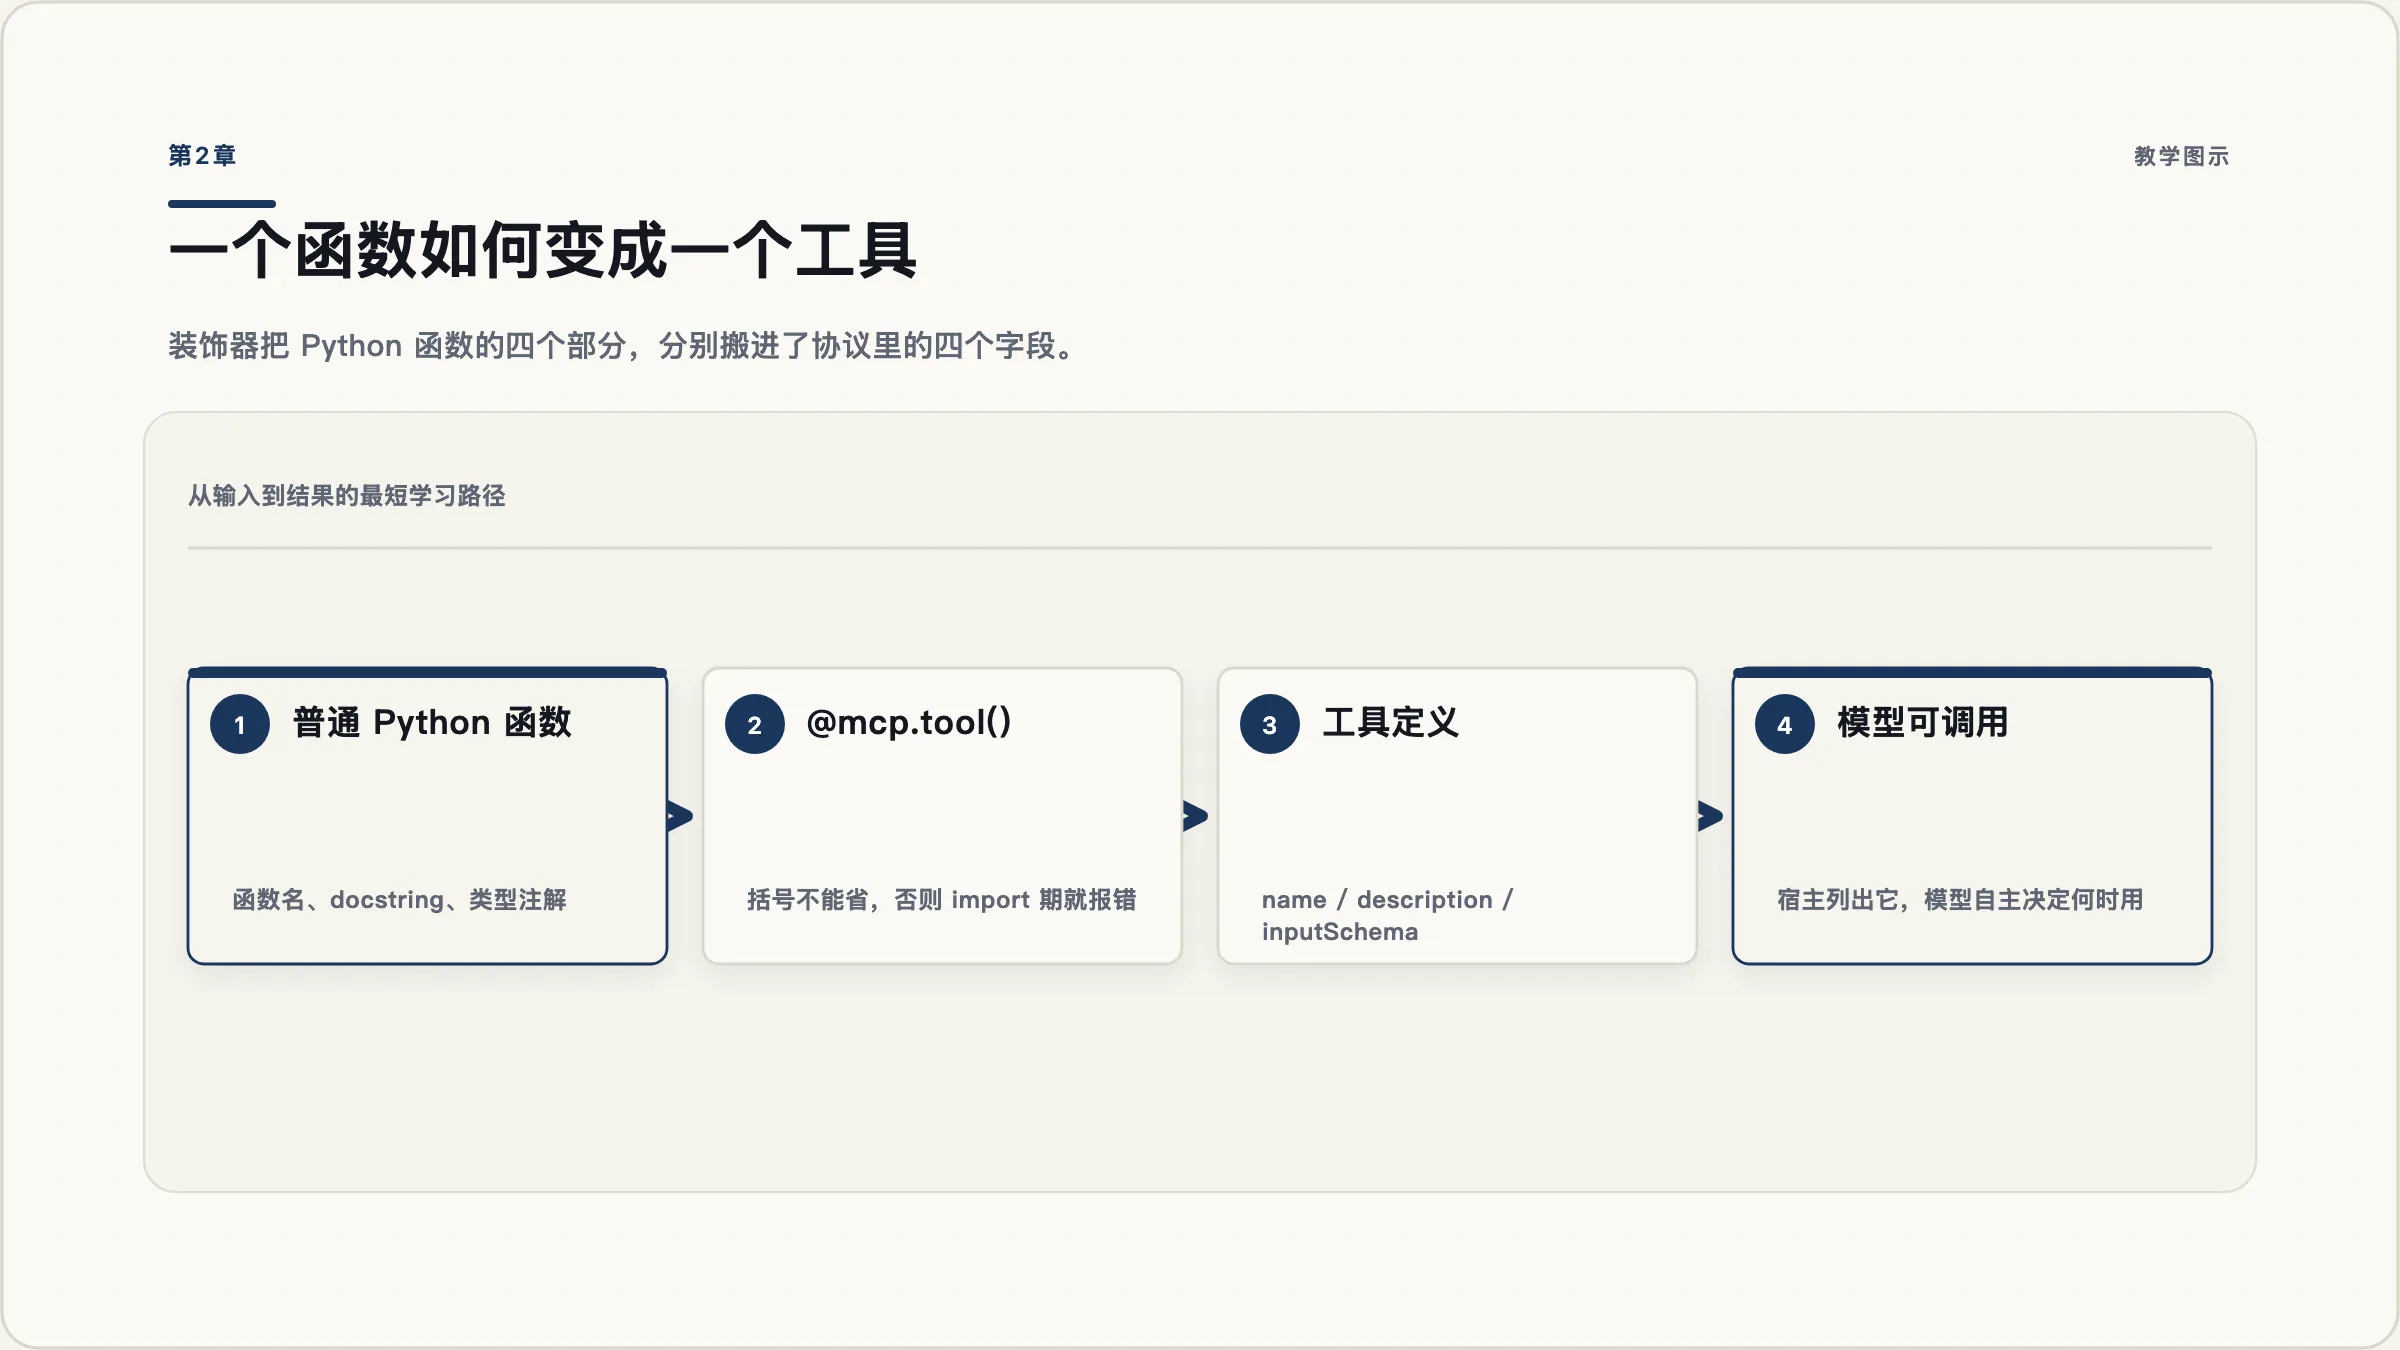
2.3 这三十行里,每一样东西都变成了什么
这是本章最该慢读的一节。SDK 帮你做的事,正是你调试时需要反向推理的事。
MCPServer("notes") 创建一个 server 实例,"notes" 是它的名字,会出现在宿主的服务器列表里。构造函数还接受 version、title、instructions、lifespan 等参数,后面几章会陆续用到。
@mcp.tool() 把下面这个函数注册成一个工具。注意括号必须写。写成 @mcp.tool 会在 import 阶段直接抛异常:
TypeError: The @tool decorator was used incorrectly. Did you forget to call it? Use @tool() instead of @tool这个错误的表现很有迷惑性——宿主那边看起来是「server 里一个工具都没有」,因为进程根本没起来。@mcp.resource() 和 @mcp.prompt() 同理。
函数名 search_notes 成为工具的 name,也就是模型调用时要写的标识符。
docstring 成为工具的 description——这是模型判断「要不要用这个工具」时看的主要依据。它不是给人看的注释,是 API 的一部分。第 5 章整章都在讲怎么写好它。
类型注解 keyword: str 变成参数的 JSON Schema。没有默认值的参数进 required。
返回值注解 -> str 变成输出的 schema。
mcp.run() 启动 server。不传参数时默认走 stdio 传输:从标准输入读消息,往标准输出写消息。它是同步函数,内部自己起事件循环。支持的 transport 只有三个取值:"stdio"(默认)、"sse"(旧传输,别用,理由见第 10 章)、"streamable-http"。
这些不是「大概是这样」——把上面那个 server 跑起来,让它列一次工具,它实际吐出来的就是这个:
{
  "name": "search_notes",
  "description": "在本地笔记库里按关键词搜索,返回匹配的文件名与所在行。",
  "inputSchema": {
    "type": "object",
    "properties": {
      "keyword": {"title": "Keyword", "type": "string"}
    },
    "required": ["keyword"],
    "title": "search_notesArguments"
  },
  "outputSchema": {
    "type": "object",
    "properties": {"result": {"title": "Result", "type": "string"}},
    "required": ["result"],
    "title": "search_notesOutput"
  }
}
对着看一遍:函数名去了 name,docstring 去了 description,参数注解去了 inputSchema,返回注解去了 outputSchema。返回的是个裸字符串,所以 SDK 给它包了一层 {"result": ...}——这个包装规则在第 6 章还会再遇到。
2.4 你在网上看到的写法,为什么跑不起来
如果你现在去搜「MCP Server Python 教程」,排在前面的文章第一行几乎都是这句:
from mcp.server.fastmcp import FastMCP # 这行现在会报错在 mcp 2.x 里,这条 import 会抛 ModuleNotFoundError,而且 SDK 特意在错误信息里写清了原因和迁移文档地址。FastMCP 被改名为 MCPServer 了。
这不是唯一的改名。2.x 是一次相当彻底的重构,下面这张表是最容易撞上的几处。遇到「照着教程抄却报错」时,先来这里对一遍:
| 你会看到的旧写法 | 现在的写法 | 撞上时的症状 |
|---|---|---|
from mcp.server.fastmcp import FastMCP | from mcp.server import MCPServer | ModuleNotFoundError |
FastMCP("X", host=..., port=...) | 参数移到 run(...) / streamable_http_app(...) | TypeError: unexpected keyword argument 'port' |
tool.inputSchema | tool.input_schema | AttributeError |
ToolAnnotations(readOnlyHint=True) | ToolAnnotations(read_only_hint=True) | 参数不被识别 |
get_context() | 在参数上声明 ctx: Context | 函数不存在 |
ctx.sample(...) | Annotated[T, Resolve(fn)] 依赖注入 | 方法不存在 |
@server.list_tools()(低层 API) | Server(..., on_list_tools=...) | AttributeError |
import httpx | 依赖换成了 httpx2 | 示例代码 import 失败 |
协议类型整体从 camelCase 改成了 snake_case(线上序列化仍是 camelCase,只是 Python 属性名变了)。
如果你手上有跑着的 1.x 项目暂时不想迁,就在依赖里锁住上限,别让它悄悄升上来:
dependencies = ["mcp>=1.28,<2"]还有一个独立项目容易和这件事混淆:fastmcp。它是社区里那个 FastMCP 的延续(仓库已经从 jlowin/fastmcp 迁到 PrefectHQ/fastmcp),现在是 4.x,构建在官方 SDK 之上,是另一个包、另一套 API——比如它的 @mcp.tool 不带括号,跟官方的正好相反。本教程全程用官方 SDK。你选哪个都行,但别把两边的代码片段混着抄。
2.5 用 Inspector 看见它
server 写完了,但你还没法用它——它是个等着别人连的进程,自己跑起来只会静静地等标准输入。
调试 MCP server 的标准工具是 MCP Inspector,一个官方的可视化调试客户端。SDK 的 CLI 直接封装了它:
uv run mcp dev server.py这条命令背后是 npx @modelcontextprotocol/inspector,所以本机需要有 Node 和 npx;没有的话它会明确报错退出。命令会打开一个网页界面,在里面你可以列出工具、填参数、点调用、看原始返回。
在 Inspector 里做三件事,第一章就算完成:
- 连接上 server,左边出现服务名。
- 打开工具列表,看到
search_notes,以及它的参数表单。 - 在
keyword里填MCP,点调用,下方出现你笔记里的那一行。
第 8 章会专门讲 Inspector 的各个标签页分别在看什么,以及连不上时怎么定位。现在只要能走完这三步就够了。
2.6 唯一会让你怀疑人生的坑:print
这个坑值得单独占一节,因为它的症状和原因离得特别远。
stdio 传输的规则是:server 从 stdin 读 JSON-RPC 消息,往 stdout 写 JSON-RPC 消息,消息之间用换行分隔。规范原文写得非常硬:
服务器绝不能向 stdout 写入任何不是有效 MCP 消息的内容。
意思是,你在 server 里随手写的一行 print("开始搜索"),会直接落进协议流。宿主读到一行不是合法 JSON-RPC 的东西,通常的反应就是断开连接。而你在宿主界面上看到的症状是——这个 server 里什么工具都没有。你会去检查装饰器、检查注册、检查配置,唯独想不到是那行 print。
新版 SDK 做了一些补救:运行期间它会尽力把游离的 stdout 内容转发到 stderr。但补救不完全——包装脚本里的 echo、模块 import 阶段的 print、以及被缓冲到解释器退出时才排空的 print,仍然会污染协议流。
结论很简单:server 代码里永远不要用 print,用 logging。 日志写到 stderr 是规范明确允许的,而且规范特意澄清过:stderr 可以承载所有级别的日志,不只是错误,客户端也不应该把 stderr 上有输出就当成出错了。
import logging

logging.basicConfig(level=logging.INFO)   # 默认就写到 stderr
log = logging.getLogger("notes")

log.info("这样写是安全的")
顺带说一个第 7 章会再遇到的点:SDK 上下文对象也提供 ctx.info() 这类方法,它们通过协议把日志发给客户端。但协议级 logging 能力在 2026-07-28 版本里已经被标记为弃用,实际调用会打出弃用警告。新写的 server 就用 Python 的 logging 往 stderr 写,不要用协议 logging。