第 5 章 / 共 12 章
描述就是 API:让模型准确地调用
5.1 模型看不见你的代码,只看得见那几行字
这是新手最常撞上、也最难自己诊断的一类问题:工具明明注册好了,Inspector 里手动调用一切正常,可是在真实对话里,模型就是不用它,或者用错参数。
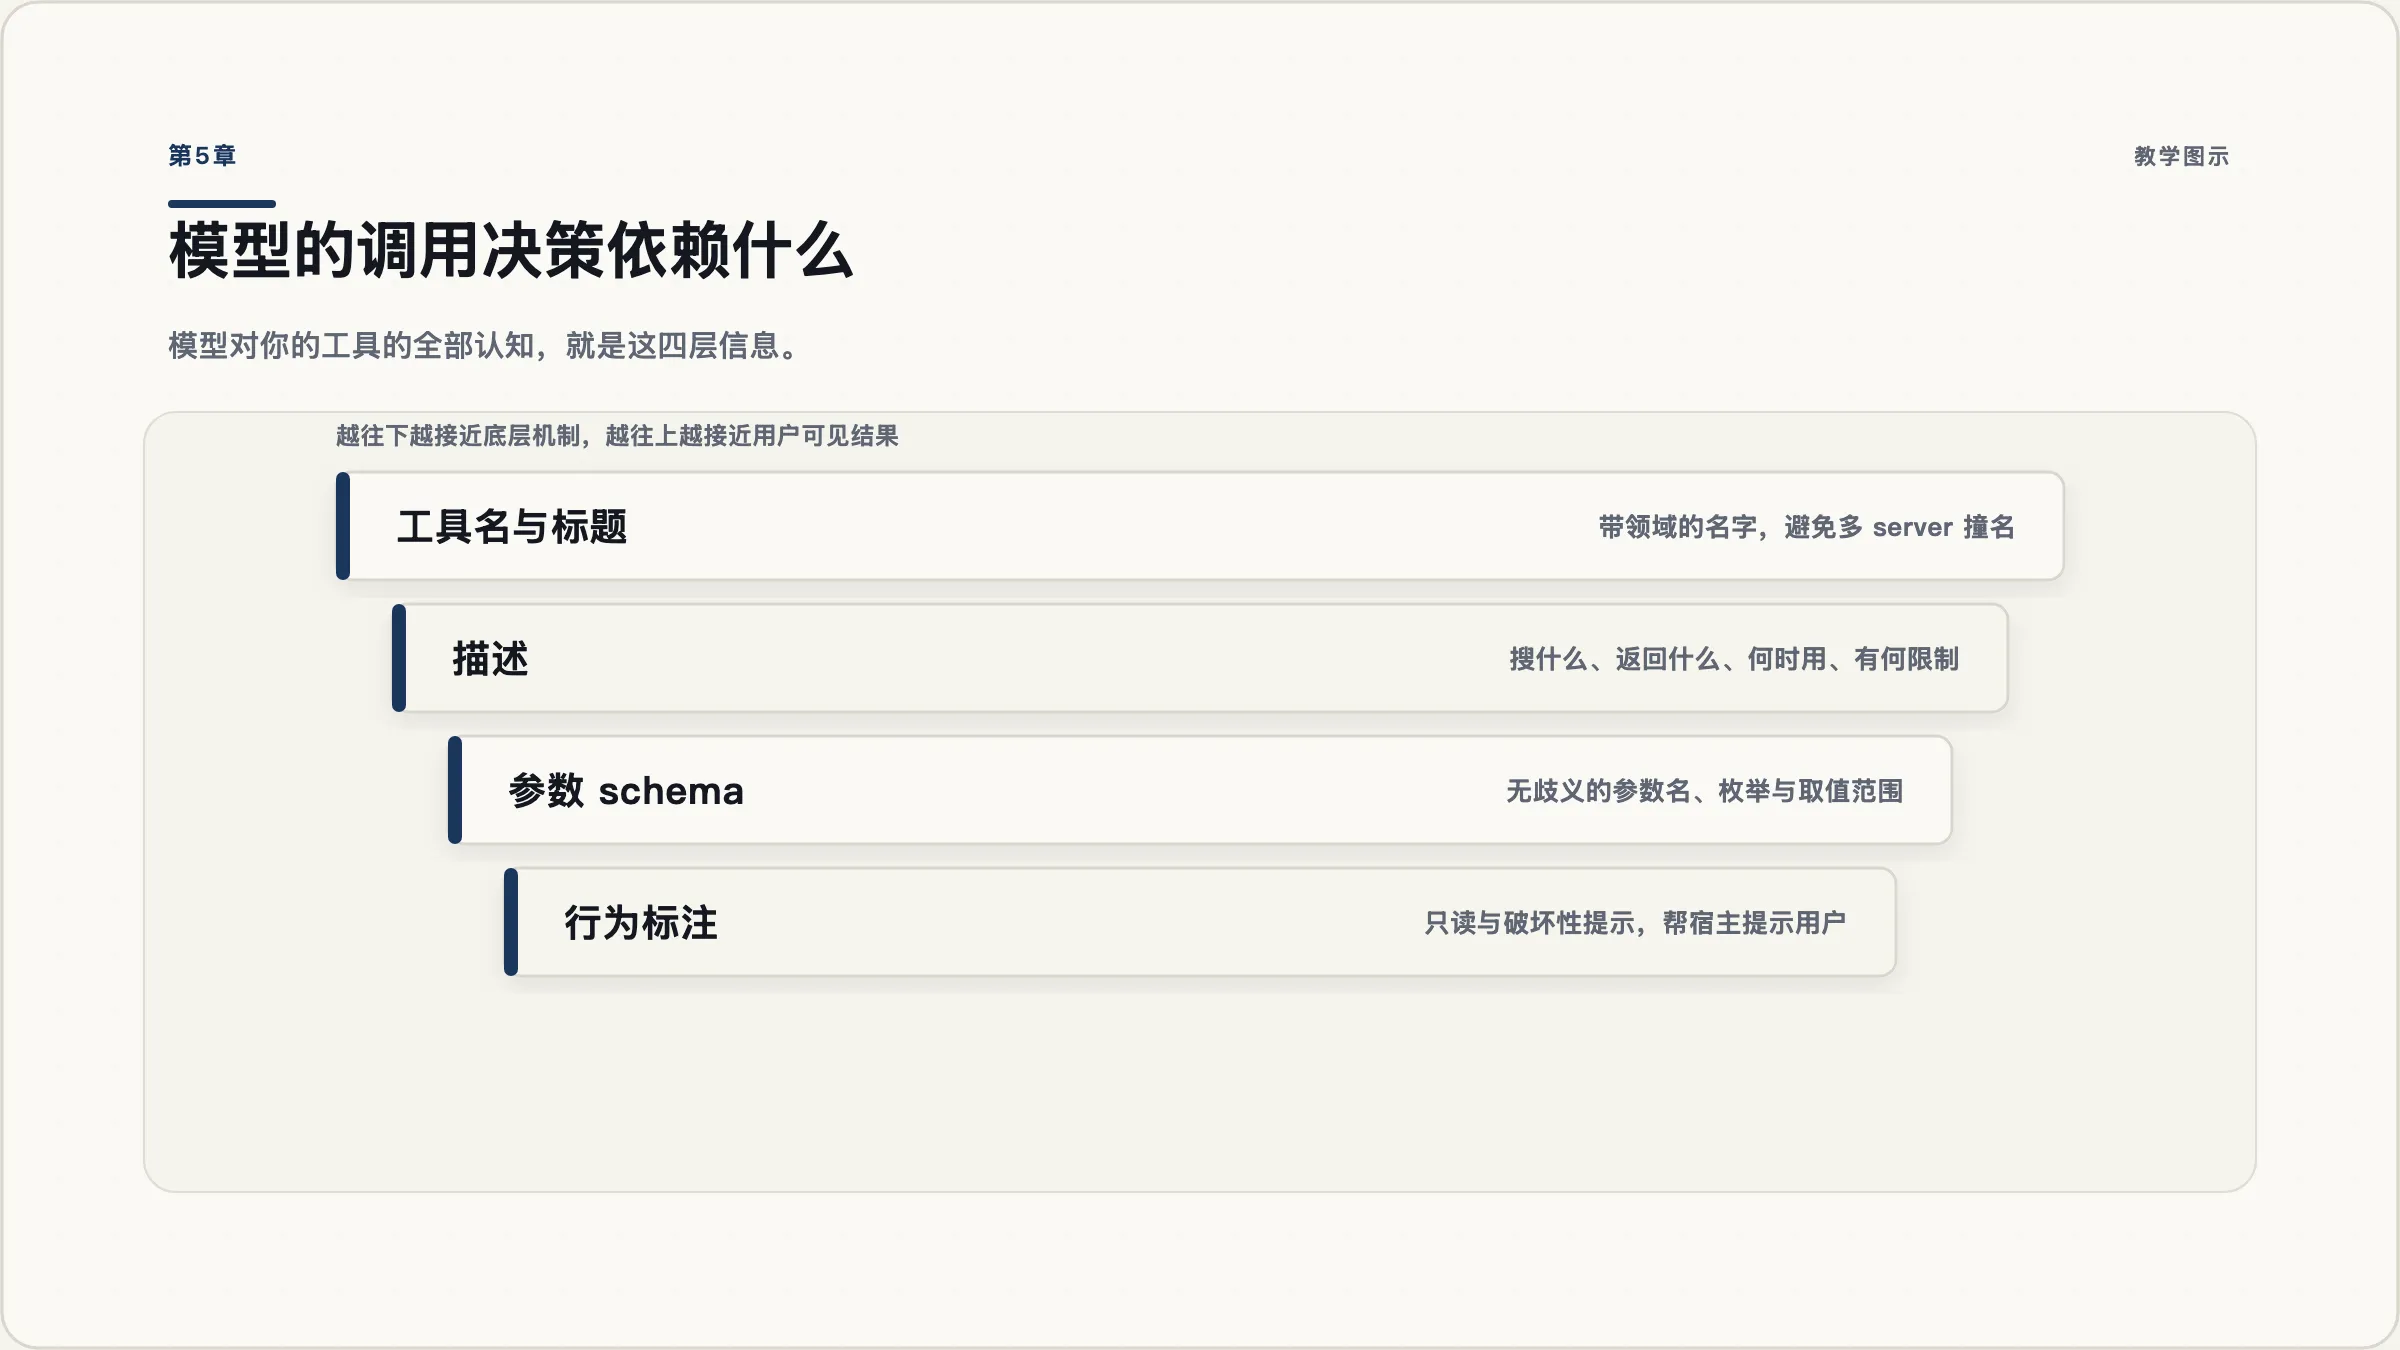
原因很直接:模型对你的工具的全部认知,就是 tools/list 里返回的那几个字段。它看不到你的函数体,看不到你的项目结构,也不知道你心里想的使用场景。它只有名字、标题、描述和参数 schema。
所以工具描述不是注释,是 API 契约。Anthropic 的工具设计指南里有一句话很值得贴在显示器上:对工具描述做很小的改进,就可能带来极大的效果提升。
那份指南给的建议是:把工具描述当成写给新员工的入职文档。一个刚入职的聪明人,只读你这段话,能不能判断出什么时候该用这个工具、要传什么、会拿到什么?
5.2 一次改写:从「能用」到「好用」
先看一个典型的、能跑但很糟的工具:
@mcp.tool()
def search(q: str, n: int = 10) -> str:
    """搜索。"""
    ...
它的问题不止一处:
- 名字
search太泛。宿主里同时装了三个 server,可能有三个search,模型无从判断该用哪个。 - 描述「搜索」等于没写。搜什么?搜哪里?什么时候该用?
- 参数名
q和n是给人打字省事的,不是给模型理解用的。 - 没有取值范围,模型可能传
n=10000。 - 没有说明返回什么,模型不知道拿到结果之后能干什么。
改写之后:
from typing import Annotated, Literal

from pydantic import Field

@mcp.tool(title="搜索笔记")
def search_notes(
    keyword: Annotated[str, Field(min_length=1, description="要搜索的关键词,区分大小写。")],
    limit: Annotated[int, Field(ge=1, le=50, description="最多返回多少条命中。")] = 10,
    scope: Literal["all", "titles"] = "all",
) -> str:
    """在用户的本地 Markdown 笔记库里按关键词搜索。

    返回每条命中的文件名、行号与该行原文。适合在用户提到"我之前记过""我的笔记里"
    这类线索时使用。搜索是纯文本匹配,不支持正则;想缩小范围时把 scope 设为 titles,
    只搜每篇笔记的标题行。找不到内容时返回一句说明,不是错误。
    """
    ...
对照着看改了什么:
- 名字加了领域:
search_notes而不是search。Anthropic 的指南建议用前缀或后缀做命名空间,比如按服务分(asana_search、jira_search)或按资源分(asana_projects_search)。指南里还特意说明,用前缀式还是后缀式对效果有不可忽略的影响,而且因模型而异——所以这是个需要你自己实测的选择,不是照抄就行的规则。 - 参数名讲人话:
keyword、limit而不是q、n。指南的建议是参数名要无歧义,比如用user_id而不是user。 - 约束写进 schema:
min_length=1、ge=1, le=50。这些会真的出现在inputSchema里,模型能看见,SDK 也会真的拦截越界的值。 - 枚举用
Literal:scope的取值直接变成 schema 里的enum,模型不用猜。 - description 回答了四个问题:搜什么、返回什么、什么时候用、有哪些限制。特别是「什么时候用」那一句——它给了模型触发的线索。
- 加了
title:name是给程序用的标识符,title是给人看的显示名。
这些改动实际发出去的 schema 是这样的(真实输出,节选):
{
  "properties": {
    "keyword": {
      "description": "要搜索的关键词,区分大小写。",
      "minLength": 1, "title": "Keyword", "type": "string"
    },
    "limit": {
      "default": 10, "description": "最多返回多少条命中。",
      "maximum": 50, "minimum": 1, "title": "Limit", "type": "integer"
    },
    "scope": {
      "default": "all", "enum": ["all", "titles"], "title": "Scope", "type": "string"
    }
  },
  "required": ["keyword"]
}
Annotated[..., Field(...)] 里写的每一个字,都变成了模型能读到的东西。
5.3 annotations:四个提示,和它们不对称的默认值
除了描述,工具还能带一组行为标注,告诉客户端「这个工具会做什么样的事」:
from mcp.types import ToolAnnotations

@mcp.tool(
    title="搜索笔记",
    annotations=ToolAnnotations(read_only_hint=True, open_world_hint=False),
)
def search_notes(...) -> str: ...四个字段和它们在规范里的默认值——这是最容易搞错的地方,因为它们不对称:
| 字段 | 含义 | 默认值 |
|---|---|---|
read_only_hint | 工具不修改环境 | false |
destructive_hint | 工具可能做破坏性更新(false 表示只做增量更新) | true |
idempotent_hint | 用相同参数重复调用不会产生额外影响 | false |
open_world_hint | 工具会与开放世界的外部实体交互 | true |
也就是说,你什么都不标的时候,客户端假设的是:这个工具会改环境、会破坏、不幂等、面向开放世界。这是安全的默认,但对一个只读工具很不划算——宿主可能因此给它加上更严格的确认流程。只读工具值得显式标 read_only_hint=True。
两个容易踩的细节:destructive_hint 和 idempotent_hint 只在 read_only_hint 为 false 时才有意义;另外它们的名字里都有 “hint”,规范对客户端的要求是——除非来自可信的服务器,否则必须把工具标注当作不可信的信息。
这条对你的意义是:标注是给协作方的元数据,不是安全边界。 你标了 read_only_hint=True 不会让你的函数变成只读的,真正的只读要靠代码里不写文件。第 11 章会再回到这一点。
5.4 工具数量本身就是成本
最后一个容易被忽略的设计维度:你到底该暴露多少个工具。
直觉上「功能越全越好」,但工具定义是要占上下文的,而且是在对话开始之前就占掉。Anthropic 公布过一组数字:一个典型的五服务器组合(GitHub、Slack、Sentry、Grafana、Splunk),光工具定义就要吃掉约 55K token——用户还没说第一句话。
更麻烦的是准确率。在 Anthropic 的内部 MCP 评测里,引入「按需检索工具」的机制前后,Opus 4 的工具选择准确率从 49% 提升到 74%,Opus 4.5 从 79.5% 提升到 88.1%。反过来读这组数字:工具太多的时候,模型选错工具是常态而不是意外。
所以工具设计指南里那条建议才那么重要:不要把 API 端点一对一包成工具。与其暴露 list_users、list_events、create_event 三个工具让模型自己编排,不如做一个 schedule_event,把「查空档」这一步在工具内部消化掉。指南把「只是包一层现有 API、不考虑 agent 使用体感」列为主要反模式,理由是:对模型来说,上下文不是廉价内存。
落到笔记库上:不要做 list_files、read_file、grep_file 三个工具让模型自己拼。做一个 search_notes 直接返回命中的行,模型一次调用就拿到了它真正想要的东西。
5.5 一张自查表
写完每个工具,用这七行过一遍:
| 检查项 | 不合格的样子 | 合格的样子 |
|---|---|---|
| 名字带领域 | search | search_notes |
| 参数名无歧义 | q、n、id | keyword、limit、note_filename |
| 描述说清「搜什么」 | 「搜索」 | 「在用户的本地 Markdown 笔记库里按关键词搜索」 |
| 描述说清「何时用」 | 缺失 | 「用户提到’我之前记过’这类线索时使用」 |
| 描述说清「返回什么」 | 缺失 | 「返回文件名、行号与该行原文」 |
| 约束进 schema | 代码里 if limit > 50: raise | Field(ge=1, le=50) |
| 只读工具标注了 | 不标,默认被当成破坏性的 | read_only_hint=True |