第 6 章 / 共 10 章
验收标准就是收敛条件
6.1 没有检查,agent 只会停在「看起来做完了」
agent 什么时候停?当它认为工作看起来完成了。 如果没有一个它能自己运行的检查,「看起来完成了」就是唯一可用的信号——于是你变成了那个验证循环:每一个错误都要等你发现。
这句话值得反复读,因为它解释了一个常见现象:为什么 agent 会自信地告诉你「已完成」,而你一跑就报错。它不是在撒谎,它只是没有别的判断依据。
给它一个能产生「通过 / 失败」的东西,循环就自己闭合了:它做事 → 跑检查 → 读结果 → 继续改,直到检查通过。
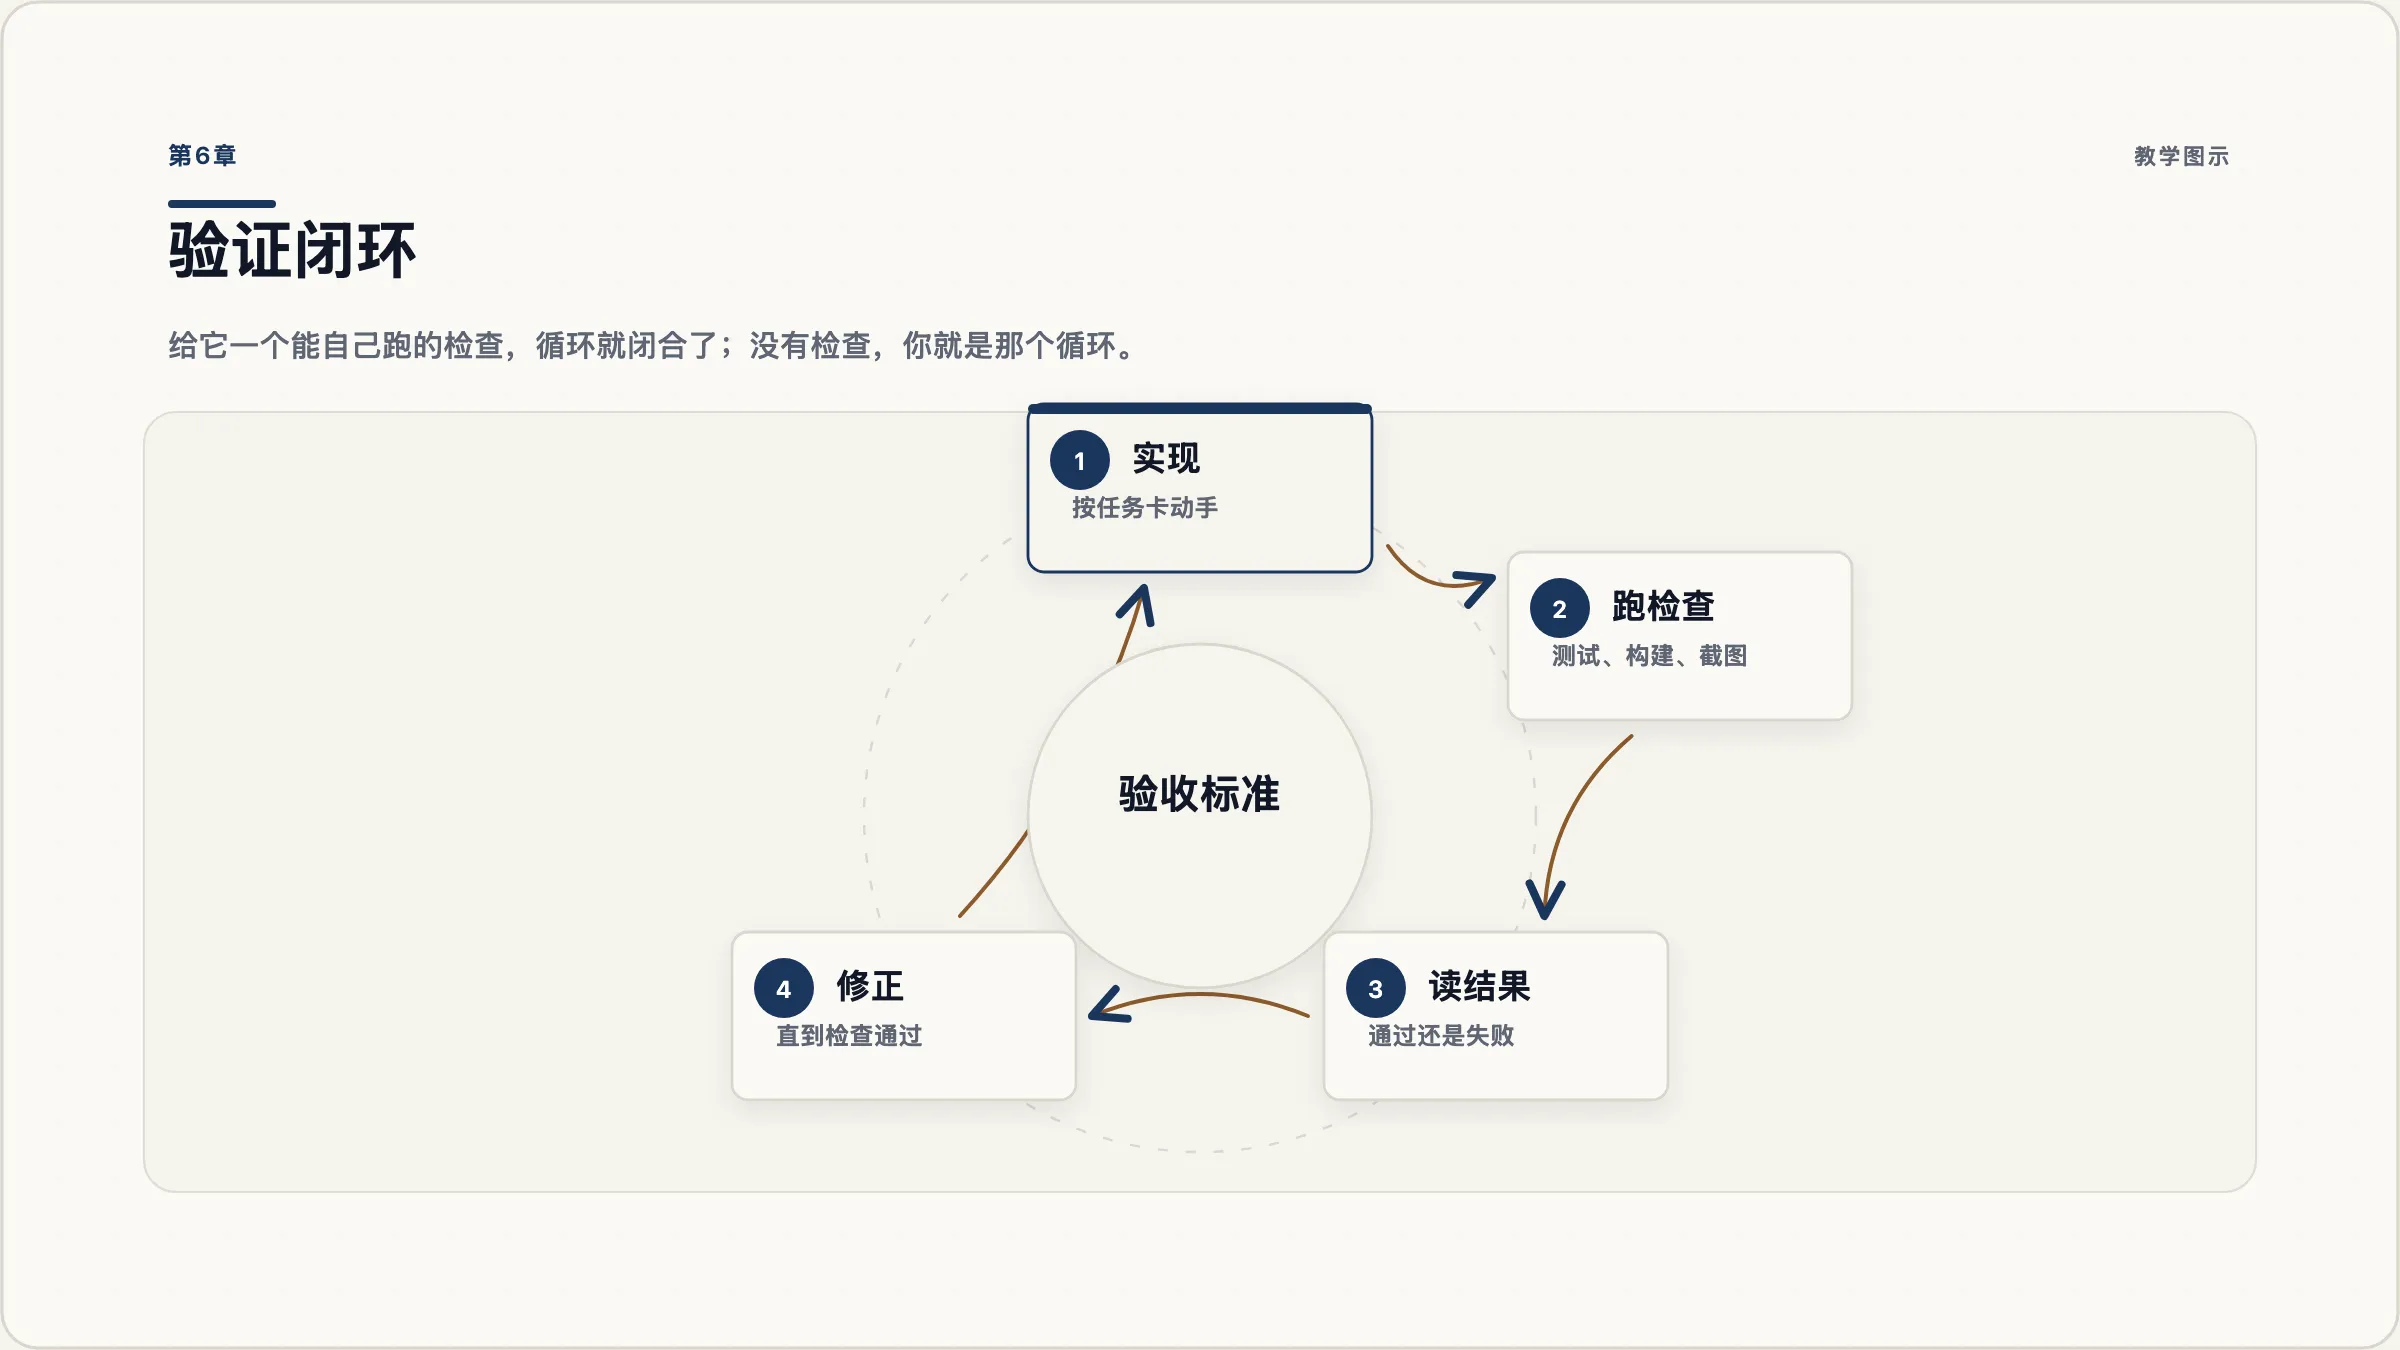
6.2 四种能跑的检查
按设置成本从低到高:
| 检查方式 | 适用场景 | 成本 | 强度 |
|---|---|---|---|
| 在同一条提示里要求「实现后运行测试并修到全绿」 | 任何任务,今天就能用 | 最低 | 靠模型自觉 |
目标条件(如 Claude Code 的 /goal) | 跨多轮的任务 | 低 | 每轮由独立评估器复检 |
| Stop 钩子跑脚本 | 必须零例外的检查 | 中 | 确定性拦截,不通过不许结束回合 |
| 独立子代理复审 | 交付前的最后一道 | 中 | 换一个上下文重新判断 |
最低成本那一档就能解决大部分问题。对比一下同一个任务的两种说法:
| 写法 | 结果 |
|---|---|
| 「实现一个校验邮箱的函数」 | 你来验证 |
| 「实现 validateEmail。示例用例:user@example.com 为真,invalid 为假,user@.com 为假。实现后运行测试」 | 它自己验证 |
| 「让仪表盘好看点」 | 无法验证 |
| 「[附截图] 按这个设计实现。做完截图对比,列出差异并修掉」 | 它自己验证 |
差别只是多写了一句「怎么算对,以及怎么证明」。
6.3 把检查写进规格的位置
回到第2章的五层结构——这一章讲的东西,位置就在第五层「验证方式」。规格里的每一条验收标准,都应该在这一层能找到对应的验证手段:
## 验收标准
1. 当用户点击「导出订阅」按钮时,系统应生成 OPML 文件并触发浏览器下载。
2. 当订阅列表包含分组时,系统应生成对应的嵌套 outline 结构。
3. 若订阅列表为空,则系统应提示「暂无订阅可导出」并且不触发下载。
4. 当订阅标题包含 XML 特殊字符时,系统应对其转义。

## 验证方式
- 标准 2、4:npm test src/lib/opml.test.ts(含分组、含特殊字符两组用例)
- 标准 1、3:手动点击验证;空列表状态下确认无下载发生
- 全部:导出文件用 xmllint --noout 校验可解析对照着看会发现一件事:标准 1 和 3 没有自动化检查。这不是失误,是一次显式的选择——你知道它们靠人工,所以它们会出现在你的最终检查清单里,而不是被误以为已经被测试覆盖了。
6.4 让另一个上下文来挑毛病
最后一道检查是换个脑子。写代码的那个会话见过完整的推理过程,它会倾向于认为自己的选择是合理的;一个只看见 diff 和标准的新上下文不会有这种偏向。
用一个子代理对照 SPEC.md 审查这次的改动。检查:
每一条验收标准是否都已实现,列出的异常路径是否都有测试,
有没有改动范围之外的文件。只报影响正确性或违反规格的问题,
不要报风格偏好。最后那句限定很重要。一个被要求找问题的审查者,通常总能找出一些问题,哪怕工作本身没毛病——这是它被赋予的任务决定的。如果每条都追着改,你会得到多余的抽象层、防御性代码和永远不会发生的边界测试。明确告诉它只报「影响正确性或违反规格」的问题,其余当作可选。