第 1 章 / 共 10 章
为什么 agent 会瞎猜
1.1 一个看起来很对的实现
回到开头那个例子。你的原话是:
给设置页加一个导出功能
在你脑子里,这句话大约携带了这些信息:
- 导出的是订阅列表,不是全部本地数据
- 格式是 OPML,因为要能被别的阅读器导入
- 走浏览器下载,不写本地磁盘
- 订阅为空时应该提示,而不是导出一个空文件
- 只改设置页和一个新的导出模块,别动订阅数据层
在写出去的那句话里,这些信息一条都没有。
agent 拿到的是一个只有目标、没有边界、没有验收标准的任务。它必须做十几个决定,而每个决定它都只能按「最常见的做法」来赌。赌对七成,你就得到一个「看起来很对、就是不是你要的」的实现——这比全错更麻烦,因为你得先读懂它,才能说清哪里不对。
1.2 意图缺口:你说的、你没说的、它猜的
把这件事画出来,就是下面这张图。
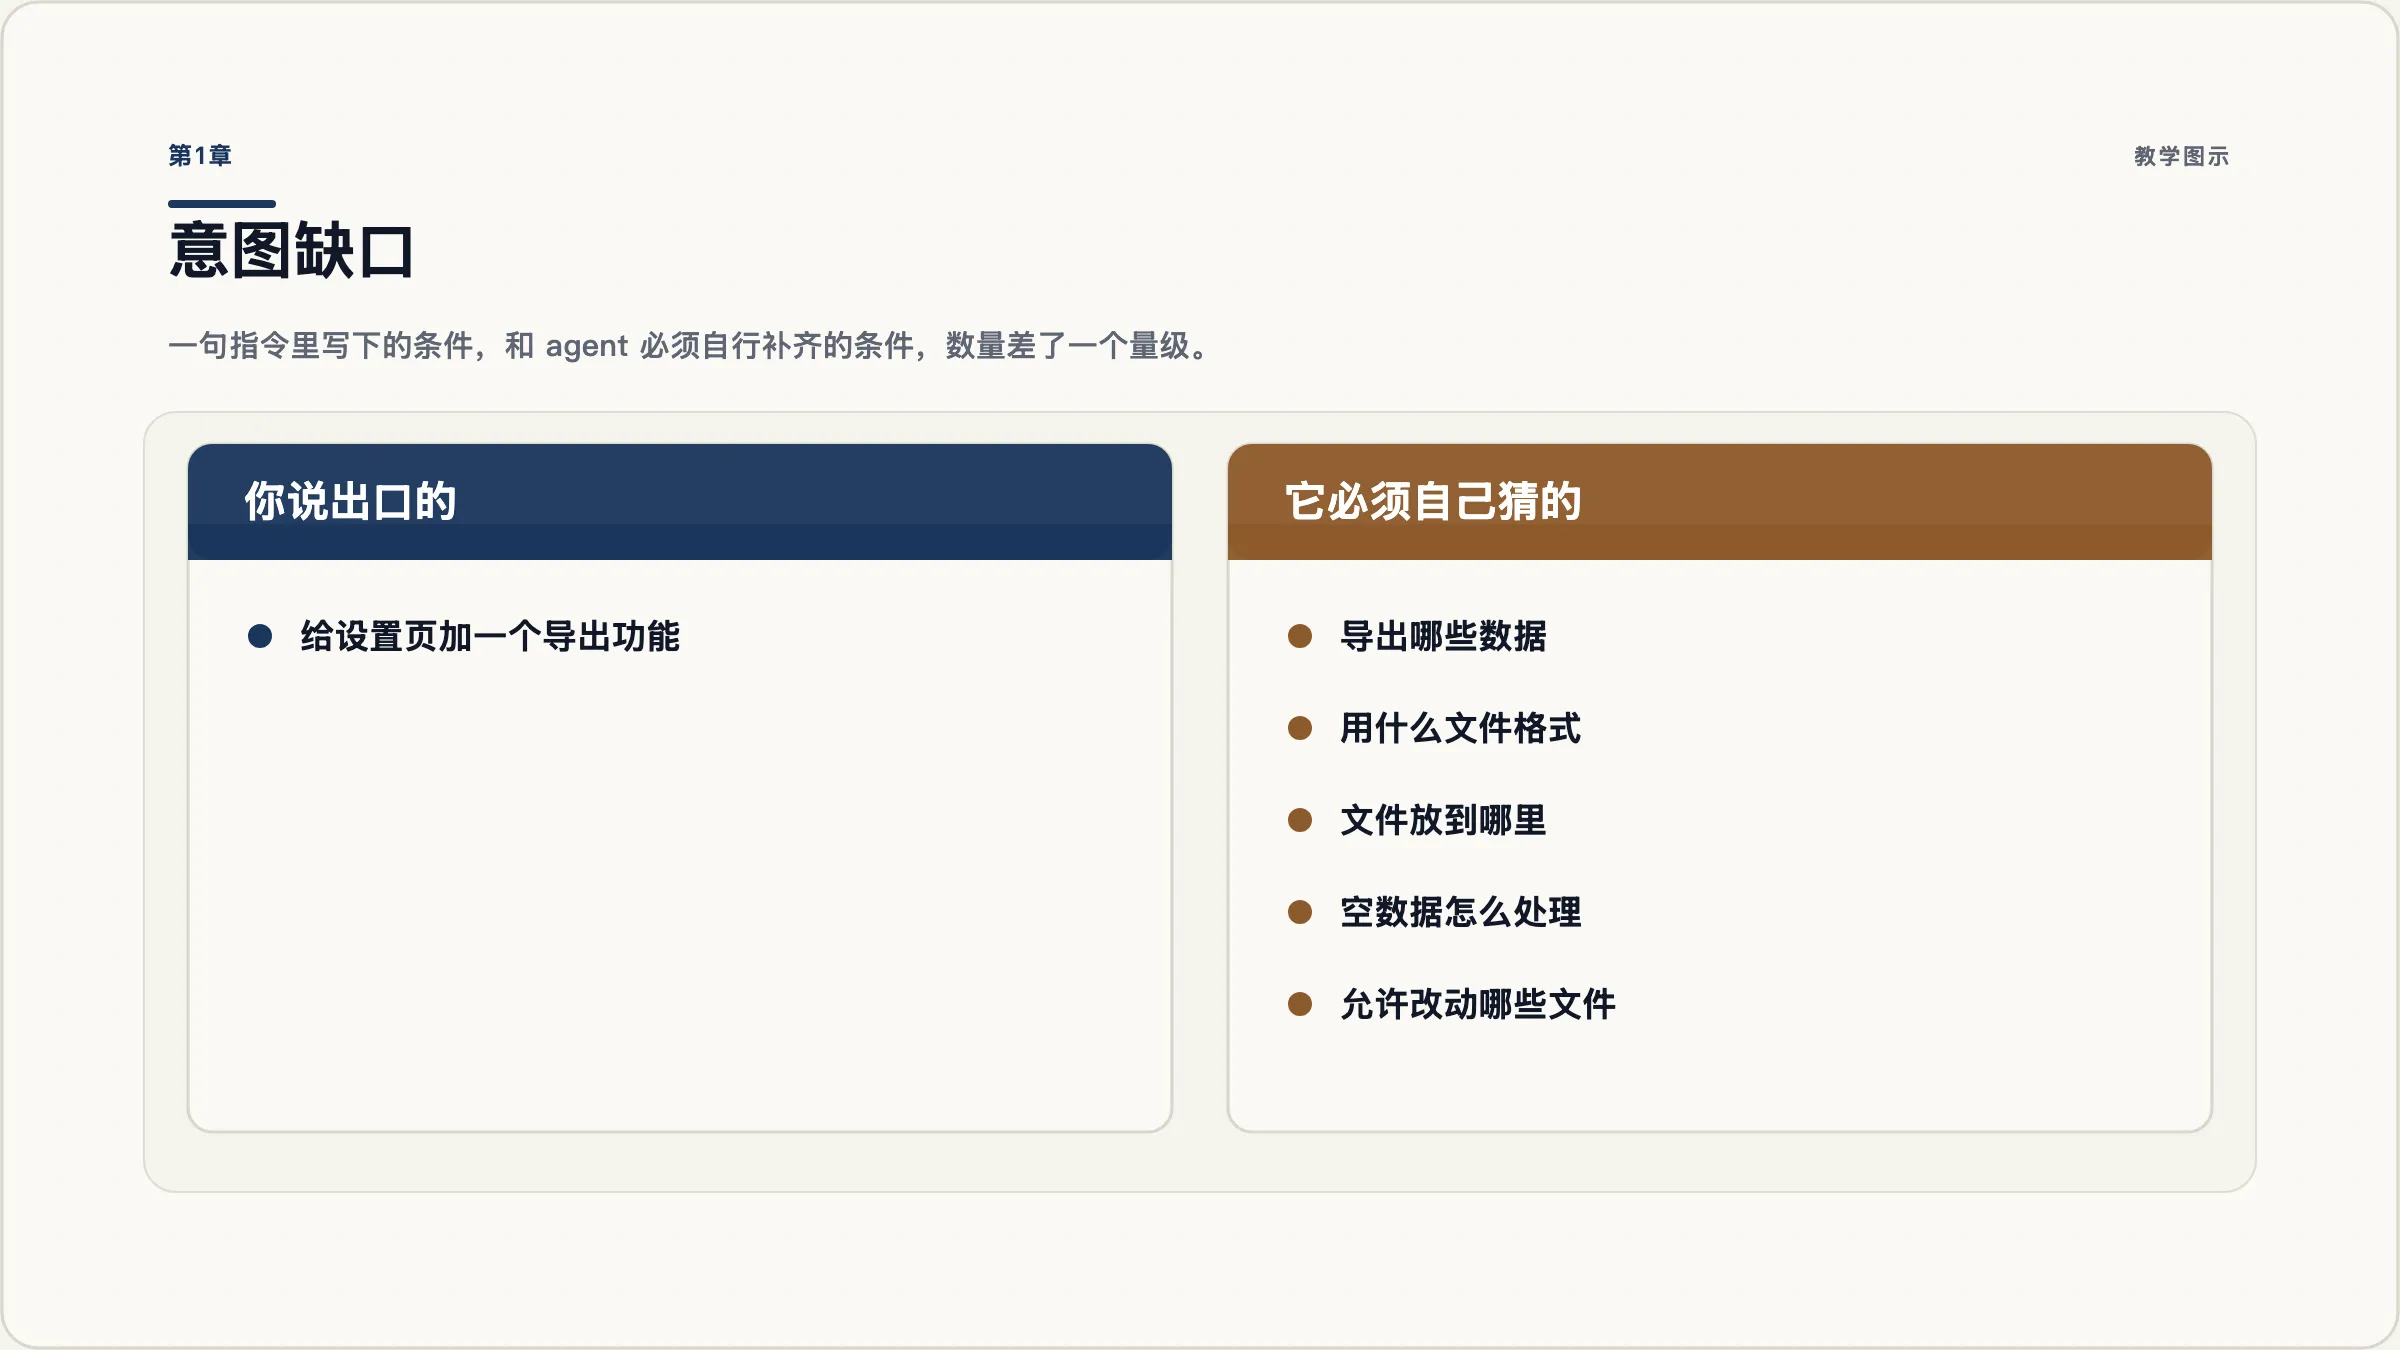
一句自然语言指令天然是有损压缩。你脑子里的完整意图有几十个决策点,说出口的只剩一句话,agent 收到后必须把缺失的部分补齐才能动手。它一定会补齐,区别只在于是你补的,还是它猜的。
这里有一个反直觉的地方:模型能力越强,缺口越危险。弱模型猜错了会写出跑不起来的代码,你一眼就发现;强模型猜错了会写出结构漂亮、测试通过、命名规范的代码,你可能过了两周才发现导出格式一直是错的。
1.3 规模是分水岭
单个函数级别的任务,agent 猜得相当准。「写一个校验邮箱的函数」这种任务,上下文完整、边界清楚、正确答案的分布很窄,猜错的空间本来就小。
规模一上去就不一样了。研究界对这一点的观察是一致的:大模型在函数级代码生成上表现良好,但当任务规模上升到仓库级系统时,输出质量显著下降,原因正是纯自然语言提示存在固有的歧义,而且不可验证——你没有办法机械地检查一段自然语言描述是否被实现完整了。
这给了我们一条实用的判断线:
| 任务规模 | 决策点数量 | 靠一句话够不够 |
|---|---|---|
| 改一个常量、加一行日志 | 接近 0 | 够,写规格纯属浪费 |
| 单个函数或单个组件 | 3-5 个 | 一般够,说清输入输出即可 |
| 跨 2-3 个文件的小功能 | 10 个以上 | 不够,需要至少一份轻规格 |
| 跨模块、动数据结构、影响他人 | 几十个 | 远远不够,需要完整规格与任务拆分 |
第9章会把这张表升级成一个更好用的决策模型。现在先记住结论:规格是按规模和风险付费的,不是每次都付。
1.4 规格驱动开发是什么,不是什么
一句话定义:把「做什么」和「怎么做」分开,先把「做什么」写成可评审、可验收的产物,再让 agent 去做。
这是目前主流工具的共识。GitHub 的 Spec Kit 把自己的核心原则写成「意图驱动开发,规格先定义 what 再定义 how」,并且强调「多步精炼,而不是从提示一次成型」。Claude Code 的官方最佳实践里也有对应的做法:对较大的功能,先让 Claude 采访你,把结果写成一份 SPEC.md,再开新会话去执行。
它不是这些东西:
- 不是把文档写全。 规格的目标是消除猜测,不是覆盖全部细节。写到「不用猜了」就该停。
- 不是先写完整个项目的规格。 一次性规格化整个项目,会造成人类根本处理不完的认知负荷,评审者最终沦为盲签文件的办事员。规格按需求切片走。
- 不是不许改。 规格是活的。第7章整章都在讲怎么改。
- 不是必须用某个工具。 一份
SPEC.md加一份任务清单就能跑起来。工具是把这套动作固化下来,不是前提。