第 6 章 / 共 9 章
一套代码出十条片:数据驱动
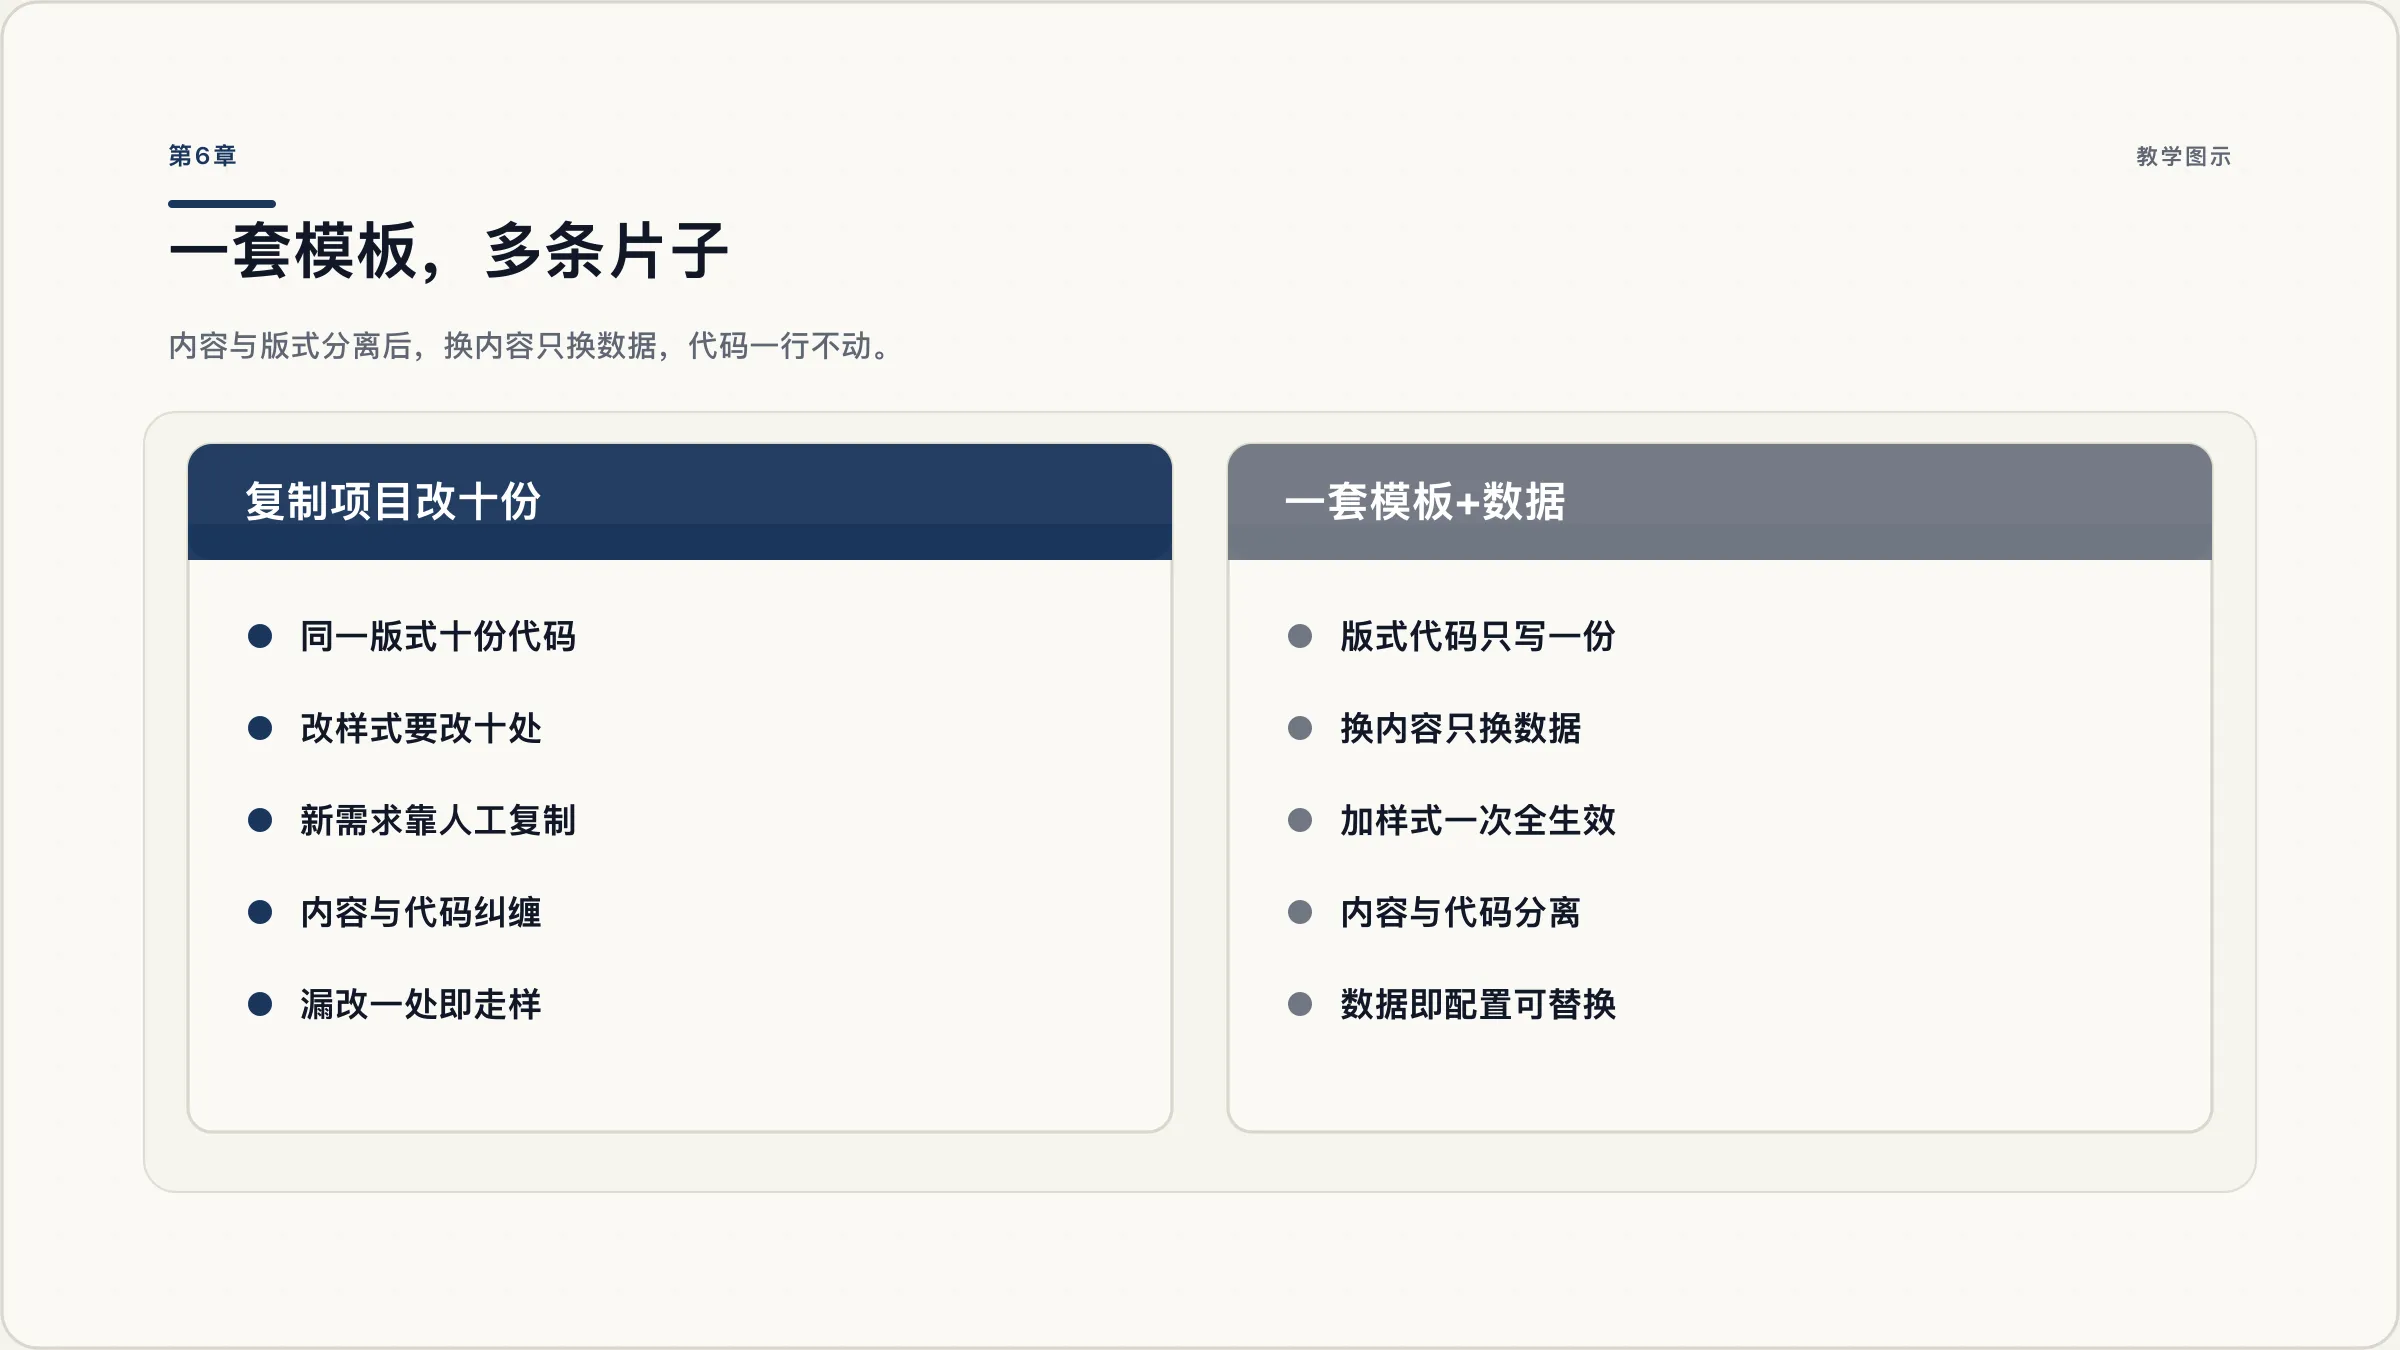
现在你的小片是「写死」的:三条卖点的文案、顺序、时长都躺在组件代码里。下周换内容怎么办?最笨的做法是复制项目改文案——复制十次,你就有了十份几乎相同、但各自微微走样的代码,改一个样式要改十处。本章引入 Remotion 最重要的生产方式:数据驱动(参数化)。内容是数据,版式是代码;数据换,片子就换,代码一行不用动。这也是「为什么用代码做视频」对内容型创作者最大的红利。
6.1 参数化的第一性:内容与版式分离
先想清楚一个区分:一条视频里,哪些是内容,哪些是版式?
- 内容:文案、数值、图片路径、配色里属于某个具体产品的东西;
- 版式:标题多大、卡片怎么排、动画怎么动、每段停几秒。
写死的视频把两者焊在一起;数据驱动的视频把内容抽出来,放到一个结构化的地方——通常是一个数组。每一条内容是一个对象,字段由你自己定义。例如三条卖点:
// src/data.ts —— 内容都放这里,版式组件不关心具体内容
export type Feature = {
  title: string;
  desc: string;
  tag: string;
};

export const features: Feature[] = [
  {title: '高山云雾产区', desc: '海拔 800 米以上的生态茶园', tag: '产地'},
  {title: '轻发酵工艺', desc: '果香清亮,回甘明显', tag: '工艺'},
  {title: '本周四首发', desc: '前 100 名享尝鲜价', tag: '活动'},
];这个文件的价值在于:它是唯一需要你(或 Codex)在换内容时改动的地方。想换成三条新卖点?改数组。想做十条不同产品的片子?准备十个这样的数组。版式组件永远不需要碰。
6.2 用数据数组渲染一条时间线
数据有了,怎么让「每一条内容」自动变成「时间轴上的一个场景」?思路是遍历:用数组的 map 方法,让每条数据渲染一个场景,并按它在数组里的序号自动排布时间。前面第4章学过 Sequence,现在让 Sequence 的 from 也由序号算出来:
// src/Features.tsx —— 版式组件:只负责「怎么排」,不关心「排了谁」
import {Sequence} from 'remotion';
import {features} from './data';

export const Features = () => {
  return (
    <>
      {features.map((item, index) => (
        // 第 index 条:从 index × 120 帧开始,持续 120 帧(4 秒)
        <Sequence key={item.title} from={index * 120} durationInFrames={120}>
          <FeatureCard item={item} />
        </Sequence>
      ))}
    </>
  );
};
FeatureCard 是一个只接收一条 item 的组件:它把 title/desc/tag 显示出来,并做入场动画。因为放进 Sequence 的组件使用「相对帧号」(第4章),所以每条卡片都会从自己出场的那一刻开始做同样的入场动画——三条卡片的表现完全一致,只是出场时间依次错开。这就是数据驱动的美妙之处:动画、版式、节奏都是「一次性写好的模板」,内容只是被喂进去的原料。
6.3 渲染多个版本:一次模板、十种输入
数据驱动最直接的收益是批量出片。同一套代码,内容不同,渲染出的就是不同的视频。操作上你只需要让每次渲染「换一组数据」,做法按项目阶段由简到繁有几种:
- 最简单:把多个数据集都放在
src/data.ts之类的文件里(比如featuresA、featuresB),渲染前让 Codex 把当前使用的那个数组的导出名改一下——版式组件永远不变; - 进阶:把数据作为「输入属性(props)」传给 Composition。Remotion 支持用
defaultProps给 Composition 预设数据,也支持在命令行用 props 传参(具体命令与格式随版本演进,以官方文档的渲染与参数化渲染页面为准)。数据文件与模板代码分离后,你甚至可以让非程序员同事只提供一份 JSON 数据,就能产出成片; - 自动化方向:当内容量再大、需要定时批量渲染时,才需要考虑把渲染放到服务器或云上(Remotion 有 Lambda 等方案)。那属于第9章的进阶地图,不在本章范围。
无论用哪种方式,请守住一条纪律:内容与版式必须分文件/分数据存放,渲染任何一版都只换数据、不动版式。一旦某天你发现「为了换内容不得不改版式代码」,说明数据模型没设计好——这时该让 Codex 重构数据结构,而不是继续打补丁。
6.4 让 Codex 造数据与排版时的三道质检
数据驱动让「内容生成」也可以交给 Codex(比如让它按你的产品资料写出十条卖点数据)。但内容一旦批量,错误也会批量,所以多设几道质检:
- 文案长度质检:卡片版式有固定高度,超长文案会溢出或挤压。让 Codex 生成或修改数据时,明确要求「每条 title 不超过 N 字、desc 不超过 M 字」,并在验收时挑最长的几条看渲染效果;
- 字段完整性质检:数据结构是 TypeScript 类型,字段缺失会在编译时报错——让 Codex 在改数据后运行一次类型检查(项目里通常有 lint 或 tsc 脚本),别让它只靠「目测」;
- 内容真实性质检:AI 生成文案可能编造产地、日期、价格。凡是出现在片子里的商业事实(价格、活动时间、产品参数),必须由你(或你的原始资料)逐条核对,不能让 Codex 自产自销。这是「内容准确」的底线,与代码质量无关。
给 Codex 的指令模板,照此填写即可:
目标:为「山雾乌龙」准备三组不同的卖点数据,做成三个数据集,版式组件不许改。
要求:
1. 每个数据集 3 条,字段结构与现有类型一致(title/desc/tag);
2. 每条 title ≤ 10 字,desc ≤ 22 字,符合现有卡片版式;
3. 涉及价格、日期等事实的字段,用我提供的原文,不得自行编造;
4. 改完运行类型检查,确认无报错,并说明每组数据我会在渲染时如何切换。
6.5 行动:把示例换成你自己的三条内容
版式和内容分离后,你的片子还缺三样「质感」的东西:图片、好字体和声音。下一章把它们加进去——顺便学会避开素材版权这个最常见的坑。